
Zu wenig Daten für ML? Bauen Sie für die Zukunft
Von Sergii Shelpuk,Geschäftsführender Partner bei Shelpuk & Company
Fehlende Daten und Probleme mit der Datenqualität gehörten mindestens sieben Jahre lang, von 2015 bis 2022, zu den drei größten Bedenken von CEOs bei der Einführung von KI und Machine Learning. Dennoch sind aktuell verfügbare Daten, obwohl nützlich für das KI-Produktdesign, keine zwingende Voraussetzung für den Aufbau eines KI-Unternehmens, und ihr Fehlen oder ihre Unvollkommenheit sind kein Hinderungsgrund für die Entwicklung von Deep-Learning-Produkten. Entscheidend ist das, was ich „Future Data" nenne.
Vor einiger Zeit bat mich Vasyl Rakivnenko, Gründer des Startups Alko Prevent, bei der Gestaltung der KI-Strategie seines Unternehmens zu helfen. Alko Prevent unterstützt Transportunternehmen dabei, die Nüchternheit ihrer Fahrer sicherzustellen, indem es mithilfe von Computer Vision und Machine Learning nach Anzeichen von Trunkenheit sucht. Als engagierter und visionärer Gründer bezog Vasyl mich in die Planung der KI-Aktivitäten des Unternehmens und die Koordination mit dem Entwicklungsteam ein.
Das Entwicklungsteam arbeitete an der ersten Produktversion und dem Machine-Learning-System. Das Modell musste nüchterne und alkoholisierte Gesichter mit einem Schwerpunkt auf Qualität erkennen – das System war für die Kunden erst ab einem bestimmten Genauigkeitsniveau sinnvoll.
Wie so oft war der Datensatz der anspruchsvollste Teil der F&E-Arbeit. Das Team schlug vor, einen auf einem tiefen neuronalen Netz basierenden Klassifikator zu verwenden, um alle Gesichter in nüchtern und alkoholisiert einzuteilen. Diese Lösung erforderte einen großen und ausgewogenen Datensatz, in dem der Anteil nüchterner und alkoholisierter Gesichter ungefähr gleich wäre. Da keine gebrauchsfertigen Trainingsdaten vorhanden waren, plante das Team, Google nach Gesichtsbildern zu durchsuchen und diese dann manuell anhand sichtbarer Merkmale in nüchterne und alkoholisierte Klassen einzuordnen.
Meine Perspektive war eine andere. Vasyl wollte ein KI-Unternehmen aufbauen, was bedeutete, dass Machine Learning den Kern seines Wettbewerbsvorteils bilden sollte.
Wenn Alko Prevent wächst, wird das Unternehmen immer mehr Daten sammeln – Fahrer-Selfies, von denen die große Mehrheit nüchterne Gesichter zeigen wird (alles um uns herum deutet darauf hin, dass LKW-Fahrer die meiste Zeit nüchtern sind). Die vom Unternehmen gesammelten proprietären Daten werden daher erstens sehr unausgewogen sein und hauptsächlich nüchterne Gesichter enthalten, und zweitens nicht annotiert. Obwohl tiefe neuronale Netze, die mit gelabelten Datensätzen überwacht trainiert werden, tatsächlich den Stand der Technik in der Bildklassifizierung darstellen, werden sie von den zukünftigen Daten von Alko Prevent nicht profitieren können. Ein Deep-Learning-Klassifikator mag für das MVP ausreichen, aber das Unternehmen wird die Ergebnisse der teuren KI-F&E wahrscheinlich irgendwann verwerfen müssen. Darüber hinaus schafft er keinen Wettbewerbsvorteil: Jeder kann Google-Bilder durchsuchen und ein ähnlich leistungsfähiges Machine-Learning-Produkt entwickeln.
Das Team von Alko Prevent schlug den Bau eines KI-Features vor, aber nicht den Aufbau eines KI-Wettbewerbsvorteils. KI-Features allein machen noch kein KI-Unternehmen.
KI-Produkte werden mit neuen Daten besser und erzeugen so einen starken Netzwerkeffekt, der nahezu unmöglich zu durchbrechen ist. Betrachten wir Google. Digitale Werbung ist ein enormer 600-Milliarden-Dollar-Markt. Auch ist es mit den heutigen Cloud-Technologien und Rechengeschwindigkeiten deutlich einfacher, eine Suchmaschine zu bauen als 1998. Man würde erwarten, dass ein solcher Markt umkämpft ist, dennoch dominieren ihn wenige Giganten. Der Grund ist, dass Google und andere Internetunternehmen ihre Daten mithilfe von KI in einen nahezu unüberwindbaren Wettbewerbsvorteil verwandelt haben. Google kennt Ihre gesamte Suchhistorie, Ihre Klicks auf Suchergebnisse, Ihre Gmail-E-Mails und Antworten, Ihre YouTube-Such- und Wiedergabeverläufe und unendlich mehr. Ihre Algorithmen passen sich automatisch an jeden Nutzer an und werden so mit der Zeit immer besser. Selbst wenn sich jemand die gesamte Google-Codebasis Zeile für Zeile auf eigene Cloud-Server kopieren würde, könnte diese Person nicht mit Google konkurrieren – weil die gesamten historischen Daten fehlen.
Um Googles Weg zu folgen, sollte Alko Prevent ein Produkt entwickeln, das sich mit der Zeit verbessert und die proprietären Daten des Unternehmens in einen Wettbewerbsvorteil verwandelt. Die zukünftigen Daten werden ein stark unausgewogener Satz von Selfies sein. Dennoch wird eine Struktur darin erkennbar sein: Wir erwarten, dass jeder Nutzer ähnliche Fotos in ungefähr ähnlichen Umgebungen aufnimmt – ein Gesichtsfoto aus kurzer Distanz mit derselben Kamera. Aus dieser Perspektive lässt sich das Problem anders formulieren: Ausgehend von einem Datensatz von Selfies derselben Person, warne das Transportunternehmen, wenn der Fahrer heute deutlich anders aussieht als gewöhnlich.
Dieser Logik folgend schlug ich vor, anstelle der Klassifizierung Deep-Learning-Anomalieerkennung einzusetzen. Anomalieerkennung funktioniert nicht nur mit stark unausgewogenen und nicht annotierten Datensätzen, sondern erkennt auch alle möglichen Anomalien, die nicht auf bestimmte Arten von Rauschzuständen wie Alkohol beschränkt sind. Außerdem verbessert sich das Machine-Learning-Produkt mit mehr Daten und verwandelt das Angebot von Alko Prevent letztlich in ein verteidigungsfähiges Geschäft.
Fehlende Daten oder Probleme mit der Datenqualität können anfangs tatsächlich ein Problem darstellen, aber es lässt sich mit der Future Data lösen. Sie müssen Ihr Produkt und Ihre User Journeys so gestalten, dass sie die für Ihren KI-Kreislauf benötigten Daten sammeln. Idealerweise können Ihre Nutzer die Journey nicht abschließen, ohne Ihnen ein für Ihre Machine-Learning-Features nützliches Datenstück zu liefern.
Ein KI-Unternehmen umfasst folgenden Kreislauf:
- Ein einfaches Machine-Learning-Modell bauen;
- einige wenige Kunden überzeugen, es zu nutzen;
- deren Daten erhalten;
- das Machine-Learning-Modell neu trainieren;
- mit dem verbesserten Modell weitere Kunden überzeugen;
- wiederholen.
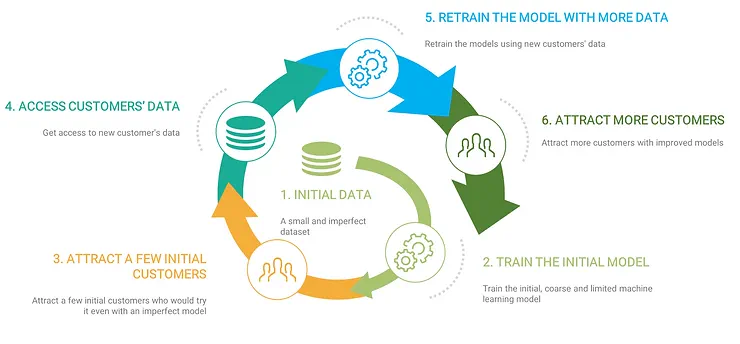
Richtig aufgebaut, führt der KI-Wettbewerbsvorteil dazu, dass sich Konkurrenten mit folgendem Dilemma konfrontiert sehen:
- Um mit Ihrem Unternehmen zu konkurrieren, muss ich ein besseres Produkt als Ihres bauen.
- Um ein besseres Produkt als Ihres zu bauen, brauche ich bessere Machine-Learning-Modelle als Ihre.
- Um bessere Modelle als Ihre zu trainieren, brauche ich mehr Daten als Sie besitzen.
- Um mehr Daten als Sie zu bekommen, brauche ich mehr Kunden als Sie.
- Um mehr Kunden als Sie zu bekommen, brauche ich ein besseres Produkt als Ihres. Ein unmöglicher Kreislauf.
Die KI-Strategie sollte zudem eng mit der Produkt- und Geschäftsstrategie verzahnt sein – bei KI-Unternehmen funktioniert keine der drei ohne die anderen. Den richtigen Ansatzpunkt zu identifizieren und funktionsübergreifende Anstrengungen auf das Erzielen von Ergebnissen zu konzentrieren, ist entscheidend. Die richtige KI-Strategie zu entwickeln ist eine komplexe Aufgabe, die in einem einfachen Ergebnis münden muss.
Eine gute KI-Strategie ist klar, leicht verständlich, kommunizierbar, umsetzbar und in jeder Phase der Produkt- und Geschäftsentwicklung messbar. Ein dickes, schwer verständliches Foliendeck, das vor nichtssagenden Schlagworten nur so strotzt, sollte ein Warnsignal sein – es bedeutet oft, dass in Wirklichkeit gar keine KI-Strategie vorhanden ist.
Wenn Sie Hilfe beim Aufbau eines KI-Wettbewerbsvorteils für Ihr Unternehmen benötigen, sind Sie bei uns genau richtig. Unser Team aus Geschäftsexperten und KI-Technologieberatern verfügt über jahrelange Erfahrung darin, Technologieunternehmen wie Ihrem dabei zu helfen, nachhaltige Wettbewerbsvorteile durch KI-Technologie aufzubauen. Von der Datenerfassung bis zur Algorithmenentwicklung können wir Ihnen helfen, der Konkurrenz voraus zu sein und Ihren Marktanteil für die kommenden Jahre zu sichern.
Noch keine Daten? Das ist kein Problem — es ist eine Chance.
Lassen Sie uns herausfinden, wo Ihr Produkt beginnen kann, die Daten zu sammeln, die zu Ihrem stärksten Wettbewerbsvorteil werden.