
Low-Rank Adaptation (LoRA) für effiziente LLMs
In der sich rasant entwickelnden Welt der künstlichen Intelligenz ist die effiziente Anpassung großer Sprachmodelle an neue Aufgaben oder Datensätze von entscheidender Bedeutung. Dieser Blogbeitrag soll Low-Rank Adaptation (LoRA) entmystifizieren – eine hochmoderne Technik zum Fine-Tuning großer Sprachmodelle wie Llama-2, Llama-3 und Mistral. Am Ende dieses Artikels werden Sie verstehen, was LoRA ist, wie es funktioniert und warum es zu einem unverzichtbaren Werkzeug für KI-Praktiker wird.
Warum LoRA wichtig ist
Traditionelles Fine-Tuning großer Modelle kann sowohl zeitaufwändig als auch kostspielig sein und erfordert oft erhebliche Rechenressourcen. LoRA führt einen neuartigen Ansatz ein, der diese Probleme mildert, indem die Anzahl der trainierbaren Parameter durch Low-Rank-Matrixzerlegung reduziert wird. Diese Methode beschleunigt nicht nur den Trainingsprozess, sondern spart auch Speicher, was den Einsatz dieser Modelle in verschiedenen praktischen Anwendungen praktikabler macht.
LoRA ist besonders vorteilhaft in Szenarien, in denen Modelle häufig aktualisiert oder an neue Aufgaben angepasst werden müssen, ohne über umfangreiche Rechenleistung zu verfügen. Durch die Vereinfachung des Anpassungsprozesses ermöglicht LoRA mehr Organisationen, die Leistungsfähigkeit großer Sprachmodelle zu nutzen und den Zugang zu fortschrittlichen KI-Fähigkeiten zu demokratisieren.
In den folgenden Abschnitten werden wir tiefer in die Mechanik von LoRA eintauchen, seine praktischen Anwendungen erkunden und einige Fallstudien aus der Praxis vorstellen, die seine Wirksamkeit demonstrieren. Ob Sie KI-Forscher, Data Scientist oder Machine-Learning-Ingenieur sind – das Verständnis von LoRA kann Ihre Fähigkeit, effektiv mit großen Sprachmodellen zu arbeiten, erheblich verbessern.
Was ist LoRA?
LoRA ist eine innovative Technik, die darauf abzielt, die Anzahl der trainierbaren Parameter in großen Sprachmodellen zu reduzieren. Durch diese Reduktion macht LoRA den Fine-Tuning-Prozess schneller und effizienter, ohne die Leistung des Modells zu beeinträchtigen. Diese Methode nutzt mathematische Prinzipien, um die Anpassung großer Modelle an neue Aufgaben oder Datensätze zu vereinfachen und zu beschleunigen.
Schlüsselkonzepte:
- Low-Rank-Zerlegung: Im Kern von LoRA steht das Konzept der Low-Rank-Zerlegung. Dabei werden große Matrizen in kleinere, besser handhabbare Stücke zerlegt. Dadurch können wir uns auf die kritischsten Teile der Daten konzentrieren und den Trainingsprozess effizienter gestalten. Die Low-Rank-Zerlegung hilft dabei, die einflussreichsten Parameter zu identifizieren und zu isolieren, die während des Fine-Tunings angepasst werden müssen.
- Matrixrang: Der Rang einer Matrix ist ein Maß für ihre Komplexität, bestimmt durch die Anzahl linear unabhängiger Zeilen oder Spalten. Im Kontext von LoRA streben wir danach, Matrizen mit niedrigerem Rang zu verwenden, um Änderungen in den Gewichten des Modells darzustellen. Dieser Ansatz reduziert die Rechenlast erheblich, da Matrizen mit niedrigerem Rang einfacher sind und weniger Ressourcen zur Verarbeitung benötigen.
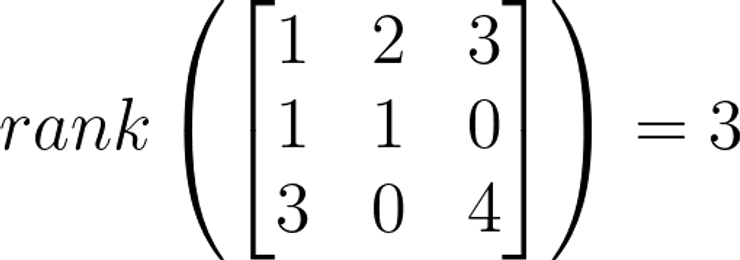
Vollrang-Matrix (von ML6)
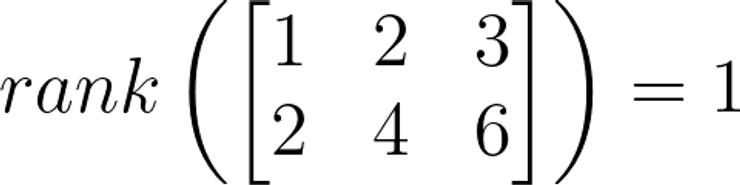
Rangdefiziente Matrix (von ML6)
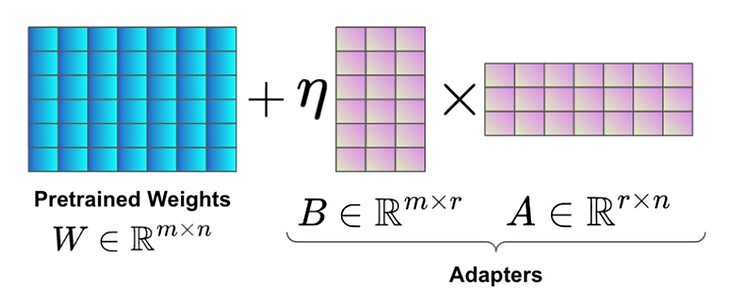
Gewichtsreparametrisierung mit LoRA-Adaptern (von Wang et al.)
Vorteile:
- Schnellere Trainingszeiten: Durch die Reduktion der Anzahl trainierbarer Parameter beschleunigt LoRA den Trainingsprozess. Dies ist besonders vorteilhaft bei der Arbeit mit großen Datensätzen oder wenn schnelle Modellaktualisierungen erforderlich sind.
- Reduzierter Speicherverbrauch: Die Effizienz von LoRA erstreckt sich auch auf den Speicherverbrauch. Kleinere Parametersätze erfordern weniger Speicher, wodurch es möglich wird, große Modelle auf Hardware mit bescheideneren Spezifikationen zu trainieren und zu verfeinern.
- Einfachere Modellspeicherung und -freigabe: Mit LoRA feinabgestimmte Modelle haben kleinere Gewichtsdateien, was ihre Speicherung und Weitergabe erleichtert. Dies ist besonders nützlich für kollaborative Projekte oder beim Bereitstellen von Modellen auf verschiedenen Plattformen.
Wie LoRA funktioniert
Bei der Anpassung großer Modelle mit LoRA aktualisieren wir die Gewichtsmatrizen mithilfe von Low-Rank-Matrizen. Anstatt die gesamte Gewichtsmatrix direkt zu modifizieren, führt LoRA zwei kleinere Matrizen ein, die miteinander multipliziert die erforderlichen Änderungen in der ursprünglichen Matrix approximieren. Diese Methode vereinfacht nicht nur die Berechnungen, sondern bewahrt auch die wesentlichen Merkmale des Modells, während es an neue Aufgaben oder Datensätze angepasst wird.
Schlüsselparameter:
- rank: Definiert die innere Dimension der Low-Rank-Matrizen. Ein höherer Rang bedeutet mehr trainierbare Parameter.
- lora_alpha: Ein Skalierungsfaktor für die Low-Rank-Matrizen. Er passt den Einfluss der Low-Rank-Anpassung auf das Gesamtmodell an.
- target_modules: Gibt an, welche Teile des Modells LoRA verwenden. Dies ermöglicht gezieltes Fine-Tuning und hilft, unnötige Berechnungen zu reduzieren.
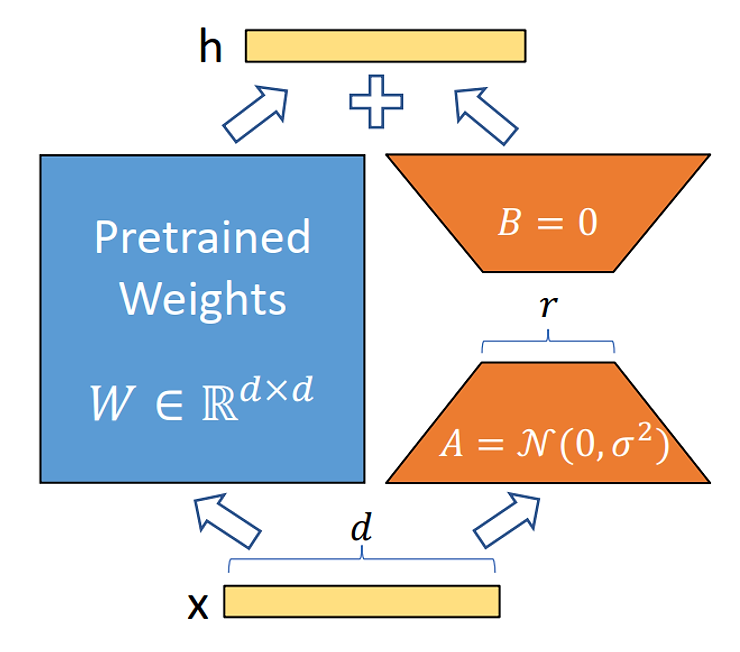
LoRA-Reparametrisierung. Beim Fine-Tuning von LLMs trainieren wir nur die Matrizen A und B (von Hu et al.)
Herausforderungen und Überlegungen
Obwohl LoRA zahlreiche Vorteile für das Fine-Tuning großer Sprachmodelle bietet, bringt es auch eigene Herausforderungen mit sich. Das Verständnis dieser Herausforderungen und wie man sie adressiert, ist entscheidend für eine effektive Implementierung von LoRA.
Overfitting und Underfitting:
Eine der Hauptherausforderungen bei der Verwendung von LoRA ist das Finden der richtigen Balance in der Komplexität der Low-Rank-Matrizen. Sind die Matrizen zu einfach, kann das Modell underfitting zeigen und wesentliche Informationen und Nuancen in den Daten nicht erfassen. Umgekehrt kann das Modell bei zu komplexen Matrizen overfitting zeigen und Rauschen zusammen mit den relevanten Daten erfassen. Die richtige Balance stellt sicher, dass das Modell gut auf neue, ungesehene Daten generalisiert.
Datenheterogenität:
Eine weitere bedeutende Herausforderung ist der Umgang mit Datenheterogenität. Dieses Problem tritt auf, wenn es einen erheblichen Unterschied zwischen der Quelldomäne (in der das Modell ursprünglich trainiert wurde) und der Zieldomäne (in der das Modell angepasst wird) gibt. Solche Unterschiede können die Fähigkeit des Modells, Wissen effektiv zu übertragen, behindern.
Datenverfügbarkeit:
Schließlich ist die Datenverfügbarkeit eine kritische Überlegung. In vielen Fällen kann die Beschaffung gelabelter Daten in der Zieldomäne herausfordernd und kostspielig sein. Diese Einschränkung kann den Fine-Tuning-Prozess behindern, da LoRA, wie andere Machine-Learning-Techniken, im Allgemeinen eine erhebliche Menge an Daten benötigt, um robuste Modelle zu erstellen. Die Erforschung semi-überwachter Ansätze, bei denen das Modell auf einer Kombination von gelabelten und nicht annotierten Daten trainiert wird, kann helfen, dieses Problem zu mindern.
Zukunftsaussichten und Forschung
Während LoRA in der KI-Community weiter an Bedeutung gewinnt, gibt es mehrere spannende Wege für zukünftige Forschung und Entwicklung.
Fortschritte in LoRA-Techniken:
Einer der primären Forschungsbereiche umfasst die Erforschung neuer Methoden zur weiteren Reduzierung der Anzahl trainierbarer Parameter. Obwohl LoRA die Rechenlast bereits erheblich verringert, gibt es laufende Forschung, um diese Grenzen noch weiter zu verschieben. Innovationen in Matrixfaktorisierungstechniken und Optimierungsalgorithmen könnten zu noch kompakteren Modellen führen, ohne die Leistung zu beeinträchtigen.
Integration mit anderen Technologien:
Eine weitere vielversprechende Richtung für zukünftige Forschung ist die Integration von LoRA mit anderen fortschrittlichen KI-Technologien. Zum Beispiel kann die Kombination von LoRA mit Techniken wie DreamBooth die Modellanpassung verbessern und personalisiertere und effizientere Fine-Tuning-Prozesse ermöglichen.
Die Zukunft von LoRA ist vielversprechend, und laufende Forschung wird seine Fähigkeiten und Anwendungen weiter ausbauen. Während sich diese Fortschritte entfalten, wird LoRA weiterhin eine zentrale Rolle in der Evolution der KI spielen und eine effizientere und vielseitigere Modellanpassung über verschiedene Domänen ermöglichen.
Weiterlesen
- LLM Practitioner’s Guide: Gemma – ein bahnbrechend mehrsprachiges LLM
- Wie mehrsprachig ist Llama-2 wirklich?
- Der Tango braucht zwei: Synergien zwischen KI und Produktmanagement aufbauen
Möchten Sie ein LLM für Ihren Anwendungsfall fine-tunen?
Lassen Sie uns den richtigen Fine-Tuning-Ansatz bestimmen — von der LoRA-Konfiguration bis zur Datenstrategie — für Ihre spezifischen Anforderungen.