
LLM Practitioner’s Guide: Gemma, mehrsprachig
LLM Practitioner’s Guide:
- Wie mehrsprachig ist Llama-2 wirklich?
- Wie mehrsprachig sind Falcon, Mistral, Smaug und andere LLMs?
- Gemma – ein bahnbrechend mehrsprachiges LLM
Am 21. Februar 2024 hat Google sein neues Open-Access Large Language Model (LLM) Gemma vorgestellt. Diese Veröffentlichung ist ein bedeutender Meilenstein – weit wichtiger, als es auf den ersten Blick scheinen mag.
Seit ChatGPT die Bühne betreten hat, erlebt der Bereich der Open-Access-LLMs ein explosives Wachstum. Von Anfang an waren wir intensiv am Training und an der Anpassung offener Chat-LLMs beteiligt. Trotz der allgemeinen Begeisterung waren sich diejenigen von uns, die mit mehrsprachigen Modellen arbeiten, eines kritischen Problems bewusst: Für Sprachen außerhalb der romanischen und germanischen Sprachfamilien haben ineffiziente Tokenizer die Leistung von Open-Access-LLMs stark eingeschränkt.
Was ist ein Tokenizer? Es ist ein Algorithmus, der Text in kleinere Einheiten – sogenannte Tokens – zerlegt. Diese können Wörter, Wortteile, einzelne Zeichen oder andere Einheiten sein, je nach Design des Tokenizers. Die Tokenisierung ist ein entscheidender Schritt bei der Textverarbeitung für LLMs und ermöglicht Anwendungen wie Textklassifikation, Frage-Antwort-Systeme und maschinelle Übersetzung.
Tokenizer sind ein wesentlicher Bestandteil der NLP-Pipeline und dienen einem einzigen Ziel: Text in ein Format umzuwandeln, das das Modell verstehen kann. Da Modelle mit numerischen Daten arbeiten, wandeln Tokenizer unsere Texteingaben in Zahlen um.
Ein einfacher Ansatz weist jedem Buchstaben eine eindeutige Zahl zu. Zum Beispiel könnte „a“ die Zahl 1 erhalten, „b“ die Zahl 2 usw. Das Modell versucht dann, die nächste Zahl in einer Sequenz vorherzusagen. Diese Methode kann jedoch selbst einen kurzen Satz in eine lange Zahlensequenz verwandeln. Ein einziger Fehler bei der Vorhersage eines Buchstabens kann alle nachfolgenden Vorhersagen verfälschen.
Eine alternative Strategie weist jedem Wort eine eindeutige Zahl zu. Dies reduziert die Sequenzlänge erheblich, bringt aber eigene Herausforderungen mit sich. Mit über 200.000 Wörtern allein im Englischen müsste ein mehrsprachiges Modell unter Millionen von Zahlen unterscheiden, was die Fehlerwahrscheinlichkeit deutlich erhöht.
Um diese Herausforderungen zu bewältigen, haben Forscher die Tokenisierung entwickelt. Sie zerlegt Wörter in kleinere, häufig vorkommende Stücke (Tokens). Zum Beispiel könnte „predicting“ in „pred“, „ict“ und „ing“ aufgeteilt werden. Dadurch werden die Auswahlmöglichkeiten des Modells dramatisch reduziert – von einem ganzen Wörterbuch auf etwa 2.000 Tokens für die englische Sprache.
Allerdings gibt es ein erhebliches Problem: Alle bekannten Open-Access-Chat-LLMs wie Llama, Llama-2, Mistral, Mixtral, Falcon, Smaug und andere verfügen über Tokenizer, die hauptsächlich für romanische und germanische Sprachen optimiert sind. Für nicht-germanische, nicht-romanische und nicht-slawische Sprachen wie Griechisch, Chinesisch, Hebräisch, Arabisch, Hindi, Koreanisch, Japanisch usw. werden diese Sprachen auf Zeichenebene reduziert.
Während man die Leistung eines Modells durch mehr oder qualitativ hochwertigere Trainingsdaten verbessern kann, stellt der Tokenizer eine Herausforderung dar, die nicht auf ähnliche Weise gelöst werden kann. Der Tokenizer arbeitet auf Basis eines deterministischen Algorithmus, nicht durch maschinelles Lernen. Man kann ihn weder trainieren noch modifizieren. Das Modell ist untrennbar mit seinem Tokenizer verbunden; ein Austausch würde das Modell funktionsunfähig machen.
Es gab zwar Modelle mit effektiven mehrsprachigen Tokenizern, wie Googles mt5 von 2020. Diese waren jedoch „Base“-Modelle und nicht speziell für konversationelle Aufgaben trainiert.
Diese Situation hat die praktischen Anwendungen von LLMs effektiv auf romanische und germanische Sprachen beschränkt. Für ein hochwertiges konversationelles LLM hatte man zwei Möglichkeiten:
- Moderne LLMs wie Llama-2 oder Mistral auf eine Weise feintunen, die an 2015 erinnert – mit zeichenbasierter Textdarstellung.
- Mit einem Base-Modell beginnen, das über einen robusten Tokenizer verfügt, und es für Konversation trainieren.
Beide Optionen erfordern umfangreiche und hochpräzise Datensätze. Für die meisten Sprachen und Unternehmen machte dies das Feintuning moderner mehrsprachiger konversationeller LLMs praktisch unerreichbar.
Bis jetzt.
Gemma
Gemma repräsentiert eine neue Generation leichtgewichtiger, modernster Open-Access-Modelle, die auf der Forschung und Technologie hinter den Gemini-Modellen aufbauen. Entwickelt von Google DeepMind und verschiedenen Google-Teams, leitet sich der Name Gemma vom lateinischen Wort „gemma“ („Edelstein“) ab.
Das Müssen Sie wissen:
- Google hat die Gemma-Modellgewichte in zwei Versionen veröffentlicht: Gemma 2B und Gemma 7B. Jede Version ist in vorab trainierten und instruktionsabgestimmten Varianten verfügbar.
- Das neue Responsible Generative AI Toolkit bietet Anleitungen und wichtige Werkzeuge für die Entwicklung sichererer KI-Anwendungen mit Gemma.
- Google unterstützt Toolchains für Inferenz und Supervised Fine-Tuning (SFT) in allen wichtigen Frameworks, darunter JAX, PyTorch und TensorFlow (nativ in Keras 3.0).
- Für eine einfache Einführung stehen Colab- und Kaggle-Notebooks sowie Integrationen mit Hugging Face, MaxText, NVIDIA NeMo und TensorRT-LLM zur Verfügung.
- Die Gemma-Modelle laufen auf verschiedenen Plattformen – vom Laptop bis zu Google Cloud – mit einfachen Bereitstellungsoptionen auf Vertex AI und Google Kubernetes Engine.
- Die Nutzungsbedingungen erlauben eine verantwortungsvolle kommerzielle Nutzung und Verbreitung durch Organisationen jeder Größe.
Wir haben zuvor mt5 hervorgehoben, Googles LLM von 2020 mit einem außergewöhnlichen mehrsprachigen Tokenizer. Jetzt kommt Gemma: ausgestattet mit einem noch fortschrittlicheren Tokenizer. In unserer jüngsten Analyse haben wir die Tokenizer der wichtigsten LLMs in verschiedenen Sprachen getestet. So schneidet Gemmas Tokenizer im Vergleich ab:
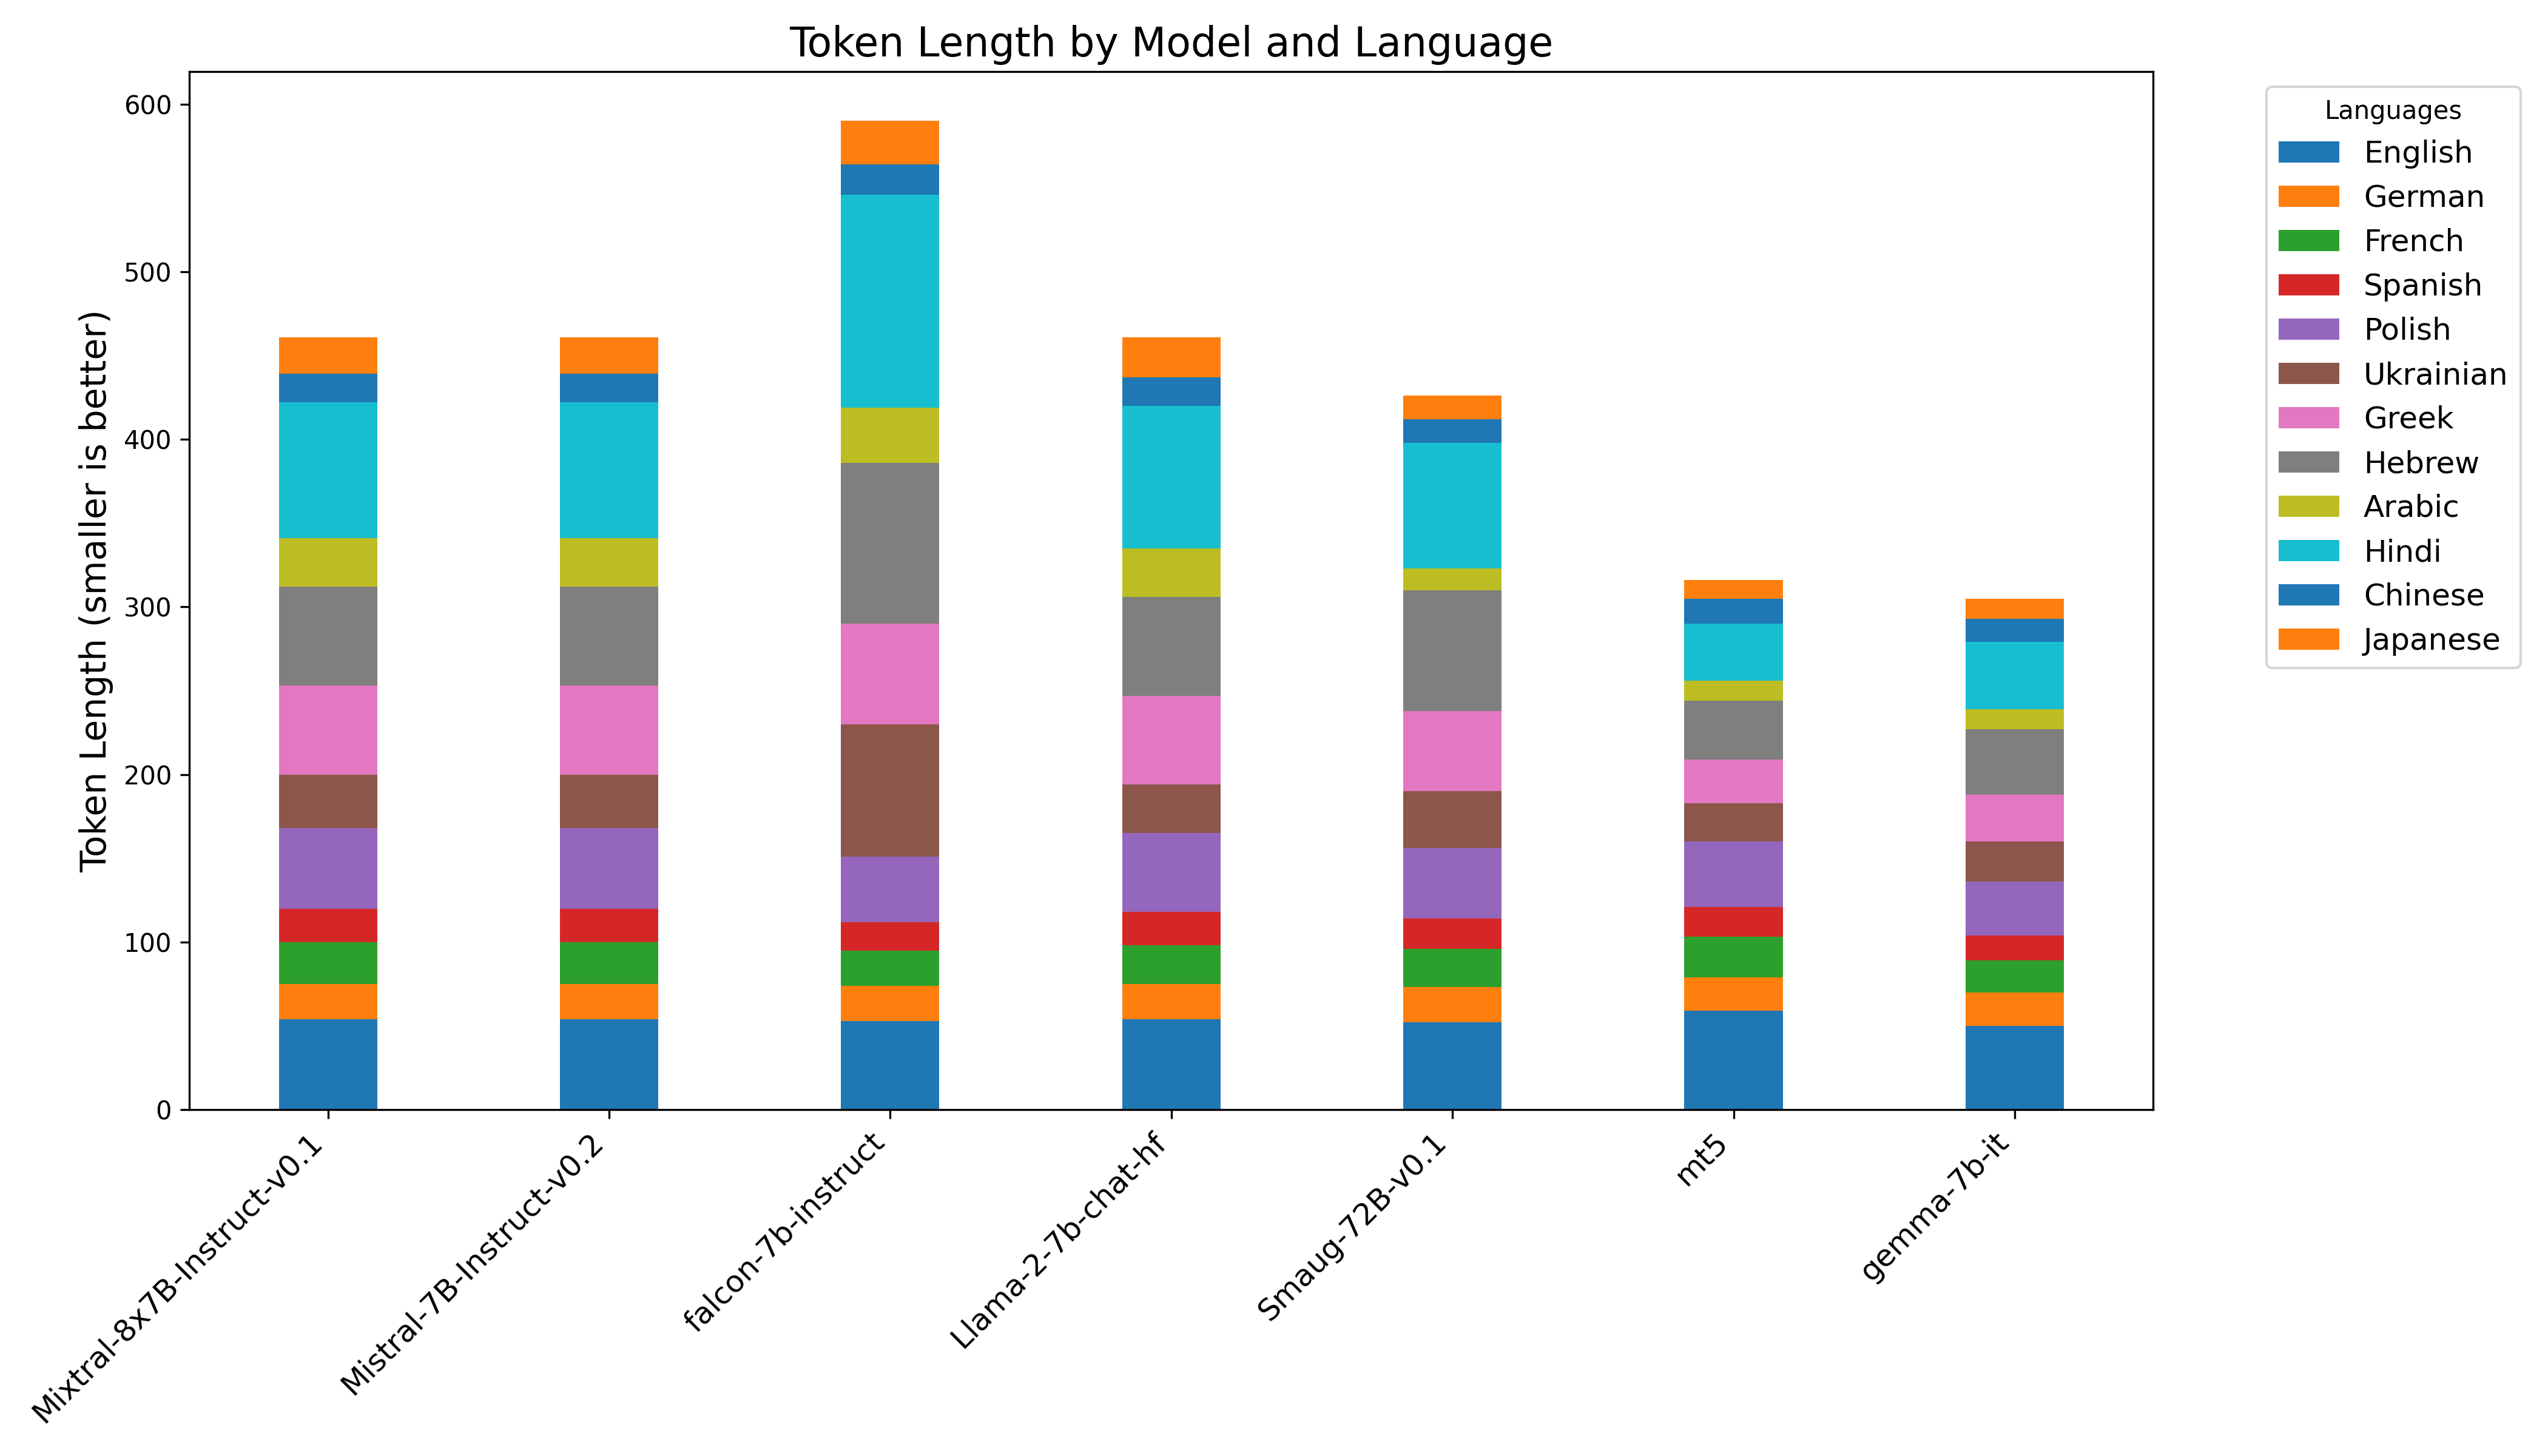
Hier ist ein direkter Vergleich der Tokenisierungsleistung zwischen Gemma und Llama-2:
| Sprache | Llama-2 Tokens | Gemma Tokens | Verbesserung |
|---|---|---|---|
| English | 54 | 50 | 7% |
| German | 21 | 20 | 5% |
| French | 23 | 19 | 17% |
| Spanish | 20 | 15 | 25% |
| Polish | 47 | 32 | 32% |
| Ukrainian | 29 | 24 | 17% |
| Greek | 53 | 28 | 47% |
| Hebrew | 59 | 39 | 34% |
| Arabic | 29 | 12 | 59% |
| Hindi | 85 | 40 | 53% |
| Chinese | 17 | 14 | 18% |
| Japanese | 24 | 12 | 50% |
Auf den ersten Blick mag Gemma wie ein weiteres LLM erscheinen – ähnlich den vielen anderen, die jeden Monat von der Open-Source-Community veröffentlicht werden. Lassen Sie sich jedoch nicht täuschen: Dies ist eine enorme Nachricht für den LLM-Bereich. Mit der Einführung von Gemma haben Unternehmen weltweit nun die Möglichkeit, Open-Access-LLMs für eine Vielzahl von Anwendungen feinzutunen – darunter konversationelle Übersetzer, mehrsprachige Schreibassistenten und Retrieval-Augmented-Generation-Systeme (RAG). Diese Veröffentlichung schließt eine bedeutende, bisher übersehene Lücke in der LLM-Landschaft. Es markiert die Ankunft des ersten wirklich mehrsprachigen Chat-LLMs.
Der Aufbau eines eigenen LLM kann die Datensicherheit und Compliance verbessern und einen KI-Wettbewerbsvorteil für Ihr Produkt ermöglichen. In unseren anderen Beiträgen finden Sie ausführliche Erklärungen:
- Was der Netzwerkeffekt ist
- Wie KI den Netzwerkeffekt ermöglicht
- Wie Sie einen KI-Wettbewerbsvorteil aufbauen
- Welche Kultur beim Aufbau der richtigen KI-Produkte hilft
- Was Sie in Ihrer KI-Strategie vermeiden sollten
Bauen Sie ein mehrsprachiges KI-Produkt?
Die Wahl des richtigen Modells und Tokenizers ist entscheidend. Lassen Sie uns gemeinsam die beste Grundlage für Ihre mehrsprachige KI-Lösung finden.