
Pas assez de données ? Visez les données futures
Par Sergii Shelpuk,Managing Partner chez Shelpuk & Company
Le manque de données et les problèmes de qualité des données ont figuré parmi les trois principales préoccupations des dirigeants concernant l’adoption de l’IA et du machine learning pendant au moins sept ans, de 2015 à 2022. Pourtant, même si elles sont utiles pour concevoir un produit d’IA, les données dont vous disposez aujourd’hui ne sont pas une condition indispensable pour bâtir une entreprise d’IA, et leur absence ou leurs imperfections ne sont pas un obstacle rédhibitoire au développement de produits de deep learning. L’élément réellement décisif est ce que j’appelle les « données futures ».
Il y a quelque temps, Vasyl Rakivnenko, fondateur de la startup Alko Prevent, m’a demandé de l’aider à définir la stratégie IA de son entreprise. Alko Prevent aide les sociétés de transport à s’assurer de la sobriété de leurs chauffeurs en détectant les signes d’intoxication grâce à la vision par ordinateur et au machine learning. Leader énergique et visionnaire, Vasyl m’a associé à la planification des efforts IA de l’entreprise ainsi qu’à la coordination avec l’équipe d’ingénierie.
L’équipe d’ingénierie travaillait sur la première version du produit et du système de machine learning. Le modèle devait reconnaître les visages sobres et les visages intoxiqués, avec un fort niveau d’exigence sur la qualité, car le système n’avait de valeur pour les clients qu’au-delà d’un certain seuil de précision.
Comme souvent, le jeu de données constituait la partie la plus difficile du travail de R&D. L’équipe proposait d’utiliser un classifieur basé sur un réseau de neurones profond pour trier les visages entre « sobres » et « intoxiqués ». Cette approche exigeait un jeu de données volumineux et équilibré, où les deux classes seraient représentées en proportions comparables. Faute de données d’entraînement disponibles, l’équipe prévoyait de récupérer des photos de visages via Google, puis de les annoter manuellement en fonction des signes visibles d’intoxication.
Mon point de vue était différent. Vasyl voulait bâtir une entreprise d’IA. Cela impliquait que le machine learning soit au cœur de son avantage concurrentiel.
En grandissant, Alko Prevent allait collecter de plus en plus de données, essentiellement des selfies de chauffeurs, dont l’immense majorité seraient sobres. Les données propriétaires de l’entreprise seraient donc, d’une part, très déséquilibrées et composées principalement de visages sobres, et d’autre part non annotées. Même si les classifieurs entraînés de manière supervisée sur des données labellisées représentent l’état de l’art en vision, ils ne seraient pas capables de tirer pleinement parti des données futures d’Alko Prevent. Un classifieur de deep learning pouvait éventuellement convenir pour un MVP, mais l’entreprise risquait d’abandonner à terme le résultat d’un coûteux effort de R&D. En outre, cette approche ne créait aucun avantage concurrentiel : n’importe qui pouvait récupérer des images sur Google et développer un produit de performance similaire.
L’équipe d’Alko Prevent proposait donc une fonctionnalité IA, mais pas un avantage concurrentiel fondé sur l’IA. Les fonctionnalités IA, à elles seules, ne suffisent pas à faire une entreprise d’IA.
Les produits IA s’améliorent avec de nouvelles données, créant ainsi un effet de réseau extrêmement difficile à attaquer. Prenons Google. La publicité numérique représente un marché colossal de 600 milliards de dollars. Et avec les technologies cloud actuelles et la puissance de calcul disponible, construire un moteur de recherche est beaucoup plus simple qu’en 1998. On pourrait donc s’attendre à un marché saturé, mais quelques géants le dominent encore. La raison est que Google et d’autres entreprises Internet ont transformé leurs données en avantage concurrentiel quasi imprenable grâce à l’IA. Google connaît votre historique de recherche, vos clics, vos e-mails Gmail, votre historique YouTube et bien plus encore. Ses algorithmes s’ajustent en permanence à chaque utilisateur. Même en recopiant toute la base de code de Google ligne par ligne sur sa propre infrastructure cloud, une concurrente serait incapable de rivaliser faute de disposer de l’historique de données correspondant.
Pour suivre une trajectoire comparable, Alko Prevent devait concevoir un produit qui s’améliore avec le temps et transforme les données propriétaires de l’entreprise en avantage concurrentiel. Les données futures prendraient la forme d’un ensemble très déséquilibré de selfies. Mais elles contiendraient une structure exploitable : on peut s’attendre à ce qu’un même utilisateur prenne des photos similaires, dans des environnements relativement proches, avec la même caméra, à courte distance du visage. Reformulé ainsi, le problème devient différent : à partir d’un historique de selfies de la même personne, alerter la société de transport si, un jour donné, le chauffeur paraît sensiblement différent de son état habituel.
En suivant cette logique, j’ai recommandé d’utiliser la détection d’anomalies par deep learning plutôt qu’une classification supervisée. La détection d’anomalies fonctionne avec des ensembles de données très déséquilibrés et non annotés, et elle permet de détecter toute forme d’écart, sans se limiter à certains types d’intoxication comme l’alcool. En outre, le produit s’améliore avec l’arrivée de nouvelles données, ce qui transforme progressivement l’offre d’Alko Prevent en activité réellement défendable.
Le manque de données ou leur qualité imparfaite peut effectivement poser problème au départ, mais ce problème se résout grâce aux données futures. Il faut concevoir le produit et les parcours utilisateurs de manière à collecter les données nécessaires à votre cycle vertueux IA. Idéalement, l’utilisateur ne devrait pas pouvoir accomplir son parcours sans vous fournir une donnée utile à vos modèles.
Une entreprise d’IA fonctionne selon le cycle suivant :
- Construire un modèle de machine learning simple ;
- convaincre quelques clients de l’utiliser ;
- collecter leurs données ;
- réentraîner le modèle ;
- convaincre davantage de clients grâce à un modèle amélioré ;
- répéter.
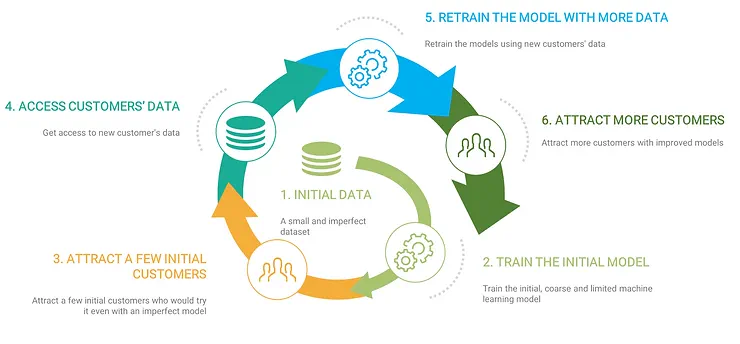
Lorsqu’il est bien conçu, l’avantage concurrentiel fondé sur l’IA enferme les concurrents dans le raisonnement suivant :
- Pour concurrencer votre entreprise, je dois construire un meilleur produit.
- Pour construire un meilleur produit, je dois disposer de meilleurs modèles de machine learning.
- Pour entraîner de meilleurs modèles, je dois obtenir davantage de données que vous.
- Pour obtenir davantage de données que vous, je dois gagner davantage de clients.
- Pour gagner davantage de clients que vous, je dois proposer un meilleur produit. Contradiction démontrée.
La stratégie IA doit également être étroitement intégrée à la stratégie produit et à la stratégie business : dans une entreprise d’IA, aucune de ces dimensions ne fonctionne sans les autres. Identifier le bon point d’impact et concentrer les efforts transverses sur l’obtention de résultats concrets est essentiel. Construire la bonne stratégie IA est un travail complexe, mais il doit déboucher sur une orientation simple et exécutable.
Une bonne stratégie IA est claire, facile à comprendre, à communiquer, à exécuter et à mesurer à chaque étape du développement produit et business. À l’inverse, une présentation confuse, trop épaisse et saturée de jargon doit vous alerter : bien souvent, cela signifie qu’il n’y a en réalité aucune stratégie IA.
Si vous cherchez à construire un avantage concurrentiel fondé sur l’IA pour votre entreprise, nous pouvons vous accompagner. Notre équipe d’experts métier et de consultants en technologies IA aide depuis des années des entreprises technologiques à bâtir des avantages durables grâce à l’IA. De la stratégie de collecte des données au développement des algorithmes, nous pouvons vous aider à garder une longueur d’avance et à protéger durablement votre part de marché.
Pas encore de données ? Ce n'est pas un problème, c'est une opportunité.
Déterminons où votre produit peut commencer à collecter les données qui deviendront votre meilleur atout concurrentiel.