
Pochi dati per il ML? Costruisci per il futuro
Di Sergii Shelpuk,Managing Partner presso Shelpuk & Company
La mancanza di dati e i problemi di qualità dei dati sono stati per almeno sette anni, dal 2015 al 2022, tra le tre principali preoccupazioni dei CEO rispetto all’adozione di AI e machine learning. Eppure, per quanto i dati disponibili oggi siano utili nella progettazione di un prodotto AI, non sono un prerequisito assoluto per costruire un business basato sull’AI, e la loro assenza o imperfezione non è necessariamente un ostacolo insormontabile allo sviluppo di prodotti di deep learning. L’elemento davvero decisivo è quello che io chiamo i “dati futuri”.
Qualche tempo fa, Vasyl Rakivnenko, fondatore della startup Alko Prevent, mi ha chiesto di aiutarlo a definire la strategia AI della sua azienda. Alko Prevent aiuta le imprese di autotrasporto a verificare la sobrietà degli autisti rilevando segnali di intossicazione con computer vision e machine learning. Vasyl, imprenditore energico e molto lucido, mi ha coinvolto nella pianificazione del lavoro AI dell’azienda e nel coordinamento con il team di ingegneria.
Il team stava lavorando alla prima versione del prodotto e del sistema di machine learning. Il modello doveva distinguere i volti sobri da quelli alterati, con un forte focus sulla qualità: per i clienti il sistema aveva senso solo oltre una certa soglia di accuratezza.
Come spesso accade, il dataset era la parte più difficile dell’attività di R&D. Il team proponeva di usare un classificatore basato su reti neurali profonde per ordinare tutti i volti in due classi, “sobrio” e “alterato”. Questa soluzione richiedeva un dataset ampio e bilanciato, nel quale la quota di volti sobri e alterati fosse approssimativamente equivalente. Non essendoci dati di training pronti all’uso, il piano era recuperare immagini di volti da Google e poi etichettarle manualmente in base ai segnali visibili.
Io la vedevo diversamente. Vasyl voleva costruire un’azienda AI. Questo significava che il machine learning avrebbe dovuto costituire il cuore del vantaggio competitivo.
Crescendo, Alko Prevent avrebbe raccolto sempre più dati: selfie degli autisti, nella stragrande maggioranza dei casi di persone sobrie. I dati proprietari dell’azienda sarebbero quindi, da un lato, fortemente sbilanciati e composti soprattutto da volti sobri e, dall’altro, non etichettati. Anche se i classificatori addestrati in modalità supervisionata su dataset annotati rappresentano lo stato dell’arte nell’image classification, non sarebbero stati in grado di sfruttare davvero i dati futuri di Alko Prevent. Un classificatore di deep learning poteva forse funzionare per l’MVP, ma con ogni probabilità l’azienda avrebbe poi dovuto buttare via il risultato di un costoso lavoro di R&D. Inoltre, non avrebbe creato alcun vantaggio competitivo: chiunque può recuperare immagini da Google e sviluppare un prodotto con performance simili.
In sostanza, il team di Alko Prevent stava proponendo una feature AI, non un vantaggio competitivo basato sull’AI. Le feature AI, da sole, non fanno un’azienda AI.
I prodotti AI migliorano man mano che arrivano nuovi dati, creando così un forte effetto di rete quasi impossibile da scardinare. Pensiamo a Google. La pubblicità digitale è un mercato da 600 miliardi di dollari. Inoltre, con le tecnologie cloud e la potenza di calcolo di oggi, costruire un motore di ricerca è molto più facile che nel 1998. Ci si aspetterebbe quindi un mercato affollato, e invece lo dominano pochi giganti. Il motivo è che Google e altre aziende Internet hanno trasformato i loro dati in un vantaggio competitivo quasi inespugnabile grazie all’AI. Google conosce la tua cronologia di ricerca, i clic sui risultati, le email e le risposte su Gmail, le ricerche e le visualizzazioni su YouTube e molto altro ancora. I suoi algoritmi si adattano automaticamente a ogni utente e migliorano nel tempo. Anche copiando l’intero codice di Google riga per riga su un’altra infrastruttura cloud, sarebbe impossibile competere senza lo storico dei dati.
Per seguire una traiettoria simile, Alko Prevent doveva costruire un prodotto capace di migliorare nel tempo, trasformando i dati proprietari dell’azienda in vantaggio competitivo. I dati futuri sarebbero stati un insieme molto sbilanciato di selfie. Ma al loro interno ci sarebbe stata una struttura utile: ci aspettiamo che ogni utente scatti foto simili, in ambienti più o meno simili, con la stessa fotocamera e a breve distanza dal volto. Vista così, la formulazione del problema cambia: partendo dallo storico dei selfie della stessa persona, avvisare l’azienda di trasporto quando, in un determinato giorno, l’autista appare sensibilmente diverso dal proprio stato abituale.
Seguendo questa logica, ho suggerito di usare la rilevazione di anomalie tramite deep learning invece della classificazione supervisionata. L’anomaly detection funziona bene con dataset fortemente sbilanciati e non etichettati, e consente di individuare qualsiasi deviazione rilevante, non solo specifiche forme di alterazione come l’alcol. Inoltre, il prodotto migliora man mano che arrivano nuovi dati, trasformando progressivamente l’offerta di Alko Prevent in un business difendibile.
La mancanza di dati o la loro qualità imperfetta possono essere davvero un problema iniziale, ma è un problema che si risolve progettando intorno ai dati futuri. Devi disegnare il prodotto e le user journey in modo che raccolgano i dati necessari ad alimentare il tuo circolo virtuoso AI. Idealmente, l’utente non dovrebbe poter completare il percorso senza fornirti un dato utile ai tuoi modelli.
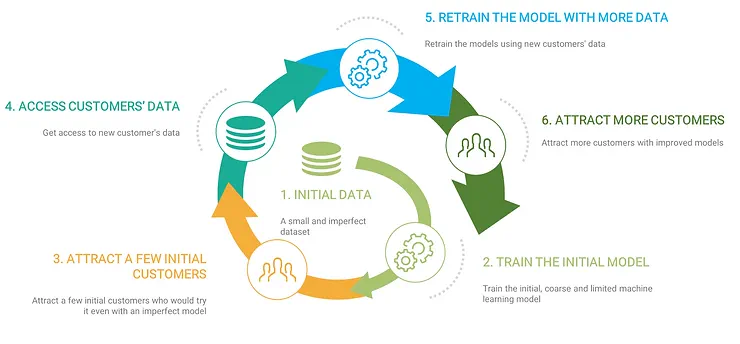
Un’azienda AI segue questo ciclo:
- costruire un modello di machine learning semplice;
- convincere alcuni clienti a usarlo;
- raccogliere i loro dati;
- riaddestrare il modello;
- convincere altri clienti grazie a un modello migliore;
- ripetere.
Se costruito correttamente, il vantaggio competitivo AI mette i concorrenti davanti a questo paradosso:
- Per competere con la tua azienda devo costruire un prodotto migliore del tuo.
- Per costruire un prodotto migliore del tuo mi servono modelli di machine learning migliori dei tuoi.
- Per addestrare modelli migliori dei tuoi mi servono più dati di quelli che possiedi tu.
- Per ottenere più dati di te mi servono più clienti di te.
- Per ottenere più clienti di te mi serve un prodotto migliore del tuo. Una contraddizione senza uscita.
La strategia AI deve inoltre essere strettamente integrata con la strategia di prodotto e con la strategia di business: in un’azienda AI nessuna di queste dimensioni funziona davvero senza le altre. Identificare il giusto punto d’impatto e concentrare gli sforzi cross-funzionali sui risultati è essenziale. Definire la strategia AI corretta è un lavoro complesso, ma deve tradursi in un risultato semplice e operativo.
Una buona strategia AI è chiara, facile da comprendere, da comunicare, da eseguire e da misurare in ogni fase dello sviluppo del prodotto e dell’azienda. Se invece ti trovi davanti a un mazzo di slide pesante, opaco e pieno di buzzword, dovrebbe scattare un campanello d’allarme: molto spesso significa che, in realtà, una strategia AI non c’è.
Se vuoi costruire un vantaggio competitivo basato sull’AI per la tua azienda, possiamo aiutarti. Il nostro team di esperti di business e consulenti di tecnologia AI aiuta da anni aziende tecnologiche come la tua a costruire vantaggi sostenibili attraverso dati, modelli e impostazione strategica. Dalla raccolta dei dati allo sviluppo degli algoritmi, possiamo aiutarti a restare davanti alla concorrenza e a difendere nel tempo la tua quota di mercato.
Non hai ancora dati? Non è un problema: è un'opportunità.
Individuiamo dove il tuo prodotto può iniziare a raccogliere i dati che diventeranno il tuo asset competitivo più forte.