
Low-Rank Adaptation (LoRA) pour LLM efficaces
Dans le monde en évolution rapide de l’intelligence artificielle, il est crucial d’adapter efficacement les grands modèles de langage à de nouvelles tâches ou ensembles de données. Cet article de blog vise à démystifier l'adaptation de bas rang (LoRA), une technique de pointe conçue pour affiner les grands modèles de langage comme Llama-2, Llama-3 et Mistral. À la fin de cet article, vous comprendrez ce qu’est LoRA, comment il fonctionne et pourquoi il devient un outil essentiel pour les praticiens de l’IA.
Pourquoi LoRA est important
Le réglage traditionnel de grands modèles peut prendre du temps et être coûteux, nécessitant souvent des ressources informatiques importantes. LoRA introduit une nouvelle approche qui atténue ces problèmes en réduisant le nombre de paramètres pouvant être entraînés grâce à une décomposition matricielle de bas rang. Cette méthode accélère non seulement le processus de formation, mais préserve également la mémoire, ce qui rend plus réalisable le déploiement de ces modèles dans diverses applications pratiques.
LoRA est particulièrement bénéfique dans les scénarios où les modèles doivent être fréquemment mis à jour ou adaptés à de nouvelles tâches sans le luxe d'une puissance de calcul étendue. En simplifiant le processus d'adaptation, LoRA permet à davantage d'organisations d'exploiter la puissance de grands modèles de langage, démocratisant ainsi l'accès aux capacités avancées d'IA.
Dans les sections qui suivent, nous approfondirons les mécanismes de LoRA, explorerons ses applications pratiques et mettrons en évidence quelques études de cas réels démontrant son efficacité. Que vous soyez chercheur en IA, data scientist ou ingénieur en apprentissage automatique, comprendre LoRA peut améliorer considérablement votre capacité à travailler efficacement avec de grands modèles de langage.
Qu’est-ce que LoRA ?
LoRA est une technique innovante conçue pour réduire le nombre de paramètres pouvant être entraînés dans les grands modèles de langage. En se concentrant sur cette réduction, LoRA rend le processus de réglage fin plus rapide et plus efficace sans compromettre les performances du modèle. Cette méthode exploite les principes mathématiques pour simplifier et accélérer l'adaptation de grands modèles à de nouvelles tâches ou ensembles de données.
Concepts clés :
- Décomposition de bas rang: Au cœur de LoRA se trouve le concept de décomposition de bas rang. Cela implique de décomposer de grandes matrices en éléments plus petits et plus faciles à gérer. En faisant cela, nous pouvons nous concentrer sur les parties les plus critiques des données, rendant ainsi le processus de formation plus efficace. Essentiellement, la décomposition de bas rang aide à identifier et à isoler les paramètres les plus influents qui nécessitent un ajustement lors du réglage fin.
- Rang matriciel: Le rang d’une matrice est une mesure de sa complexité, déterminée par le nombre de lignes ou de colonnes linéairement indépendantes qu’elle contient. Dans le contexte de LoRA, nous visons à utiliser des matrices avec des rangs inférieurs pour représenter les changements dans les poids du modèle. Cette approche réduit considérablement la charge de calcul, car les matrices de rang inférieur sont plus simples et nécessitent moins de ressources à traiter.
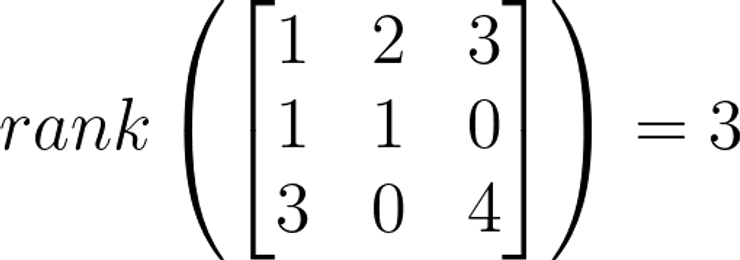
Matrice de rang complet (par ML6)
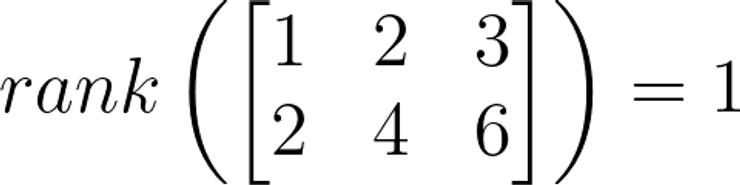
Matrice de rang déficient (par ML6)
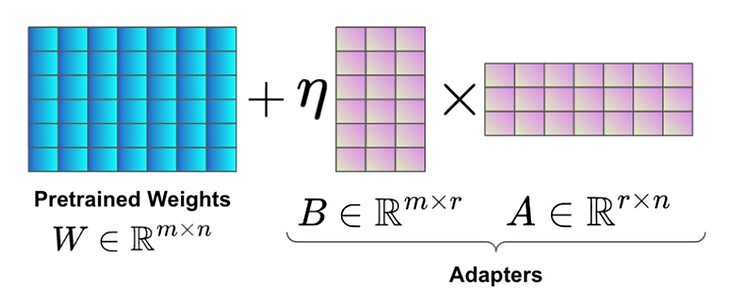
Reparamétrisation du poids avec des adaptateurs LoRA (par Wang et al.)
Avantages:
- Temps de formation plus rapides: En réduisant le nombre de paramètres pouvant être entraînés, LoRA accélère le processus de formation. Ceci est particulièrement utile lorsque vous travaillez avec de grands ensembles de données ou lorsque des mises à jour rapides du modèle sont nécessaires.
- Utilisation réduite de la mémoire: L’efficacité de LoRA s’étend également à l’utilisation de la mémoire. Des jeux de paramètres plus petits nécessitent moins de mémoire, ce qui permet de former et d'affiner de grands modèles sur du matériel aux spécifications plus modestes.
- Stockage et partage de modèles plus faciles: Les modèles optimisés avec LoRA ont des fichiers de poids plus petits, ce qui les rend plus faciles à stocker et à partager. Ceci est particulièrement utile pour les projets collaboratifs ou lors du déploiement de modèles sur différentes plateformes.
Comment fonctionne LoRA
Lors de l'adaptation de grands modèles avec LoRA, nous mettons à jour les matrices de poids en utilisant des matrices de bas rang. Au lieu de modifier directement la matrice de poids entière, LoRA introduit deux matrices plus petites qui, une fois multipliées ensemble, se rapprochent des changements nécessaires dans la matrice d'origine. Cette méthode simplifie non seulement les calculs mais préserve également les caractéristiques essentielles du modèle tout en l'adaptant à de nouvelles tâches ou ensembles de données.
Paramètres clés :
- rank: Définit la dimension interne des matrices de bas rang. Un rang plus élevé signifie plus de paramètres pouvant être entraînés.
- lora_alpha: Un facteur d'échelle pour les matrices de bas rang. Il ajuste l'influence de l'adaptation de bas rang sur le modèle global.
- target_modules: Spécifie quelles parties du modèle utiliseront LoRA. Cela permet un réglage précis ciblé et contribue à réduire les calculs inutiles.
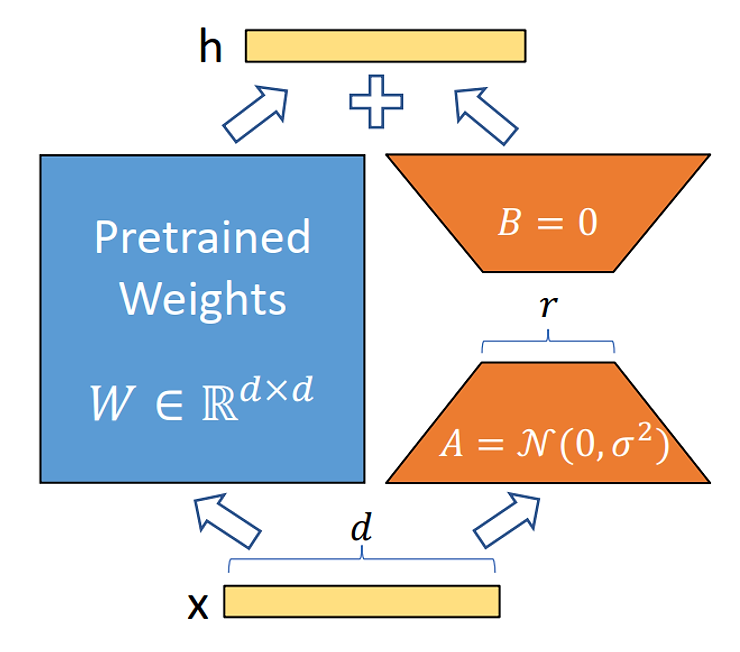
Reparamétrisation LoRA. Nous entraînons uniquement les matrices A et B lors du réglage fin des LLM (en Hu et al.)
Défis et considérations
Bien que LoRA offre de nombreux avantages pour affiner les grands modèles de langage, elle comporte également son propre ensemble de défis. Comprendre ces défis et comment les relever est crucial pour mettre en œuvre efficacement la LoRA.
Surajustement et sous-ajustement :
L’un des principaux défis lors de l’utilisation de LoRA est de trouver le bon équilibre dans la complexité des matrices de bas rang. Si les matrices sont trop simples, le modèle risque de ne pas être adapté, ne parvenant pas à capturer les informations essentielles et les nuances des données. À l’inverse, si les matrices sont trop complexes, le modèle risque de surajuster, capturant le bruit ainsi que les données pertinentes. Atteindre le bon équilibre garantit que le modèle se généralise bien aux nouvelles données invisibles.
Hétérogénéité des données :
Un autre défi important consiste à gérer l’hétérogénéité des données. Ce problème survient lorsqu'il existe une différence substantielle entre le domaine source (où le modèle a été initialement formé) et le domaine cible (où le modèle est en cours d'adaptation). De telles différences peuvent entraver la capacité du modèle à transférer efficacement les connaissances.
Disponibilité des données :
Enfin, la disponibilité des données est une considération essentielle. Dans de nombreux cas, obtenir des données étiquetées dans le domaine cible peut s’avérer difficile et coûteux. Cette limitation peut entraver le processus de réglage fin, car LoRA, comme d’autres techniques d’apprentissage automatique, nécessite généralement une quantité importante de données pour construire des modèles robustes. L'exploration d'approches semi-supervisées, dans lesquelles le modèle est formé sur une combinaison de données étiquetées et non étiquetées, peut contribuer à atténuer ce problème.
Orientations futures et recherche
Alors que LoRA continue de gagner du terrain dans la communauté de l’IA, il existe plusieurs pistes intéressantes pour la recherche et le développement futurs.
Avancées des techniques LoRA :
L’un des principaux domaines de recherche future consiste à explorer de nouvelles méthodes permettant de réduire davantage le nombre de paramètres pouvant être entraînés. Bien que LoRA diminue déjà considérablement la charge de calcul, il existe recherche en courspour repousser ces limites encore plus loin. Les innovations dans les techniques de factorisation matricielle et les algorithmes d’optimisation pourraient conduire à des modèles encore plus compacts sans sacrifier les performances.
Intégration avec d'autres technologies :
Une autre direction prometteuse pour les recherches futures est l’intégration de LoRA avec d’autres technologies avancées d’IA. Par exemple, la combinaison de LoRA avec des techniques telles que DreamBooth peut améliorer la personnalisation du modèle, permettant des processus de réglage plus personnalisés et plus efficaces.
L’avenir de LoRA est prometteur, avec des recherches en cours sur le point d’étendre ses capacités et ses applications. À mesure que ces progrès se dérouleront, LoRA continuera à jouer un rôle central dans l’évolution de l’IA, permettant une adaptation de modèles plus efficace et plus polyvalente dans divers domaines.
Articles connexes
- Guide du praticien LLM : Gemma, un LLM multilingue qui change la donne
- À quoi ressemble réellement Llama-2 multilingue ?
- Le tango se danse à deux : créer une synergie entre l’IA et le management produit
Vous souhaitez affiner un LLM pour votre cas d'utilisation ?
Déterminons la bonne approche de réglage fin — de la configuration LoRA à la stratégie de données — pour vos besoins spécifiques.