
Guide du praticien LLM : Gemma, multilingue
Guide du praticien LLM :
- À quoi ressemble réellement Llama-2 multilingue ?
- À quel point Falcon, Mistral, Smaug et autres LLMs sont-ils multilingues ?
- Gemma, un LLM multilingue qui change la donne
Le 21 février 2024, Google a dévoilé son nouveau modèle LLM (Large Language Model) en libre accès, Gemma. Cette sortie est une étape importante, bien plus importante qu’il n’y paraît au départ.
Depuis que ChatGPT a fait son apparition, le domaine des LLM en libre accès a connu une croissance explosive. Dès le début, nous avons été profondément impliqués dans la formation et la personnalisation des LLM de chat en libre accès. Malgré l’enthousiasme ambiant, ceux d’entre nous qui travaillent avec des modèles multilingues sont parfaitement conscients d’un problème crucial. Pour les langues en dehors des familles romanes et germaniques, les tokenizers inefficaces ont sévèrement limité les performances des LLM en libre accès.
Qu’est-ce qu’un tokenizer ? Il s’agit d’un algorithme qui découpe un texte en unités plus petites, appelées tokens. Selon sa conception, ces tokens peuvent correspondre à des mots entiers, à des sous-parties de mots, à des caractères individuels ou à d’autres unités. La tokenisation est une étape clé du traitement de texte pour les LLM, car elle rend possibles des usages comme la classification, le question-réponse ou la traduction automatique.
Les tokenizers sont une brique essentielle de la chaîne NLP : leur rôle est de convertir le texte dans un format que le modèle peut interpréter. Comme les modèles manipulent des données numériques, le tokenizer transforme l’entrée textuelle en séquences de nombres exploitables.
Une approche simple consiste à attribuer un numéro unique à chaque lettre ou symbole. Par exemple, « a » peut recevoir le numéro 1, « b » le numéro 2, et ainsi de suite. Le modèle tente ensuite de prédire le numéro suivant dans une séquence. Cependant, cette méthode peut transformer même une phrase courte en une longue séquence de nombres. Une seule erreur dans la prédiction d’une lettre peut perturber toutes les prédictions ultérieures, rendant cette méthode à la fois compliquée et sujette aux erreurs.
Une stratégie alternative attribue à chaque mot un numéro unique. Cela condense considérablement la séquence, mais ce n’est pas sans défis. Avec plus de 200 000 mots rien qu’en anglais, un modèle qui fonctionne dans plusieurs langues devra peut-être faire la différence entre des millions de nombres, ce qui augmentera considérablement le risque d’erreurs.
Pour répondre à ces contraintes, les chercheurs ont mis au point la tokenisation. Elle consiste à découper les mots en fragments plus petits et fréquents. Par exemple, « predicting » peut être scindé en « pred », « ict » et « ing ». Le modèle n’a alors plus à choisir parmi un dictionnaire entier, mais dans un ensemble beaucoup plus réduit de tokens.
Cependant, il existe un problème important : tous les LLM de chat en libre accès bien connus, tels que Llama, Llama-2, Mistral, Mixtral, Falcon, Smaug et autres, ont des tokenizers principalement conçus pour les langues romanes et germaniques. Pour les langues non germaniques, non romanes et non slaves telles que le grec, le chinois, l'hébreu, l'arabe, l'hindi, le coréen, le japonais, etc., ces langues sont réduites à des caractères.
Bien que vous puissiez améliorer les performances d'un modèle en l'entraînant avec des données plus nombreuses ou de meilleure qualité, le tokenizer présente un défi qui ne peut pas être relevé de la même manière. Le tokenizer fonctionne sur la base d’un algorithme déterministe et non d’un apprentissage automatique. Vous ne pouvez pas l’entraîner ou le modifier. Le modèle est intimement lié à son tokenizer ; tenter de le remplacer rendrait le modèle non fonctionnel.
Il a bien existé des modèles dotés de tokenizers multilingues efficaces, comme mt5 de Google en 2020. Mais il s’agissait de modèles de base, pas de modèles spécifiquement entraînés pour des usages conversationnels.
Cette situation a effectivement limité les applications pratiques des LLM aux langues principalement romanes et germaniques. Pour réaliser un LLM conversationnel de haute qualité, vous aviez deux choix :
- Affinez les LLM modernes, tels que Llama-2 ou Mistral, d'une manière qui rappelle 2015, en utilisant une représentation de texte basée sur des caractères.
- Commencez avec un modèle de base équipé d'un tokenizer robuste et entraînez-le à être conversationnel.
Les deux options nécessitent des ensembles de données étendus et très précis. Pour la plupart des langues et des entreprises, cela rendait pratiquement hors de portée la mise au point de LLM conversationnels multilingues modernes.
Jusqu'à maintenant.
Gemma
Gemma représente une nouvelle génération de modèles ouverts légers et de pointe qui s'appuient sur la recherche et la technologie derrière les modèles Gemini. Développé par Google DeepMind et diverses équipes de Google, Gemma s'inspire de Gemini, dont le nom vient du mot latin « gemma », signifiant « pierre précieuse ».
Voici ce que vous devez savoir :
- Google a dévoilé les poids du modèle Gemma en deux versions : Gemma 2B et Gemma 7B. Chaque version est disponible en variantes pré-entraînées et adaptées aux instructions.
- La nouvelle boîte à outils d'IA générative responsable offre des conseils et des outils essentiels pour développer des applications d'IA plus sûres à l'aide de Gemma.
- Google prend en charge les chaînes d'outils d'inférence et de réglage fin supervisé (SFT) dans tous les principaux frameworks, notamment JAX, PyTorch et TensorFlow, pris en charge nativement dans Keras 3.0.
- Google a mis à disposition des blocs-notes Colab et Kaggle prêts à l'emploi, ainsi qu'une intégration avec des outils largement utilisés tels que Hugging Face, MaxText, NVIDIA NeMo et TensorRT-LLM.
- Les modèles Gemma pré-entraînés et réglés sur instructions fonctionnent correctement sur diverses plates-formes, de votre ordinateur portable personnel à Google Cloud, avec des options de déploiement sur Vertex AI et Google Kubernetes Engine (GKE).
- Les conditions d'utilisation autorisent une utilisation commerciale et une distribution responsables par des organisations de toute taille.
Nous avons précédemment mis en avant mt5, le LLM 2020 de Google réputé pour son tokenizer multilingue exceptionnel. Maintenant, découvrez Gemma : équipée d'un tokenizer encore plus avancé. Dans notre dernière analyse, nous avons effectué des tests approfondis sur les tokeniseurs des principaux LLM dans une variété de langues, et voici comment le tokenizer de Gemma se démarque :
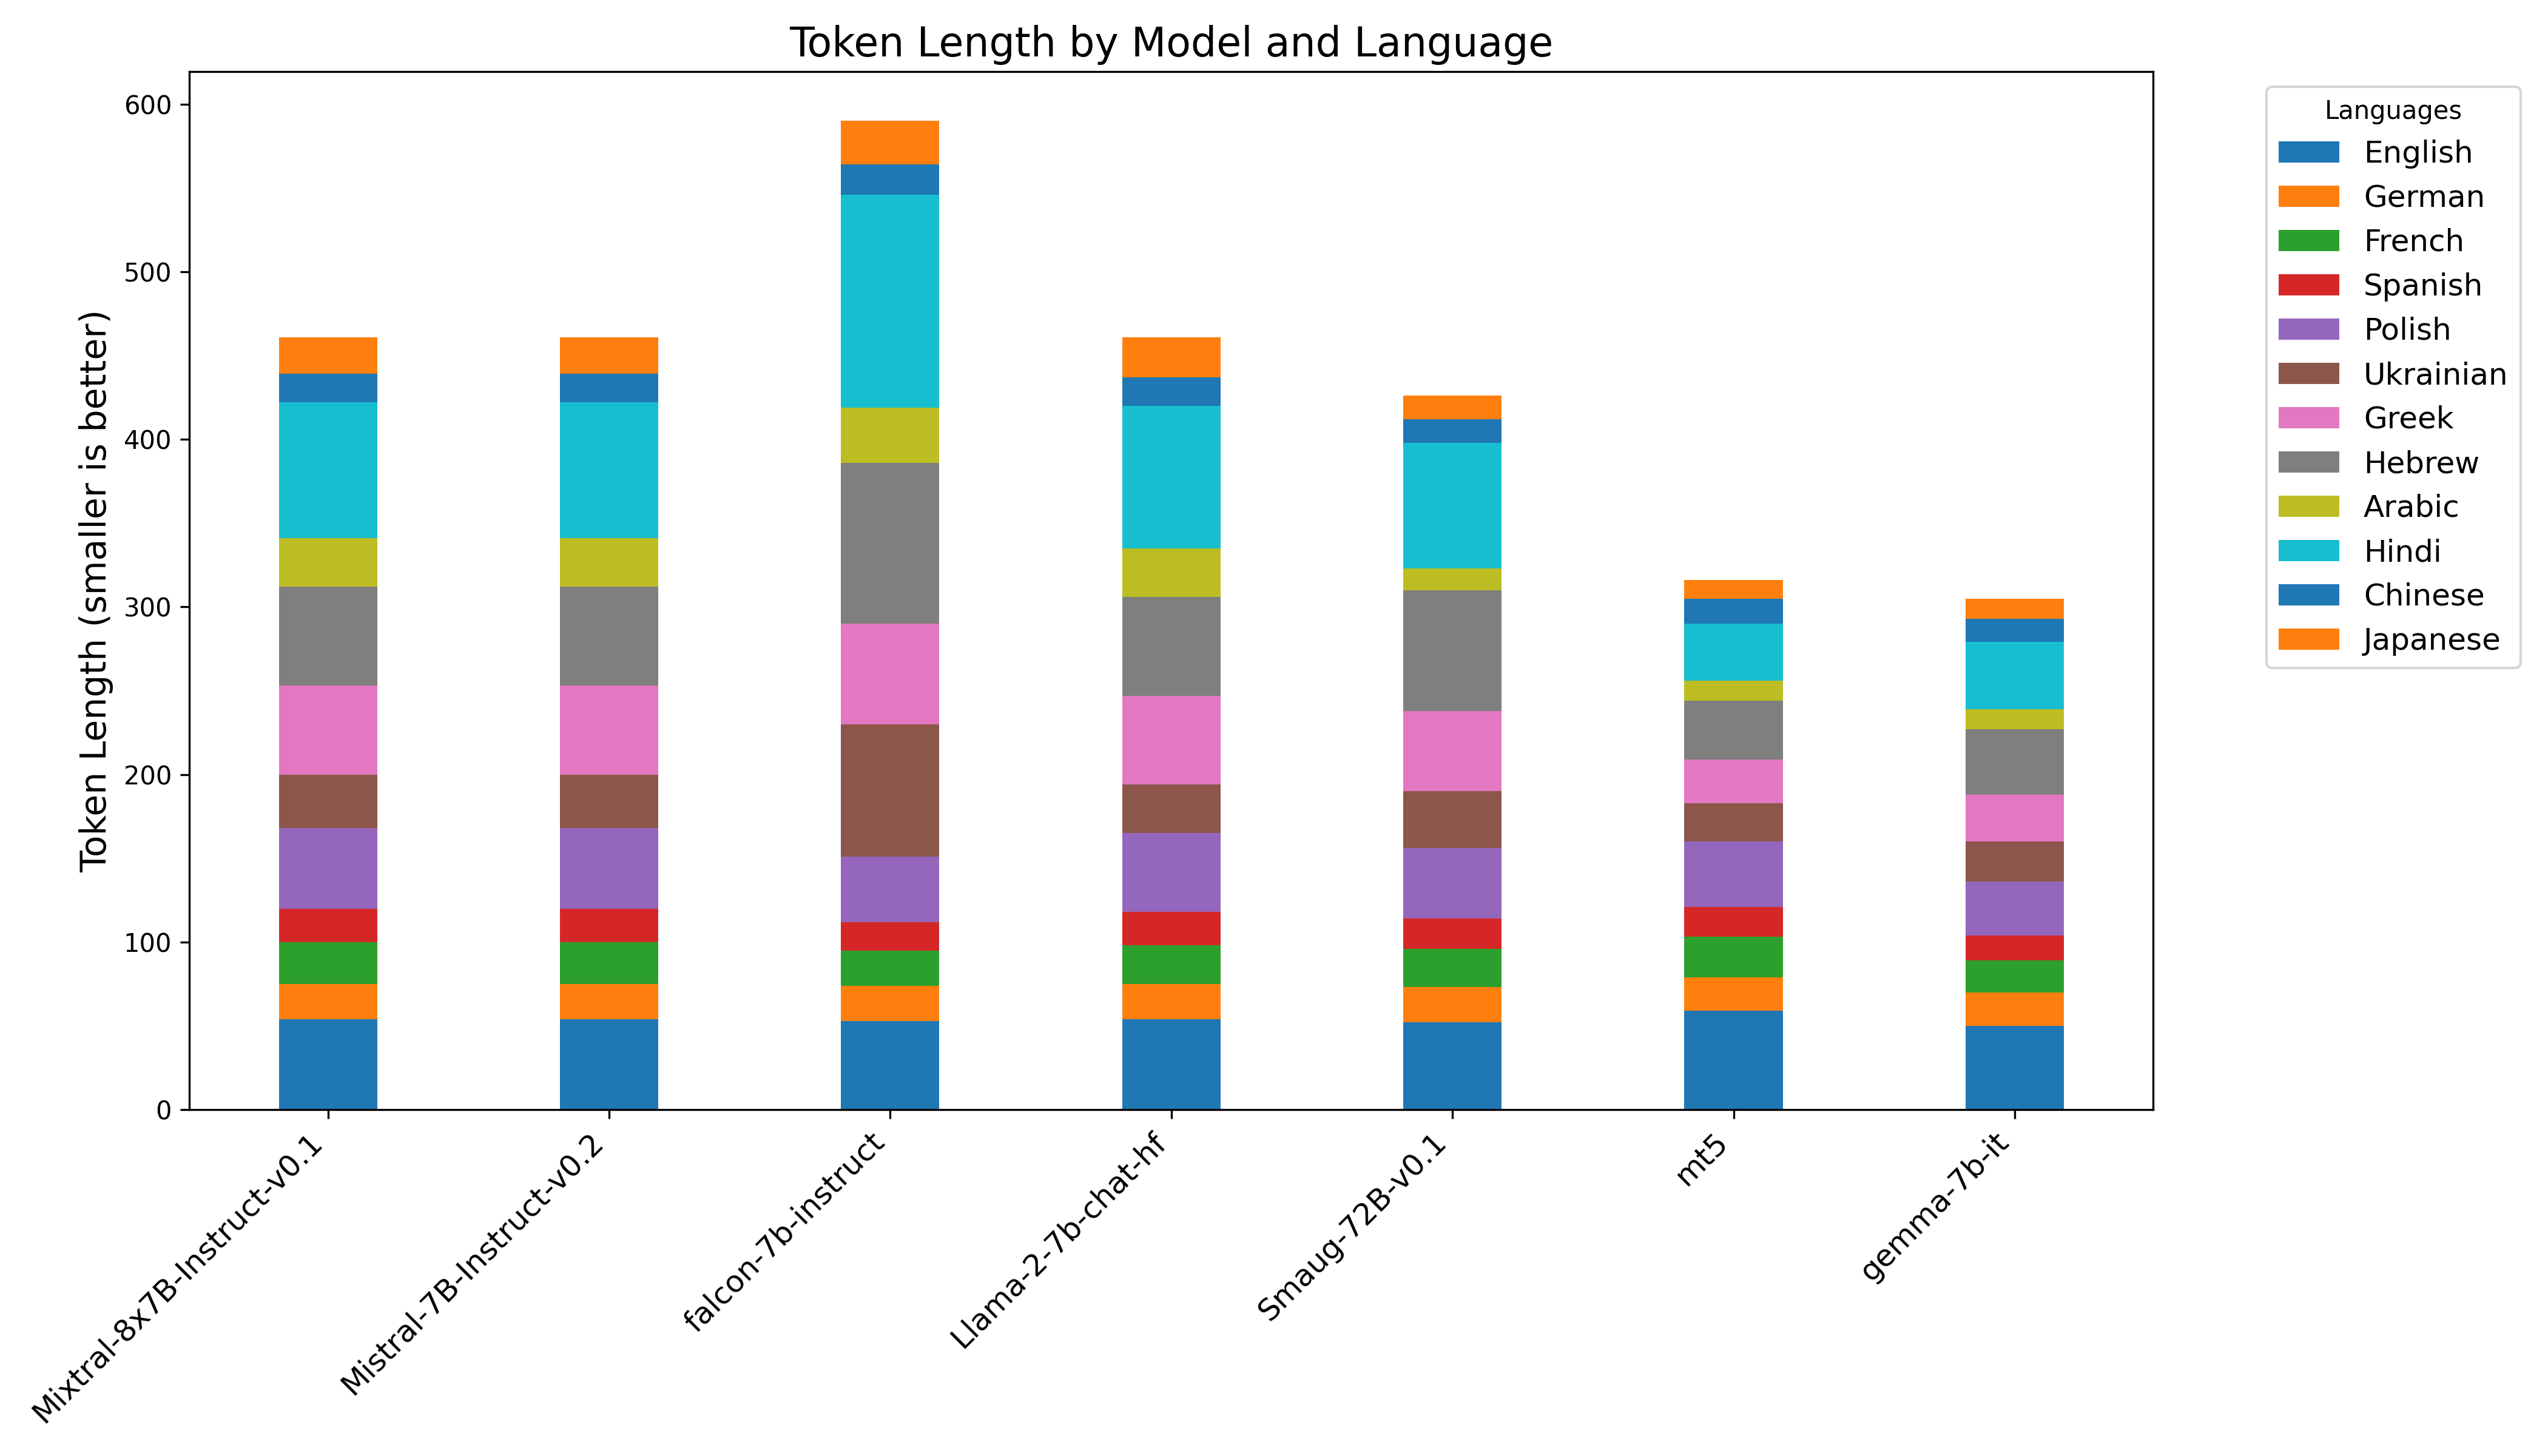
Et voici une comparaison directe des performances de tokenisation entre Gemma et Llama-2 :
| Langue | Llama-2 Tokens | Gemma Tokens | Amélioration |
|---|---|---|---|
| English | 54 | 50 | 7% |
| German | 21 | 20 | 5% |
| French | 23 | 19 | 17% |
| Spanish | 20 | 15 | 25% |
| Polish | 47 | 32 | 32% |
| Ukrainian | 29 | 24 | 17% |
| Greek | 53 | 28 | 47% |
| Hebrew | 59 | 39 | 34% |
| Arabic | 29 | 12 | 59% |
| Hindi | 85 | 40 | 53% |
| Chinese | 17 | 14 | 18% |
| Japanese | 24 | 12 | 50% |
À première vue, Gemma peut sembler n’être qu’un autre LLM – semblable aux nombreux autres publiés chaque mois par la communauté open source. Cependant, il est important de ne pas se tromper ; c'est une énorme nouvelle pour le domaine LLM. Avec l’introduction de Gemma, les entreprises du monde entier ont désormais la possibilité d’affiner les LLM en libre accès pour une variété d’applications. Cela inclut la création de traducteurs conversationnels, d'assistants d'écriture multilingues et de systèmes de génération de récupération augmentée (RAG). Cette version comble efficacement une lacune importante, bien que précédemment négligée, dans le paysage LLM. Cela marque l’arrivée du premier LLM de chat véritablement multilingue.
La création de votre LLM personnalisé pourrait améliorer la sécurité et la conformité des données et permettre à votre produit de bénéficier d'un avantage concurrentiel en matière d'IA. Consultez nos autres articles pour des explications détaillées :
- Quel est l'effet de réseau
- Comment l'IA permet l'effet de réseau
- Comment créer un avantage concurrentiel en matière d'IA
- Quelle culture aide à créer les bons produits d’IA
- Ce qu'il faut éviter dans votre stratégie d'IA
Vous développez un produit IA multilingue ?
Choisir le bon modèle et le bon tokenizer est essentiel. Trouvons la meilleure base pour votre solution d'IA multilingue.