
Llama 3.1 con Unsloth: due volte più veloce
Fare il fine-tuning di un large language model su dataset piccoli o didattici può essere relativamente semplice. Nelle applicazioni commerciali, però, quando le sequenze di input diventano lunghe o gli output sono molto estesi, la complessità cresce rapidamente. Anche con tecniche avanzate come QLoRA, basta un solo esempio di training per portare al limite una GPU da 80 GB, come H100 o A100. Inoltre, con input lunghi il fine-tuning può diventare estremamente lento.
Fortunatamente esiste una soluzione che può far risparmiare sia tempo sia risorse: Unsloth. In questo articolo vedremo cos’è, come installarlo e usarlo su piattaforme cloud GPU come Vast AI, MassedCompute e RunPod, e condivideremo alcune best practice che vanno oltre la documentazione ufficiale.
Che cos’è Unsloth?
Unsloth è una libreria open source gratuita, rilasciata con licenza Apache 2.0, progettata per rendere il fine-tuning degli LLM molto più efficiente. Rispetto alla libreria standard Hugging Face Transformers è circa 2,2 volte più veloce, usa il 70% in meno di memoria GPU e mantiene l’accuratezza sia con QLoRA a 4 bit sia con LoRA a 16 bit. Inoltre accelera anche l’inferenza.
Se sembra troppo bello per essere vero, la spiegazione è semplice: il fine-tuning degli LLM è ancora un’area relativamente giovane e piena di inefficienze. Unsloth interviene proprio su questi punti, migliorando l’uso della memoria e le prestazioni di training.
La codebase è scritta bene e resta leggibile, quindi è abbastanza facile capire come ottimizza il modello. In pratica, Unsloth elimina calcoli superflui e uniforma i tipi di dato, ottenendo così gran parte dei suoi guadagni di performance.
Abbiamo usato Unsloth in modo esteso nei nostri progetti, e questo articolo riflette la nostra esperienza aggiornata ad agosto 2024. Poiché il progetto evolve molto rapidamente, vi consigliamo comunque di verificare la documentazione ufficiale per eventuali aggiornamenti successivi.
Installare Unsloth
Iniziare con Unsloth può essere un po’ più delicato del previsto, soprattutto in fase di installazione. Il setup non è lineare quanto ci si aspetterebbe, e il modo più affidabile per configurarlo resta l’uso di un ambiente Conda.
In questa guida mostriamo l’installazione su una VM H100 di MassedCompute. Gli stessi passaggi, però, valgono anche per istanze GPU basate su Docker su piattaforme come Vast AI e RunPod.
1. Creare la VM
Per prima cosa andate su MassedCompute e create una nuova VM. In questo esempio usiamo un’istanza spot H100 per ridurre i costi. Tenete però presente che le istanze spot possono essere terminate con un preavviso di appena un’ora.
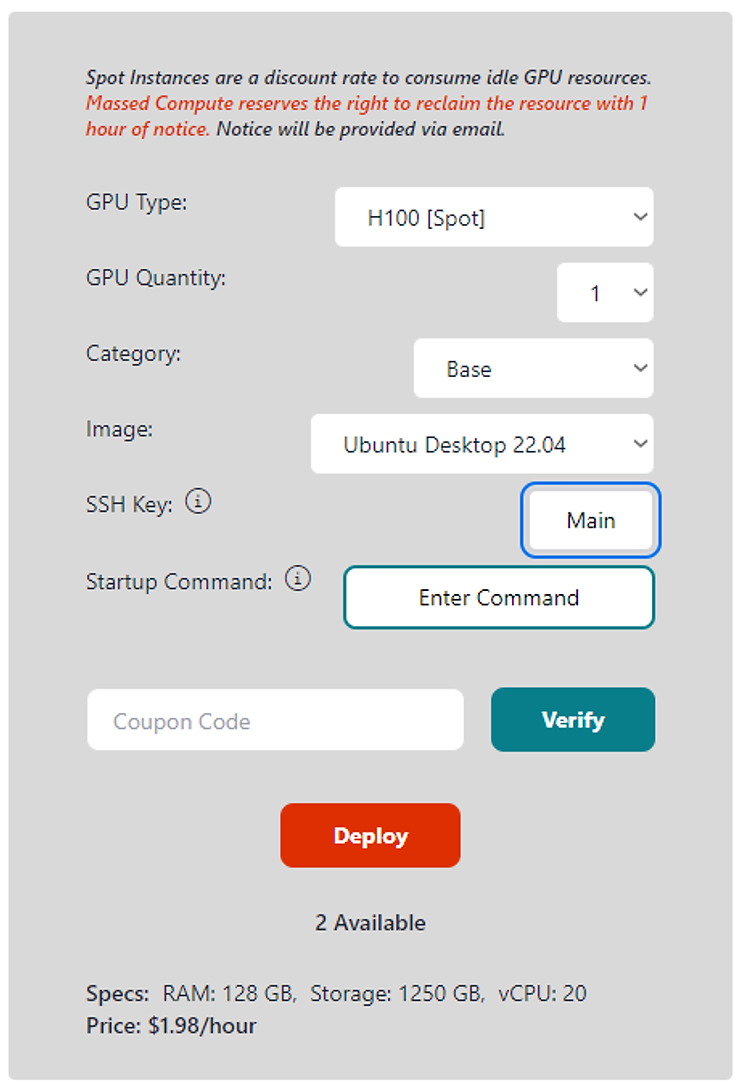
Selezionate il tipo di istanza "Base" e l’immagine del sistema operativo "Ubuntu Desktop 22.04", quindi fate clic su "Deploy".
2. Aggiornare i pacchetti
A questo punto aggiornate i pacchetti di base, installate la Hugging Face CLI e autenticatela con il vostro token Hugging Face.
sudo apt update
sudo apt upgrade -y
sudo apt install python3-pip -y
python3 -m pip install --upgrade pip
pip3 install packaging huggingface_hub[cli]
export PATH=$PATH:~/.local/bin
huggingface-cli login --token hf_<YOUR HUGGINGFACE TOKEN>
3. Installare Conda
mkdir -p /home/Ubuntu/miniconda3
wget https://repo.anaconda.com/miniconda/Miniconda3-latest-Linux-x86_64.sh -O ~/miniconda3/miniconda.sh
bash /home/Ubuntu/miniconda3/miniconda.sh -b -u -p ~/miniconda3
rm -rf /home/Ubuntu/miniconda3/miniconda.sh
/home/Ubuntu/miniconda3/bin/conda init bash
. /home/Ubuntu/.bashrc
4. Creare l’ambiente Conda di Unsloth
conda create --name unsloth_env python=3.10
conda activate unsloth_env
conda install pytorch==2.2.0 cudatoolkit torchvision torchaudio pytorch-cuda=12.1 -c pytorch -c nvidia
conda install xformers -c xformers
pip install bitsandbytes matplotlib datasets transformers trl peft accelerate sentencepiece
pip install --upgrade --force-reinstall --no-cache-dir git+https://github.com/unslothai/unsloth.git
Se usate Weights & Biases, installatelo a questo punto:
pip3 install wandb
wandb login
<YOUR WEIGHTS & BIASES TOKEN>
5. Installare e avviare Jupyter Notebook
sudo apt-get install nano -y
pip3 install jupyter
jupyter notebook --generate-config
Modificate la configurazione di Jupyter per impostare indirizzo IP e porta:
nano ~/.jupyter/jupyter_notebook_config.pyAggiungete le seguenti righe subito dopo "c = get_config()":
# Set the IP address to '*'
c.NotebookApp.ip = '0.0.0.0'

# Set the port to 10000
c.NotebookApp.port = 10000

# Disable browser opening
c.NotebookApp.open_browser = False
Impostate la password di Jupyter Notebook e avviatelo:
jupyter notebook password
jupyter notebook --allow-root
Aprite il browser e visitate http://<VM_IP_ADDRESS>:10000
Addestramento del modello
Per il training useremo il notebook ufficiale di Unsloth dedicato a Llama 3.1 8B.
1. Rimuovere l’installazione dei pacchetti PIP
Dato che abbiamo già configurato un ambiente Conda Unsloth perfettamente funzionante, il primo passo è rimuovere dal notebook i comandi di installazione PIP.
2. Adattare la struttura del prompt a Llama 3.1
Il notebook originale di Unsloth usa il dataset Alpaca e la relativa struttura di prompt a scopo dimostrativo. Per ottenere i risultati migliori con un modello Llama 3.1 sottoposto a fine-tuning, è fondamentale usare esattamente la stessa struttura di prompt con cui il modello è stato addestrato.
Il modello meta-llama/Meta-Llama-3.1-8B-Instruct usa la seguente struttura di prompt:
| Token | Descrizione |
|---|---|
| <|begin_of_text|> | Segna l’inizio del prompt |
| <|end_of_text|> | Il modello smette di generare altri token |
| <|start_header_id|> <|end_header_id|> | Delimitano il ruolo di un messaggio specifico (system, user, assistant, ipython) |
| <|eom_id|> | Fine del messaggio: segnala che serve una chiamata a uno strumento |
| <|eot_id|> | Fine del turno: segnala che il modello ha concluso la risposta |
| <|python_tag|> | Tag speciale nella risposta del modello per indicare una tool call |
Notate che non aggiungiamo il token <|begin_of_text|> alla struttura del prompt, perché viene inserito automaticamente dal tokenizer.
3. Addestrare solo sulla completion
Durante il training di un LLM può emergere un problema noto come "overfitting sull’input". Succede perché i moderni LLM, essendo modelli decoder-only, apprendono la probabilità di ciascun token sulla base di tutti i token precedenti, compresi quelli presenti nell’input. Se lo stesso input compare molte volte nel dataset, il modello può finire per apprendere quella struttura invece di concentrarsi davvero sulla qualità della risposta.
Per ridurre questo rischio, la libreria Transformers consente di addestrare il modello solo sulla completion, cioè sulla risposta generata dall’IA. In questa modalità il modello continua a vedere sia input sia output, ma l’aggiornamento dei pesi avviene solo sulla parte di output.
Per attivare questa modalità, importate DataCollatorForCompletionOnlyLM e configuratelo con il pattern di testo che identifica la parte di risposta:
from trl import SFTTrainer, DataCollatorForCompletionOnlyLM

response_template = "<|start_header_id|>assistant<|end_header_id|>"
collator = DataCollatorForCompletionOnlyLM(response_template, tokenizer=tokenizer)
Il training si conclude in 1 minuto e 39 secondi e richiede 14,5 GB di memoria GPU.
4. Inferenza
La sequenza di Fibonacci è un compito piuttosto semplice, ma basta come test di base per verificare che il modello funzioni correttamente. Vale la pena ricordare che il dataset Alpaca probabilmente faceva già parte dei dati di training originari di Llama 3.1. Quando però usate un dataset proprietario, il training può migliorare sensibilmente le prestazioni del modello su compiti più complessi e specifici.
Trovate il codice completo di questo tutorial nel nostro Colab.
Limiti
Sebbene Unsloth offra una soluzione molto efficace per molti problemi di training, la versione gratuita presenta comunque alcuni limiti.
- The free version is only compatible with Unsloth-modified models. Although the Unsloth team works diligently to support the most popular and advanced models, more specialized or niche models may not yet benefit from Unsloth’s optimizations.
- Unsloth does not support multi-GPU training. If you hit the GPU memory limit, even with Unsloth’s memory-efficient training, you may need to explore alternative options, as there’s no way to distribute the load across multiple GPUs.
- Unsloth offre inoltre il supporto nativo a RoPE (Rotary Positional Encoding) scaling, che consente di estendere la finestra di contesto oltre la dimensione originale. Al momento, però, solo pochi modelli supportano davvero il RoPE scaling con Unsloth.
Conclusione
Sviluppare un vostro LLM personalizzato può migliorare sicurezza dei dati e compliance, oltre a creare un vantaggio competitivo concreto per il vostro prodotto. Per approfondire, date un’occhiata anche a questi articoli:
- Low-Rank Adaptation (LoRA) per il fine-tuning efficiente dei large language model
- Perché vi serve una strategia AI? L’IA come vantaggio competitivo
- Strategie AI che creano un vantaggio competitivo sostenibile
- Start with the Right AI Development Culture
Cercate un fine-tuning di LLM rapido ed efficiente nei costi?
Valutiamo insieme il framework di fine-tuning più adatto al vostro caso d’uso e costruiamo un modello personalizzato capace di darvi un vero vantaggio competitivo.