
Buy vs. Build: Die optimale KI-Entscheidung
Es gibt heute viele KI-Dienste und -Produkte: OpenAIs ChatGPT und GPT-4, Anthropics Claude, AWS Bedrock, Azure OpenAI, Google Cloud Vertex AI, Open-Source-Modelle auf Huggingface und mehr. Sollten Sie diese Dienste über ihre APIs nutzen? Sollten Sie Open-Source-Modelle bereitstellen? Oder sollten Sie Ihr eigenes KI-Modell trainieren? Lassen Sie uns diese Optionen erkunden.
Die Buy-vs.-Build-Entscheidung
Die Wahl zwischen Kaufen und Bauen von Technologie ist eine Schlüsselentscheidung für das Management. Sie beeinflusst Entwicklungsaufwände, zukünftige Supportkosten sowie potenzielle Risiken und Einschränkungen. Kaufen – die Nutzung eines fertigen Produkts oder einer Drittanbieter-API – bedeutet, dass Sie sofort profitieren können, im Gegensatz zu den verzögerten Vorteilen des Selbstbauens. Bei gekauften Technologien sind die Entwicklungsrisiken minimal und der Supportaufwand gering. Oft ist Kaufen auch im großen Maßstab günstiger, wenn man die Supportkosten hauseigener Lösungen berücksichtigt. Warum also überhaupt den Bau eigener Technologie erwägen?
Wettbewerbsvorteil aufbauen
Technologische Innovationen können Prozesse beschleunigen, Kosten senken und Ihr Ergebnis verbessern – denken Sie an neue Datenbanken, Cloud-Services oder bessere Laptops für Mitarbeiter. KI kann dies ebenfalls. Im Gegensatz zu Datenbanken oder Cloud-Technologien kann KI jedoch einen Wettbewerbsvorteil bieten, indem sie Ihr Produkt schwerer kopierbar macht.
Moderne KI basiert auf maschinellem Lernen, das Daten und Algorithmen kombiniert – die Modellarchitektur, das Trainingssetup und so weiter. Wir trainieren Machine-Learning-Modelle mit Daten, um das endgültige, trainierte Modell zu erzeugen. In dieser Kombination sind Daten von überragender Bedeutung.
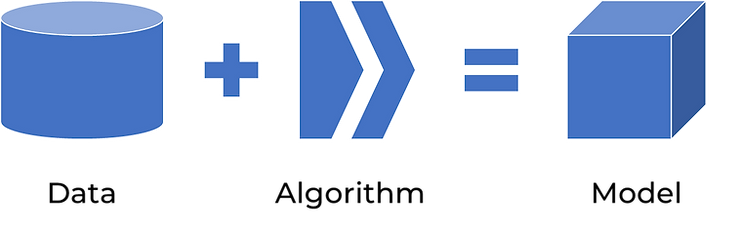
Stellen Sie sich zwei Unternehmen vor, A und B, die beide ihre eigenen KI-Modelle trainieren möchten. Unternehmen A investiert stark in hauseigene Forschung und entwickelt proprietäre neuronale Netzwerkarchitekturen mit öffentlich verfügbaren Datensätzen. Unternehmen B hingegen investiert in die Generierung und den Erwerb großer, hochwertiger proprietärer Datensätze und plant, eine Open-Source-Architektur mit diesen Daten zu trainieren. Welches Unternehmen wird das bessere Modell haben?
Die Antwort ist Unternehmen B. Hochwertige Daten überwiegen das Algorithmus-Design. Das Training eines unterlegenen Algorithmus mit überlegenen Daten ergibt ein besseres Modell als das Training eines überlegenen Algorithmus mit unterlegenen Daten.
Betrachten Sie die folgende Produktstrategie:
- Ihr Produkt generiert Daten aus Nutzerinteraktionen.
- Sie nutzen diese Daten zum Training Ihrer KI-Modelle.
- Ihre KI-Modelle verbessern Ihr Produkt.
- Das verbesserte Produkt zieht mehr Nutzer an und generiert mehr Daten.
Dies erzeugt eine positive Feedbackschleife \u2013 einen Netzwerkeffekt. Je mehr Nutzer Sie haben, desto besser werden Ihre KI-Modelle. Und je besser Ihre Modelle, desto mehr Nutzer ziehen Sie an. Mit diesem Ansatz haben Produkte wie Google Search und YouTube ihre Marktanteile im dreistelligen Milliardenbereich erobert.
Buy vs. Build in der KI
Bei der Entscheidung, ob Sie KI-Lösungen kaufen oder bauen, ist es entscheidend, Ihre Geschäftsziele zu definieren. Streben Sie an, Prozesse zu beschleunigen, Kosten zu senken und Ihr Ergebnis zu verbessern? Oder möchten Sie Ihr Produkt schwerer kopierbar machen und einen Wettbewerbsvorteil erlangen?
Wenn Ihr Ziel die Verbesserung des Ergebnisses ist: Kaufen
Zur Optimierung von Kosten und Time-to-Market sollten Sie kaufen erwägen. Nutzen Sie fertige Produkte und APIs wie GPT-4 und Claude wann immer möglich. Wenn Datensicherheit ein Anliegen ist, stellen Sie Open-Source-Modelle wie Llama 3.2 und Mistral auf Ihrer privaten Cloud oder On-Premises-GPU-Servern bereit. Erwägen Sie das Training eigener KI-Modelle nur, wenn nichts Vergleichbares auf dem Markt verfügbar ist, und bevorzugen Sie dann Low-Code- oder No-Code-Modelltrainingsplattformen.
Wenn Ihr Ziel ein Wettbewerbsvorteil ist: Bauen
Wenn Sie Ihr Produkt schwerer kopierbar machen möchten, ist der Aufbau eigener KI der richtige Weg. Die Etablierung Ihres eigenen tugendhaften KI-Kreislaufs erfordert enge Zusammenarbeit zwischen Ihrem Produkt- und KI-Team. Sie müssen sicherstellen, dass Ihr Produkt die richtigen Daten sammelt und dass Ihre KI-Modelle die Produktqualität verbessern, um mehr Nutzer anzuziehen.
Regelmäßiges Nachtrainieren Ihrer Modelle – vielleicht wöchentlich oder monatlich – ist unerlässlich. Dies bedeutet den Aufbau hauseigener Praktiken für Daten-Monitoring und -Bereinigung, Modelltraining, Qualitätssicherung, Überwachung und Support.
Da Ihre Daten zu Ihrem Schlüsselwert und der Grundlage Ihres Wettbewerbsvorteils werden, sollten Sie sie nicht mit Drittanbieter-APIs oder -Produkten teilen. Schließlich kann man einen Wettbewerbsvorteil nicht von der Stange kaufen.
Weiterlesen
- Sie möchten KI für Ihr Unternehmen erkunden – wo fangen Sie an?
- Alles, was Sie brauchen, ist ein Netzwerkeffekt
- KI-Strategien für einen nachhaltigen Wettbewerbsvorteil
Kaufen oder selbst bauen? Die Antwort hängt von Ihrer Strategie ab.
Lassen Sie uns analysieren, welche KI-Komponenten Sie intern entwickeln und welche Sie sicher auslagern können — ohne Ihren Wettbewerbsvorteil zu verlieren.