
Schafft ChatGPT einen Wettbewerbsvorteil?
Sergii Shelpuk · Geschäftsführender Partner
In den letzten sechs Monaten hat ChatGPT das Internet im Sturm erobert. Dieses Top-Produkt von OpenAI hat in nur fünf Tagen die Marke von einer Million Nutzern überschritten und damit einen neuen Rekord unter Internet-Produkten aufgestellt. In den sozialen Medien und seriösen Quellen wird lebhaft darüber diskutiert, ob ChatGPT und ähnliche Technologien ganze Branchen umwälzen und den Arbeitsplatz revolutionieren werden.
Nun stellt sich die Frage: Bietet ChatGPT Ihrem Unternehmen einen Wettbewerbsvorteil? Oder sollten Sie sich Sorgen machen, dass Ihre Konkurrenten mithilfe von ChatGPT einen Teil Ihres Marktanteils erobern könnten? Lassen Sie uns dieser Frage auf den Grund gehen.
Kann ChatGPT einen Wettbewerbsvorteil für Ihr Unternehmen aufbauen?
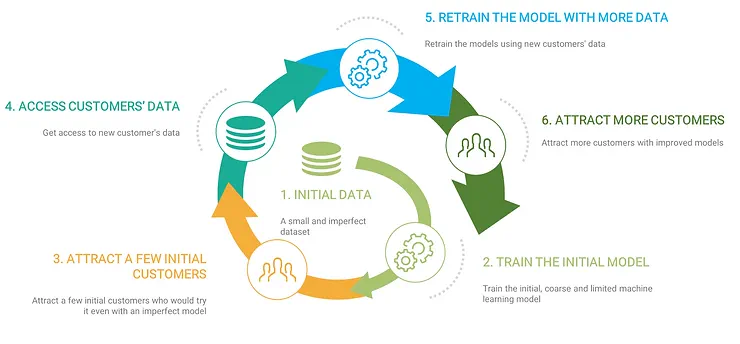
Der Schlüssel zu einem nachhaltigen Vorteil liegt im Besitz von etwas, das nicht leicht kopiert werden kann: Vermögenswerte, Verbindungen, Reputation, Marke oder ein einzigartiges Geschäftsdesign. In den letzten Jahrzehnten haben Machine Learning und KI-Technologien Anerkennung dafür erlangt, Daten in einen nachhaltigen Wettbewerbsvorteil zu verwandeln. Dieser Prozess funktioniert in einem Kreislauf: KI hat die Fähigkeit, Ihre proprietären Daten in einen wahrgenommenen Wert für Ihr Produkt umzuwandeln. Mit steigendem wahrgenommenem Wert wächst auch die Menge der proprietären Daten, wodurch ein positiver Rückkopplungskreislauf entsteht, der in einem Produkt kulminiert, das extrem schwer zu imitieren ist. Die optimale Wettbewerbspositionierung für ein KI-Produkt lässt sich wie folgt visualisieren:
- Sie müssen ein überlegenes Produkt anbieten, um Marktanteile von einem KI-Produkt zu erobern.
- Da der Wert aus KI-Modellen stammt, benötigen Sie bessere Modelle.
- Da moderne KI-Modelle mit Machine Learning auf Daten trainiert werden, benötigen Sie mehr Daten.
- Da die Daten aus der Produktnutzung stammen, benötigen Sie ein verbessertes Produkt.
Dieses strategische Design schreckt Wettbewerber wirksam ab, selbst bei Produkten wie Google Search und YouTube, die, wenn sie reproduzierbar wären, ein Unternehmen in den Billionen-Dollar-Bereich katapultieren würden. Dennoch bleibt ihre Marktposition heute unerschütterlich: Potenzielle Konkurrenten erkennen entweder die Aussichtslosigkeit des Kampfes, bevor er beginnt, oder lernen es auf die harte Tour durch vergebliche Versuche.
Kehren wir nun zu ChatGPT zurück, einem OpenAI-Produkt in seiner aktuellen Form. Wo passt es in diesen Kreislauf?
Ein KI-System sollte seine Leistung mit mehr Daten verbessern, wenn es weiter trainiert wird. ChatGPT ist jedoch ein unveränderliches Produkt — Sie können es nicht mit Ihren proprietären Daten trainieren. Prompt Engineering gleicht eher dem Programmieren als dem Machine-Learning-Training, was bedeutet, dass Ihre Prompts genauso leicht von qualifizierten Ingenieuren oder sogar von einem Ihrer Konkurrenten kopiert werden können. Aus dieser Perspektive können Sie ChatGPT mit einer ausgeklügelten Tabellenkalkulation vergleichen — es kann Wert liefern und Zeit sparen, schafft aber keinen nachhaltigen Wettbewerbsvorteil für Ihr Unternehmen.
Um einen Wettbewerbsvorteil aufzubauen, sollte Ihr KI-System mit proprietären Daten trainiert werden — Daten, die Ihr Unternehmen besitzt und die für Wettbewerber schwer zu beschaffen sind. Das macht Ihr KI-System anders als das, welches Ihre Konkurrenten ohne Zugang zu Ihren Daten trainieren können.
Alles, was Sie an ChatGPT senden, landet in den Datensätzen von OpenAI und trägt zur Produktleistung bei — nicht nur für Ihr Unternehmen, sondern für alle Ihre Konkurrenten, die bereit sind, 20 Dollar pro Monat für den Zugang zu einem Tool zu zahlen, das Zugriff auf Ihre proprietären Daten hat. Das Extrahieren von Trainingsdaten aus Sprachmodellen ist eine fortlaufende Herausforderung, und Sie sollten alle Daten, die Sie mit ChatGPT teilen, als im Wesentlichen für die ganze Welt offen betrachten. Wenn Sie Ihre proprietären Daten an ChatGPT übermitteln, tun Sie das Gegenteil davon, sie in einen Wettbewerbsvorteil umzuwandeln — Sie geben Ihre proprietären Daten preis.
Zusammenfassend lässt sich sagen: ChatGPT ist ein KI-Produkt, das Sie nicht durch Training mit Ihren eigenen Daten anpassen können. Obwohl OpenAI das Modell verbessern kann, indem es Ihre proprietären Daten nutzt, stellt es diese Vorteile (und potenziell Ihre proprietären Daten) nicht nur Ihnen, sondern auch all Ihren Konkurrenten zur Verfügung.
Sie können und sollten ChatGPT nutzen, um die Effizienz dort zu steigern, wo es anwendbar ist. Es sollte jedoch nicht mit KI-Technologien verwechselt werden, die das Potenzial haben, Ihr Unternehmen zum Marktführer in Ihrer Branche zu machen — diese Rolle kann ChatGPT nicht erfüllen.
Large Language Models (LLMs)
Es ist offensichtlich, dass ChatGPT allein keinen Wettbewerbsvorteil bieten kann. Aber was ist mit anderen Large Language Models? Ist es möglich, ein eigenes ChatGPT-ähnliches System zu entwickeln und den KI-Tugendkreislauf in Gang zu setzen?
Untersuchen wir die Technologien, die Möglichkeiten für KI-Wettbewerbsvorteile eröffnen. An erster Stelle stehen jene, die den Aufbau dieses Tugendkreislaufs mit neuen Datentypen ermöglichen. Der „Heureka“-Moment kam mit AlexNet beim ImageNet-Wettbewerb 2012, als konvolutionelle neuronale Netze ein Niveau erreichten, das es ihnen erlaubte, Wert aus riesigen Datensätzen realer Bilder zu extrahieren — eine Herausforderung, mit der frühere Computer-Vision-Algorithmen basierend auf Feature-Extraktoren zu kämpfen hatten. Einfach ausgedrückt zeigte es, dass man ein nachhaltiges und verteidigungsfähiges Geschäft mit einem Produkt aufbauen kann, das reale Fotos sammelt und sie zur Selbstverbesserung mit konvolutionellen neuronalen Netzen nutzt. Diejenigen, die dieses Konzept früh begriffen, identifizierten schnell anwendbare Nischen und nutzten sie. Ein hervorragendes Beispiel ist Blue River Technology, das kurz nach dem Durchbruch von AlexNet entstand und die neu verfügbaren konvolutionellen neuronalen Netze auf Bilder von landwirtschaftlichen Feldern anwendete.
Kehren wir nun zu Large Language Models (LLMs) zurück. Ermöglichen sie den Tugendkreislauf der KI für neue Datentypen?
Das LLM, ähnlich wie ChatGPT, durchläuft das Training in drei Phasen.
In der ersten Phase wird ein Sprachmodell entwickelt, indem das Transformer-Modell darauf trainiert wird, das nächste Wort basierend auf dem vorhergehenden Text einer bestimmten Länge vorherzusagen (bei ChatGPT waren es 2048 Wörter). In dieser Phase kann das Modell den Eingabetext automatisch vervollständigen, ist aber nicht in der Lage, einen Dialog zu führen oder auf Anfragen zu antworten.
In der zweiten Phase trainieren Sie das Modell auf einem kleinen, hochwertigen „Frage-Antwort“-Datensatz, um Benutzeranfragen zu beantworten. Das resultierende Modell wird SFT-Modell (Supervised Fine-Tuning) genannt.
Die dritte Phase ist Reinforcement Learning from Human Feedback (RLHF). Vereinfacht gesagt geht es darum, das LLM aufzufordern, verschiedene Antworten zu bewerten, um deren Nähe zum erwarteten Ergebnis widerzuspiegeln. RLHF verwandelt das LLM im Wesentlichen in den chatähnlichen Assistenten, den wir heute kennen.
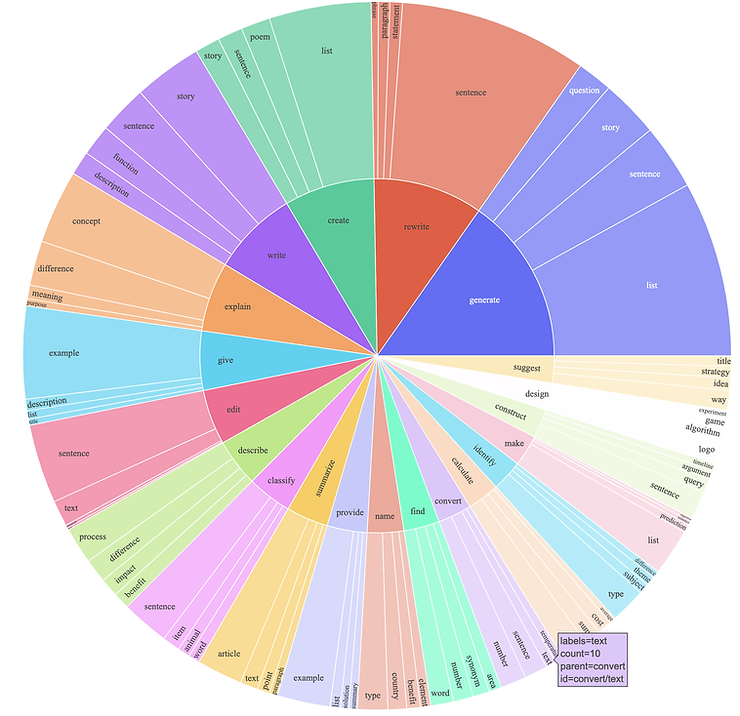
Eröffnet eine dieser Technologien neue Nischen, indem sie neue Datentypen ermöglicht, ähnlich wie der Durchbruch von AlexNet?
Das Training des LLM zur Vorhersage des nächsten Wortes kann ein anspruchsvolles und kostspieliges Unterfangen sein. Die geschätzten Trainingskosten für das Training des GPT3-Modells von Grund auf übersteigen 4 Millionen Dollar, und die Trainingszeit kann bis zu 9 Tage betragen. Nur sehr wenige Unternehmen können sich solche Ausgaben regelmäßig leisten (denken Sie daran, dass das Modell regelmäßig neu trainiert werden muss, um von neuen proprietären Daten zu profitieren). Zudem ist ein Modell, das nur das nächste Wort vorhersagt, selbst wenn es mit proprietären Daten trainiert wurde, von begrenztem Nutzen. Sie müssen noch Chat-Funktionen durch RLHF ermöglichen.
Hier liegt eine faszinierende Chance: „Frage-Antwort“ (SFT)-Training und RLHF-Technologie können tatsächlich einen nachhaltigen Wettbewerbsvorteil aufbauen.
Wenn Sie sich ein Produkt vorstellen können, das durch Chat- oder Assistenzfunktionen Wert liefert und gleichzeitig RLHF-anwendbare Daten aus Benutzerinteraktionen generiert, könnten Sie auf etwas Bedeutendes gestoßen sein.
Auf diese Weise verbessert sich Ihr Produkt mit neuen „Frage-Antwort“- oder Antwortqualitätsdaten und generiert wiederum mehr Trainingsdaten, wenn es seine Leistung steigert.
Die Größe dieser Chance ist schwer zu bestimmen. Es gibt spezifische Nischen, in denen solches Feedback gewonnen werden kann, hauptsächlich im Markt für Schreibhilfen, in dem Unternehmen wie Grammarly tätig sind. Wie leicht LLM-Technologien diesen offensichtlichen Markt aufbrechen können, bleibt abzuwarten. Wenn Sie jedoch Ihre eigene LLM-basierte Startup-Idee oder die eines anderen bewerten möchten, stellen Sie sich zwei Fragen:
- Wie bringen LLM-Verbesserungen mehr Wert für die Nutzer?
- Wie generieren Nutzer Trainingsdaten bei der Produktnutzung?
Wenn mindestens eine dieser Fragen keine gute Antwort hat, stehen die Chancen schlecht, ein verteidigungsfähiges Geschäft um diese Idee aufzubauen.
Wettbewerb unter LLMs
Seit dem explosiven Debüt der LLMs sind prominente Tech-Giganten in den Ring gestiegen. Microsoft investierte satte 10 Milliarden Dollar in OpenAI und integrierte ChatGPT in seine Bing-Suchmaschine. Google stellte Bard vor, während Meta das LLaMA Large Language Model als Open Source veröffentlichte. Viele betrachten LLMs als potenziellen Disruptor im Online-Suchmarkt, einem Bereich, der lange von Google Search dominiert wurde. Um ihre Bemühungen besser zu verstehen, wenden wir die Logik des Wettbewerbsvorteils an.
Rückkopplungsschleife
ChatGPT zeigt bemerkenswerte Kompetenz in verschiedenen Aufgaben, einschließlich Programmierung — ein Thema, das häufig Debatten über die Automatisierung der Softwareentwicklung auslöst. Diese Fähigkeiten hängen jedoch stark von RLHF-Trainingsdaten ab. OpenAI beschäftigt beispielsweise Softwareingenieure, die sich der Produktion solcher Daten widmen, indem sie Programmieraufgaben lösen und detaillierte Erklärungen in menschlicher Sprache liefern. Zusätzlich engagiert das Unternehmen eine beträchtliche Anzahl von Datenannotatoren, um andere Formen von RLHF-Trainingsdaten zu erstellen. Es gibt Gerüchte, dass Google RLHF-Daten aus ChatGPT extrahiert, um eigene LLMs zu trainieren. Aus der Perspektive des KI-Wettbewerbsvorteils haben diese Ansätze jedoch inhärente Schwächen.
Während manuelle Datenannotation erhebliche Trainingsdaten liefern kann, kann ein Produktdesign, das RLHF-Daten direkt durch Benutzerinteraktionen als Teil ihrer Journey generiert, die manuelle Annotation durch eine stärkere Rückkopplungsschleife übertreffen.
OpenAI hat versucht, dies durch die Einführung einer „Gefällt mir/Gefällt mir nicht“-Funktion in ChatGPT zu adressieren. Allerdings ist das Bewerten von Chat-Antworten kein wesentlicher Aspekt der User Journey — ich kann vom Produkt profitieren, ohne explizit meine Präferenz auszudrücken.
Datenzugang
Darüber hinaus sollte ein robuster KI-Wettbewerbsvorteil auf proprietären Daten aufgebaut werden, die für Wettbewerber schwer zu beschaffen sind. Die Dominanz von Google Search beruht weitgehend darauf, unsere historischen Suchanfragen und Interaktionen zu nutzen, ergänzt durch riesige Datenmengen, die über verschiedene Alphabet-Produkte gesammelt werden. Unsere Gmail-E-Mails, YouTube-Suchen, Aufrufe und Interaktionen, Browsing-Daten von Google Chrome und sogar Telefonnutzungsdaten von Android-Geräten tragen alle zu den ausgefeilten Nutzermodellen und Embeddings bei, die Google für jede Person sorgfältig erstellt. Diese personalisierten Nutzermodelle, kombiniert mit unseren Suchanfragen, ermöglichen es Google Search, maßgeschneiderte und relevante Ergebnisse zu präsentieren. Wenn die Suchergebnisse besser werden, kehren wir natürlich zu Google zurück, was dem Unternehmen noch mehr Daten liefert, um unsere individuellen Nutzermodelle zu bereichern. Die Stärke der KI-Produkte von Alphabet stammt aus diesem exklusiven Datensatz. Der Versuch, Google Search zu replizieren, ist genau aufgrund des fehlenden Zugangs zu diesen Daten zum Scheitern verurteilt.
Besitzt OpenAI, Google oder ein anderes Unternehmen einzigartige Trainingsdaten oder ein Produktdesign, das diese generiert? Kaum.
Open-Source-Alternativen
Betrachten Sie das blühende Ökosystem von Open-Source-LLMs und LLM-Chats, das in den letzten sechs Monaten entstanden ist. Es gibt Hunderte von Open-Source-LLMs, von denen viele kommerziell genutzt werden können. Diese Modelle sind kleiner, kostengünstiger zu trainieren und, was am wichtigsten ist, anpassbar — da der Wettbewerbsvorteil in einem einzigartigen Modell liegt. Open-Source-Vortrainings- und RLHF-Datensätze sind leicht verfügbar, und täglich entstehen neue Entwicklungen. In diesem Umfeld besitzt weder OpenAI noch Google noch Microsoft eine besondere Asymmetrie, die es ihnen ermöglichen würde, überlegene LLMs zu erstellen und gleichzeitig schwer von anderen Unternehmen oder sogar einzelnen Ingenieuren replizierbar zu sein.
Interessanterweise scheint sogar Google, ein Unternehmen, das sich bestens mit dem Aufbau von KI-Wettbewerbsvorteilen auskennt, diese Realität anzuerkennen. In einem geleakten Dokument räumt der Google-Senior-Softwareingenieur Luke Sernau ein, dass Google keinen Wettbewerbsvorteil bei der Entwicklung von LLMs hat. Das Dokument stellt fest: „Die unbequeme Wahrheit ist, dass wir nicht in der Position sind, dieses Wettrüsten zu gewinnen, und OpenAI auch nicht. Während wir uns gestritten haben, hat eine dritte Fraktion stillschweigend unser Mittagessen gegessen... Ich spreche natürlich von Open Source.“ Sernau schlägt vor, dass ohne eine „Geheimzutat“ Googles bester Ansatz darin bestehe, von externen Bemühungen zu lernen und mit ihnen zusammenzuarbeiten, während Drittanbieter-Integrationen priorisiert werden. Sernau sagte, Open-Source-Ingenieure machten Dinge mit 100 Dollar, mit denen „wir bei 10 Millionen Dollar kämpfen“, „und das in Wochen, nicht Monaten.“
Zusammenfassend scheint die Entwicklung allgemeiner LLMs jenseits der Kontrolle eines einzelnen großen Unternehmens zu liegen, selbst der größten. Derzeit scheint keines von ihnen eine narrensichere Strategie zu besitzen, um seine Position zu festigen — einschließlich Google, das sich erfolgreich mit Search, YouTube und zahlreichen kleineren Produkten etabliert hat.
Noch einmal bestätigt dies meinen früheren Vorschlag: Eine Nische zu finden, in der LLMs einen nachhaltigen Wettbewerbsvorteil aufbauen können, der nicht schnell repliziert werden kann, ist unglaublich schwierig.
Was sollten Sie tun?
Nachdem ich meine Karriere in der KI lange vor dem aktuellen Hype und sogar vor dem „AlexNet-Moment“ von ImageNet 2012 begonnen habe, kann ich mit Sicherheit sagen, dass der aktuelle ChatGPT-Hype selbst jemanden wie mich überwältigt, der auf dem Gebiet bewandert ist. Ich kann mir nur vorstellen, wie es für diejenigen außerhalb der Branche aussieht, wobei dieser immense Buzz bei vielen Menschen Angst und die Furcht, etwas zu verpassen, erzeugt. Seit dem Start von ChatGPT haben sich zahlreiche Freunde und Kollegen an mich gewandt und um Rat gefragt, ob sie sich um ihr Geschäft oder sogar ihre Karriere sorgen sollten.
Erlauben Sie mir, Ihnen ein Denkmodell für die aktuelle LLM-Entwicklung an die Hand zu geben.
Eine gute Analogie ist tausend Worte wert: Betrachten Sie LLMs wie die IBM-PC-Welle der 1980er und 1990er Jahre.
Personal Computer wurden in diesen Jahrzehnten enorm populär, hauptsächlich dank Textverarbeitungs- und Tabellenkalkulationssoftware, die Routineaufgaben vereinfachte. Bis 1984 überstiegen IBMs Einnahmen aus dem PC-Markt 4 Milliarden Dollar — mehr als das Doppelte von Apple. Eine Studie aus dem Jahr 1983 ergab, dass zwei Drittel der großen Kunden, die sich auf einen Computer standardisierten, sich für den PC entschieden, während nur 9 % Apple wählten. Eine Fortune-Umfrage von 1985 ergab, dass 56 % der amerikanischen Unternehmen mit Personal Computern PCs nutzten, während 16 % Apple verwendeten.
Allerdings führte eine Reihe von Fehlern beim Schutz des geistigen Eigentums seitens IBM zur Entstehung der gesamten „IBM-PC-kompatiblen“ Klon-Industrie. Dies war verheerend für IBM, aber für die Tech-Welt wurden der IBM PC und seine Klone zu einem der bedeutendsten Ereignisse der Geschichte.
Wenn Sie ein Geschäftsführer sind, der über den ChatGPT-Hype nachdenkt, versetzen Sie sich in die Lage Ihrer Kollegen, die die PC-Ära miterlebt haben. PCs waren zweifellos eine großartige Innovation, die viele Routineaufgaben automatisierte, die Buchhaltung vereinfachte und Schreibmaschinen ersetzte. Allerdings waren diese Maschinen auch erschwinglich und leicht verfügbar.
Würden Sie erwarten, dass ein Wettbewerber oder ein junges Startup Sie vom Markt verdrängt, einfach weil PCs am Arbeitsplatz eingeführt werden? Für die meisten lautet die Antwort: kaum. Schließlich können Sie diese Computer jederzeit für Ihr eigenes Unternehmen anschaffen. Sie mögen Ihr Geschäft verbessern, aber sie sind keine Bedrohung für Ihren Marktanteil.
Und wenn Sie Unternehmer sind und über ein neues Geschäft nachdenken, seien Sie gewarnt: Die IBM-PC-Klon-Industrie der 1980er und 1990er Jahre hatte unglaublich niedrige Gewinnmargen.
Zwar konnten Sie Ihre eigenen Computer aus leicht verfügbaren IBM-PC-kompatiblen Komponenten zusammenbauen und verkaufen, aber das konnte jeder andere auch. In einem solchen Szenario ist der einzige Weg, über den Preis zu konkurrieren, was letztendlich Sie und alle anderen auf dem Markt zu extrem dünnen Gewinnmargen führt.
Lassen Sie sich jedoch von Microsoft inspirieren, das Betriebssysteme für IBM PCs entwickelte und Windows schließlich in eine der erfolgreichsten Plattformen aller Zeiten verwandelte. Wenn Sie ein Produkt schaffen können, das jeder LLM-Nutzer braucht, und es mit dem Konzept des nachhaltigen Wettbewerbsvorteils aufbauen, könnten Sie im Laufe der Zeit ein florierendes Unternehmen aufbauen. Aber das ist eine andere Geschichte.
Dieser Blog widmet sich dem Thema KI-Wettbewerbsvorteil, und wir tun unser Bestes, um zu erklären, wie er funktioniert und wie Sie einen für Ihr Produkt oder Unternehmen aufbauen können. Lesen Sie unsere anderen Beiträge für eine ausführliche Erklärung darüber, was der Netzwerkeffekt ist und wie KI ihn ermöglicht, wie Sie einen KI-Wettbewerbsvorteil für Ihr Unternehmen aufbauen, welche Kultur Ihnen hilft, die richtigen KI-Produkte zu bauen, was Sie in Ihrer KI-Strategie vermeiden sollten und mehr.
Brauchen Sie Hilfe beim Aufbau eines KI-Wettbewerbsvorteils?
Unser Team aus Geschäftsexperten und KI-Technologieberatern verfügt über jahrelange Erfahrung darin, Technologieunternehmen wie Ihrem zu helfen, nachhaltige Wettbewerbsvorteile durch KI-Technologie aufzubauen.