
Llama 3.1 mit Unsloth: doppelt so schnell
Das Fine-Tuning großer Sprachmodelle (LLMs) auf Lern- oder kleinen Datensätzen kann unkompliziert sein. Bei kommerziellen Anwendungen mit langen Eingabesequenzen oder großen Ausgaben wächst die Herausforderung jedoch exponentiell. Selbst mit fortschrittlichen Techniken wie QLoRA können Sie mit nur einem Trainingsbeispiel an die Grenzen einer 80-GB-GPU (wie der H100 oder A100) stoßen. Darüber hinaus kann das Fine-Tuning mit langen Eingabedaten frustrierend langsam sein.
Gl\u00FCcklicherweise gibt es eine L\u00F6sung, die sowohl Zeit als auch Ressourcen spart: Unsloth. Dieser Beitrag stellt Ihnen Unsloth vor, zeigt Ihnen, wie Sie es auf GPU-Cloud-Plattformen wie Vast AI, MassedCompute und RunPod installieren und nutzen, und teilt Best Practices, die \u00FCber die offizielle Dokumentation hinausgehen.
Was ist Unsloth?
Unsloth ist eine kostenlose, quelloffene Bibliothek unter Apache-2.0-Lizenz, die für effizientes LLM-Fine-Tuning entwickelt wurde. Sie ist 2,2-mal schneller als die Standard-Huggingface-Transformers-Bibliothek, verbraucht 70 % weniger GPU-Speicher und behält die Genauigkeit bei QLoRA (4-Bit) und LoRA (16-Bit) Fine-Tuning bei. Zusätzlich verdoppelt sie die Inferenzgeschwindigkeit.
Falls das zu gut klingt, um wahr zu sein: Der Bereich des LLM-Fine-Tunings ist noch jung und entwickelt sich weiter, was oft zu Ineffizienzen führt. Unsloth adressiert diese Ineffizienzen und verbessert Speichernutzung und Trainingsleistung.
Die Codebasis der Bibliothek ist gut geschrieben und übersichtlich, sodass Sie leicht verstehen können, wie sie Ihr Modell optimiert. Im Wesentlichen eliminiert Unsloth unnötige Berechnungen und harmonisiert Datentypen, um diese beeindruckenden Leistungssteigerungen zu erzielen.
Wir haben Unsloth in unseren Projekten intensiv eingesetzt, und dieser Beitrag spiegelt unsere Erfahrungen von August 2024 wider. Da sich Unsloth schnell weiterentwickelt, empfehlen wir, die offizielle Dokumentation auf aktuelle Updates zu prüfen.
Unsloth installieren
Der Einstieg mit Unsloth kann etwas knifflig sein, besonders bei der Installation. Der Prozess ist nicht so einfach wie erwartet, und der zuverlässigste Weg zur Einrichtung ist die Verwendung einer Conda-Umgebung.
In dieser Anleitung demonstrieren wir die Installation auf einer MassedCompute H100-VM. Diese Schritte sind jedoch auch auf Docker-basierte GPU-Instanzen auf Plattformen wie Vast AI und RunPod anwendbar.
1. VM erstellen
Gehen Sie zunächst zu MassedCompute und erstellen Sie eine neue VM. In diesem Beispiel verwenden wir eine H100-Spot-Instanz, um von niedrigeren Preisen zu profitieren. Beachten Sie jedoch, dass Spot-Instanzen mit nur einer Stunde Vorlauf gekündigt werden können.
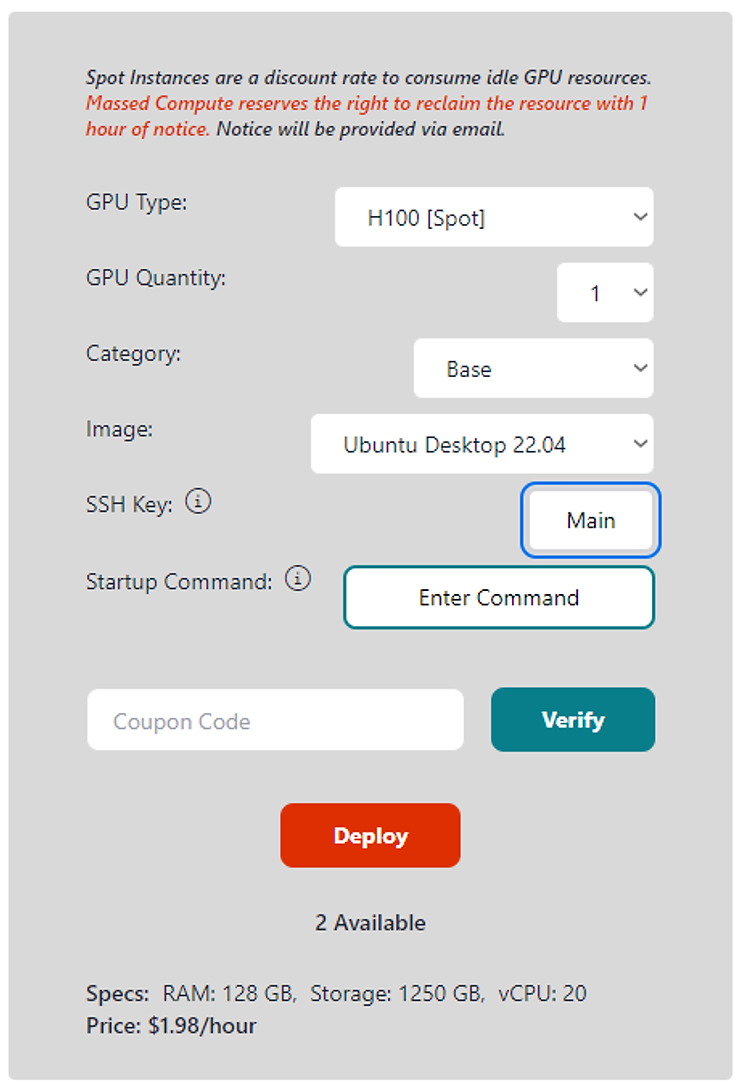
Wählen Sie den Instanztyp „Base“ und das OS-Image „Ubuntu Desktop 22.04“, dann klicken Sie auf „Deploy“.
2. Pakete aktualisieren
Aktualisieren Sie als Nächstes die Basispakete, installieren Sie die Huggingface-CLI und authentifizieren Sie sich mit Ihrem Huggingface-Token.
sudo apt update
sudo apt upgrade -y
sudo apt install python3-pip -y
python3 -m pip install --upgrade pip
pip3 install packaging huggingface_hub[cli]
export PATH=$PATH:~/.local/bin
huggingface-cli login --token hf_<YOUR HUGGINGFACE TOKEN>
3. Conda installieren
mkdir -p /home/Ubuntu/miniconda3
wget https://repo.anaconda.com/miniconda/Miniconda3-latest-Linux-x86_64.sh -O ~/miniconda3/miniconda.sh
bash /home/Ubuntu/miniconda3/miniconda.sh -b -u -p ~/miniconda3
rm -rf /home/Ubuntu/miniconda3/miniconda.sh
/home/Ubuntu/miniconda3/bin/conda init bash
. /home/Ubuntu/.bashrc
4. Conda-Unsloth-Umgebung erstellen
conda create --name unsloth_env python=3.10
conda activate unsloth_env
conda install pytorch==2.2.0 cudatoolkit torchvision torchaudio pytorch-cuda=12.1 -c pytorch -c nvidia
conda install xformers -c xformers
pip install bitsandbytes matplotlib datasets transformers trl peft accelerate sentencepiece
pip install --upgrade --force-reinstall --no-cache-dir git+https://github.com/unslothai/unsloth.git
Falls Sie Weights & Biases verwenden, installieren Sie es ebenfalls:
pip3 install wandb
wandb login
<YOUR WEIGHTS & BIASES TOKEN>
5. Jupyter Notebook installieren und starten
sudo apt-get install nano -y
pip3 install jupyter
jupyter notebook --generate-config
Bearbeiten Sie die Jupyter-Konfiguration, um IP-Adresse und Port festzulegen:
nano ~/.jupyter/jupyter_notebook_config.pyFügen Sie die folgenden Zeilen nach „c = get_config()“ hinzu:
# Set the IP address to '*'
c.NotebookApp.ip = '0.0.0.0'

# Set the port to 10000
c.NotebookApp.port = 10000

# Disable browser opening
c.NotebookApp.open_browser = False
Setzen Sie Ihr Jupyter-Notebook-Passwort und starten Sie es:
jupyter notebook password
jupyter notebook --allow-root
\u00D6ffnen Sie Ihren Browser und navigieren Sie zu http://<VM_IP_ADDRESS>:10000
Modelltraining
Für das Training verwenden wir das Llama 3.1 8B Training-Notebook aus dem offiziellen Unsloth-GitHub-Repository.
1. PIP-Paketinstallation entfernen
Da wir bereits eine voll funktionsfähige Unsloth-Conda-Umgebung eingerichtet haben, entfernen wir als Erstes die PIP-Paketinstallationsbefehle aus dem Notebook.
2. Prompt-Struktur für Llama 3.1 anpassen
Das ursprüngliche Unsloth-Notebook verwendet den Alpaca-Datensatz und seine entsprechende Prompt-Struktur zu Demonstrationszwecken. Für die besten Ergebnisse mit dem feinabgestimmten Llama 3.1-Modell ist es entscheidend, die exakte Prompt-Struktur zu verwenden, mit der das Modell trainiert wurde.
Das meta-llama/Meta-Llama-3.1-8B-Instruct-Modell hat die folgende Prompt-Struktur:
| Token | Beschreibung |
|---|---|
| <|begin_of_text|> | Markiert den Anfang des Prompts |
| <|end_of_text|> | Das Modell hört auf, weitere Tokens zu generieren |
| <|start_header_id|> <|end_header_id|> | Umschließen die Rolle für eine bestimmte Nachricht (system, user, assistant, ipython) |
| <|eom_id|> | Ende der Nachricht – signalisiert, dass ein Tool-Aufruf erforderlich ist |
| <|eot_id|> | Ende des Turns – signalisiert, dass das Modell die Antwortgenerierung abgeschlossen hat |
| <|python_tag|> | Spezielles Tag für Tool-Aufrufe in der Modellantwort |
Beachten Sie, dass wir das <|begin_of_text|>-Token nicht zu unserer Prompt-Struktur hinzuf\u00FCgen, da der Tokenizer es automatisch hinzuf\u00FCgt.
3. Nur auf Completion trainieren
Während des LLM-Trainings gibt es ein potenzielles Problem, bekannt als „Overfitting auf den Input“. Dies geschieht, weil moderne LLMs als Decoder-only-Modelle die Wahrscheinlichkeit jedes Tokens basierend auf allen vorherigen Tokens lernen, einschließlich derer im Modellinput. Wenn derselbe Input mehrfach im Trainingssatz vorkommt, kann das Modell lernen, dass der Input einer bestimmten Struktur folgt.
Um dieses Problem zu mindern, bietet die Transformers-Bibliothek eine Option, das Modell nur auf der Completion (der KI-generierten Antwort) zu trainieren. In diesem Modus generiert das Modell weiterhin sowohl Input als auch Output, aber der Trainingsprozess aktualisiert das Modell nur basierend auf dem Output.
Um diesen Modus zu aktivieren, importieren Sie DataCollatorForCompletionOnlyLM und konfigurieren Sie es mit dem Textmuster, das den Antwortteil identifiziert:
from trl import SFTTrainer, DataCollatorForCompletionOnlyLM

response_template = "<|start_header_id|>assistant<|end_header_id|>"
collator = DataCollatorForCompletionOnlyLM(response_template, tokenizer=tokenizer)
Das Training ist in 1 Minute und 39 Sekunden abgeschlossen. Es benötigt 14,5 GB GPU-Speicher.
4. Inferenz
Während die Fibonacci-Folge eine relativ einfache Aufgabe ist, dient sie als grundlegender Test der Funktionalität des Modells. Es ist wichtig zu beachten, dass der Alpaca-Datensatz wahrscheinlich Teil der ursprünglichen Trainingsdaten für Llama 3.1 war. Wenn Sie jedoch Ihren eigenen proprietären Datensatz verwenden, kann der Trainingsprozess die Leistung des Modells erheblich steigern.
Den vollst\u00E4ndigen Code f\u00FCr dieses Tutorial finden Sie in unserem Colab.
Einschränkungen
Obwohl Unsloth eine leistungsstarke Lösung für viele Herausforderungen bietet, hat die kostenlose Version ihre Einschränkungen.
- Die kostenlose Version ist nur mit Unsloth-modifizierten Modellen kompatibel. Obwohl das Unsloth-Team fleißig daran arbeitet, die populärsten und fortschrittlichsten Modelle zu unterstützen, profitieren spezialisierte oder Nischenmodelle möglicherweise noch nicht von Unsloths Optimierungen.
- Unsloth unterstützt kein Multi-GPU-Training. Wenn Sie an die GPU-Speichergrenze stoßen, müssen Sie alternative Optionen erkunden, da es keine Möglichkeit gibt, die Last auf mehrere GPUs zu verteilen.
- Unsloth bietet auch standardm\u00E4\u00DFig RoPE (Rotary Positional Encoding) Scaling, das es erm\u00F6glicht, das Kontextfenster \u00FCber seine urspr\u00FCngliche Gr\u00F6\u00DFe hinaus zu erweitern. Allerdings unterst\u00FCtzen derzeit nur wenige Modelle RoPE-Scaling mit Unsloth.
Fazit
Die Entwicklung Ihres eigenen benutzerdefinierten LLM könnte die Datensicherheit und Compliance verbessern und einen KI-Wettbewerbsvorteil für Ihr Produkt ermöglichen. Lesen Sie unsere anderen Beiträge für eine ausführliche Erklärung:
- Low-Rank Adaptation (LoRA) für effizientes Fine-Tuning großer Sprachmodelle
- Warum brauchen Sie eine KI-Strategie? KI als Wettbewerbsvorteil
- KI-Strategien für einen nachhaltigen Wettbewerbsvorteil
- Die richtige KI-Entwicklungskultur
Suchen Sie schnelles, kosteneffizientes LLM-Fine-Tuning?
Lassen Sie uns das beste Fine-Tuning-Framework für Ihren Anwendungsfall evaluieren und ein benutzerdefiniertes Modell entwickeln, das Ihnen einen Wettbewerbsvorteil verschafft.