
LLM Practitioner’s Guide: mehrsprachige LLMs
Sie m\u00F6chten ein Large Language Model f\u00FCr Ihre eigene Sprache fine-tunen. Welches Modell sollten Sie verwenden?
Die Welt der Open-Access-LLMs expandiert rasant, wobei kaum eine Woche vergeht, ohne dass ein neuer Benchmark-F\u00FChrer angek\u00FCndigt wird. Zum Zeitpunkt der Erstellung dieses Beitrags hat das Huggingface Open LLM Leaderboard einen neuen Champion gek\u00FCrt: Smaug LLM. Dieses Feld ist unglaublich dynamisch und erinnert an den gesch\u00E4ftigen IBM-PC-Klon-Markt der sp\u00E4ten 1980er bis fr\u00FChen 1990er Jahre.
Trotz der Vielfalt teilen viele dieser Modelle gemeinsame Urspr\u00FCnge. Smaug basiert beispielsweise auf Qwen-72B. W\u00E4hrend Fine-Tuning erhebliche Anpassungen am Verhalten eines Modells erm\u00F6glicht, ist ein Aspekt, den Sie nicht \u00E4ndern k\u00F6nnen, sein Tokenizer.
Wir waren intensiv an der Anpassung, dem Fine-Tuning und dem Deployment verschiedener Open-Access-LLMs beteiligt. In dieser Artikelserie möchten wir unsere Erkenntnisse darüber teilen, was sie können und was nicht, zusammen mit detaillierten Anweisungen und Best Practices für das Fine-Tuning.
LLM Practitioner’s Guide:
- Wie mehrsprachig ist Llama-2 wirklich?
- Wie mehrsprachig sind Falcon, Mistral, Smaug und andere LLMs?
In einem fr\u00FCheren Beitrag haben wir den Llama-2-Tokenizer untersucht und diskutiert, warum er mit bestimmten Sprachen Schwierigkeiten hat. Heute f\u00FChren wir umfassende Tokenizer-Tests an sechs der popul\u00E4rsten LLMs in 12 Sprachen durch. Unser Ziel ist es, herauszufinden, welche Modelle f\u00FCr jede Sprache am anpassungsf\u00E4higsten sind. Wir teilen auch den Quellcode f\u00FCr unsere Experimente, damit Sie jede gew\u00FCnschte Sprache in diesen Benchmark aufnehmen k\u00F6nnen.
Alle Large Language Models (LLMs), ob proprietär wie ChatGPT oder Open-Source, verarbeiten Informationen mithilfe von Zahlen. Um Text zu interpretieren, wandeln diese Modelle ihn zunächst in eine numerische Form um. Die größte Herausforderung in der natürlichen Sprachverarbeitung (NLP) liegt darin, die effizienteste Methode zur Darstellung von Sprachen als Zahlen zu finden.
Ein einfacher Ansatz weist jedem Buchstaben oder Symbol eine eindeutige Zahl zu. Das Modell versucht dann, die nächste Zahl in einer Sequenz vorherzusagen. Dieser Ansatz kann jedoch einen kurzen Satz in eine lange Folge von 61 Zahlen verwandeln. Jeder Fehler bei der Vorhersage eines einzelnen Buchstabens kann alle nachfolgenden Vorhersagen beeinflussen.
Um diese Herausforderungen zu bewältigen, haben Forscher eine Methode namens Tokenisierung entwickelt. Die Tokenisierung zerlegt Wörter in kleinere Einheiten oder Token, die in verschiedenen Wörtern vorkommen. Dadurch muss das Modell nicht jeden Buchstaben oder jedes ganze Wort vorhersagen, sondern kleinere, handlichere Sequenzen von Token. Durch die erhebliche Reduzierung der Optionen — von einem ganzen Wörterbuch auf etwa 2.000 Token für Englisch — wird der Prozess effizienter und genauer.
Testaufbau: Sechs Modelle, zwölf Sprachen
Wir testen die folgenden Modelle:
- Mixtral-8x7B-Instruct-v0.1
- Mistral-7B-Instruct-v0.2
- falcon-7b-instruct
- Llama-2-7b-chat-hf
- Smaug-72B-v0.1
- mt5
Wir haben das mt5-LLM in unsere Auswahl aufgenommen, weil es einen der besten mehrsprachigen Tokenizer hat, was es zu einem hervorragenden Benchmark für den Vergleich der anderen Modelle auf unserer Liste macht.
Zunächst importieren wir die Tokenizer:
from transformers import AutoTokenizer

tokenizers = {
    'Mixtral-8x7B-Instruct-v0.1': AutoTokenizer.from_pretrained("mistralai/Mixtral-8x7B-Instruct-v0.1"),
    'Mistral-7B-Instruct-v0.2': AutoTokenizer.from_pretrained("mistralai/Mistral-7B-Instruct-v0.2"),
    'falcon-7b-instruct': AutoTokenizer.from_pretrained("tiiuae/falcon-7b-instruct"),
    'Llama-2-7b-chat-hf': AutoTokenizer.from_pretrained("meta-llama/Llama-2-7b-chat-hf"),
    'Smaug-72B-v0.1': AutoTokenizer.from_pretrained("abacusai/Smaug-72B-v0.1"),
    'mt5': AutoTokenizer.from_pretrained("google/mt5-small")
}
Als nächstes wählen wir Sprachen und ihre bekannten Sätze für den Test aus. Wenn Sie eine weitere Sprache hinzufügen möchten, fügen Sie sie einfach als neuen Eintrag im Wörterbuch ein.
sentences = {
    'English': 'Call me Ishmael. Some years ago...',
    'German': 'Da steh ich nun, ich armer Tor!...',
    'French': "On ne voit bien qu'avec le cœur...",
    'Spanish': "En un lugar de la Mancha...",
    'Polish': 'Litwo, ojczyzno moja!...',
    'Ukrainian': 'Як умру, то поховайте мене...',
    'Greek': 'ἄνδρα μοι ἔννεπε, Μοῦσα...',
    'Hebrew': 'בְּרֵאשִׁית בָּרָא אֱלֹהִים...',
    'Arabic': "حدثني أبي، عن جدي...",
    'Hindi': "कर्मण्येवाधिकारस्ते...",
    'Chinese': "道可道,非常道。名可名,非常名。",
    'Japanese': "私は、その男の写真を三葉..."
}
Dann definieren wir den Testprozess:
def tokenizer_test(sentences):
    results = {}
    for model_name, tokenizer in tokenizers.items():
        results[model_name] = {}
        for language, sentence in sentences.items():
            token_list = tokenizer.tokenize(sentence)
            results[model_name][language] = {
                'length': len(token_list),
                'tokens': token_list
            }
    return results

results = tokenizer_test(sentences)
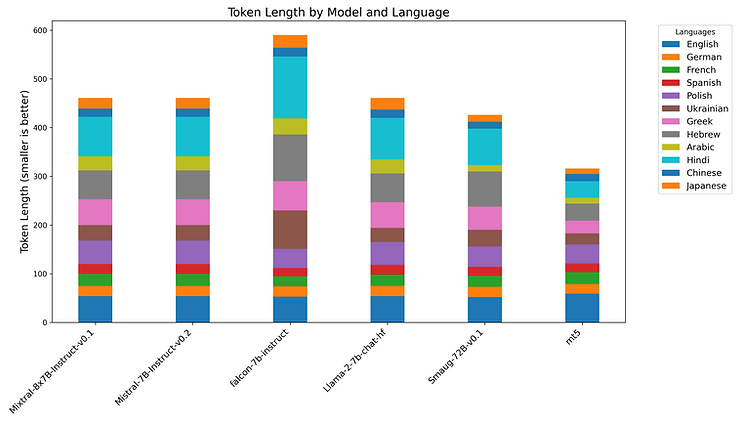
Ergebnisse: Tokenlänge nach Modell und Sprache
Es ist wichtig zu beachten, dass eine kleinere Anzahl von Token im Allgemeinen einen effizienteren Tokenizer anzeigt: Bei gleicher Eingabe deutet eine kürzere Liste von Token auf ein besseres Verständnis des Kontexts hin. Für LLMs ist die Arbeit mit kürzeren Sequenzen auch einfacher als mit längeren.
| Sprache | Mixtral | Mistral | Falcon | Llama-2 | Smaug | mt5 |
|---|---|---|---|---|---|---|
| Englisch | 54 | 54 | 53 | 54 | 52 | 59 |
| Deutsch | 21 | 21 | 21 | 21 | 21 | 20 |
| Französisch | 25 | 25 | 21 | 23 | 23 | 24 |
| Spanisch | 20 | 20 | 17 | 20 | 18 | 18 |
| Polnisch | 48 | 48 | 39 | 47 | 42 | 39 |
| Ukrainisch | 32 | 32 | 79 | 29 | 34 | 23 |
| Griechisch | 53 | 53 | 60 | 53 | 48 | 26 |
| Hebräisch | 59 | 59 | 96 | 59 | 72 | 35 |
| Arabisch | 29 | 29 | 33 | 29 | 13 | 12 |
| Hindi | 81 | 81 | 127 | 85 | 75 | 34 |
| Chinesisch | 17 | 17 | 18 | 17 | 14 | 15 |
| Japanisch | 22 | 22 | 26 | 24 | 14 | 11 |
Niedrigere Werte = bessere Tokenisierung. Hervorgehobene Werte zeigen den besten Tokenizer für die jeweilige Sprache.
Vokabulargrößen
Jeder Tokenizer hat eine andere Vokabulargröße, die die Menge der für das Fine-Tuning des LLM erforderlichen Daten beeinflusst. Vergleichen wir diese Vokabulargrößen.
vocab_sizes = {name: tokenizer.vocab_size for name, tokenizer in tokenizers.items()}

plt.figure(figsize=(10, 6))
plt.bar(range(len(vocab_sizes)), list(vocab_sizes.values()), tick_label=list(vocab_sizes.keys()))
plt.ylabel('Vocabulary Size')
plt.title('Vocabulary Sizes of Various Tokenizers')
plt.show()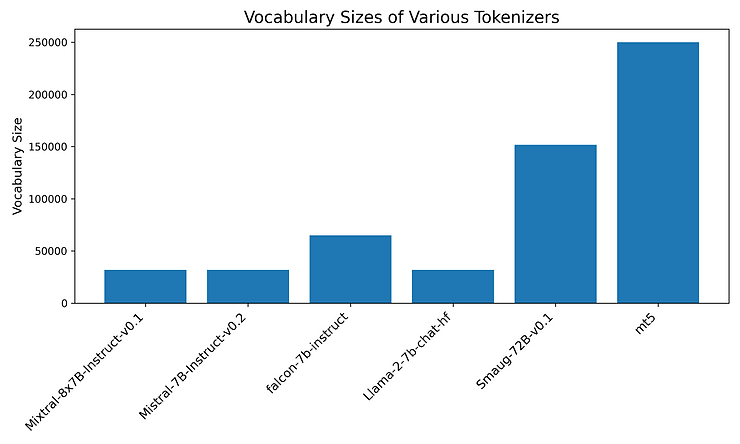
Schlussfolgerungen
Die bemerkenswerte Qualität der mt5-Tokenisierung lässt sich größtenteils auf seine umfangreiche Vokabulargröße zurückführen. Die Effektivität eines Tokenizers hängt jedoch von mehr ab als nur seiner Größe. Obwohl Smaugs Vokabulargröße beispielsweise deutlich größer ist als die von Llama-2, ist ihre Tokenisierungsleistung relativ ähnlich.
Es ist klar, dass keines der populären LLMs an die Effizienz des mt5-Tokenizers heranreicht, wobei falcon-7b-instruct im Durchschnitt besonders ineffizient ist. Für bestimmte Sprachen, insbesondere aus der romanischen und germanischen Sprachfamilie, schneiden die Modelle jedoch vergleichbar gut ab. Wenn wir jedoch Sprachen außerhalb dieser Familien untersuchen, sinkt die Leistung populärer LLMs bei mehrsprachigen Aufgaben erheblich. Ein minderwertiger mehrsprachiger Tokenizer macht das Fine-Tuning für solche Aufgaben nahezu unmöglich.
In unseren Projekten haben wir versucht, Llama-2 für mehrsprachige Aufgaben mit einem umfangreichen und sorgfältig kuratierten Datensatz von über einer Milliarde Token zu fine-tunen, nur um mitten im Projekt auf mt5 umzusteigen.
Da mt5 nur als Basismodell verfügbar ist und erheblichen Aufwand erfordert, um es zum Befolgen von Anweisungen zu bringen, benötigt es einen großen und qualitativ hochwertigen Datensatz. Unsere Kunden hatten das Glück, über eine solche Ressource zu verfügen, aber insgesamt ist es ein seltenes und öffentlich nicht verfügbares Gut.
Trotz der beeindruckenden Landschaft der LLMs besteht nach wie vor eine Lücke für ein leistungsstarkes mehrsprachiges Modell. Das Design der Tokenizer in den leistungsstärksten Open-Access-LLMs begrenzt inhärent ihre Effektivität in bestimmten Sprachen, und dies kann nicht durch zusätzliches Training überwunden werden. Derzeit scheint das Training von mt5 vom Basismodell der vielversprechendste Ansatz für ein wirklich mehrsprachiges Modell zu sein.
Der Aufbau eines eigenen LLM k\u00F6nnte die Datensicherheit und Compliance verbessern und einen KI-Wettbewerbsvorteil f\u00FCr Ihr Produkt erm\u00F6glichen. Lesen Sie unsere anderen Beitr\u00E4ge: Was der Netzwerkeffekt ist und wie KI ihn erm\u00F6glicht, wie man einen KI-Wettbewerbsvorteil aufbaut, welche Kultur hilft, was Sie vermeiden sollten und mehr.
Bauen Sie KI für nicht-englischsprachige Märkte?
Das Tokenizer-Design begrenzt die mehrsprachigen Fähigkeiten der meisten LLMs grundlegend. Lassen Sie uns das richtige Modell und die optimale Trainingsstrategie für Ihre Sprachanforderungen identifizieren.