
ChatGPT crée-t-il un avantage concurrentiel ?
Sergii Shelpuk · Managing Partner
Au cours des six derniers mois, ChatGPT a pris d'assaut Internet. Ce produit OpenAI le mieux noté a dépassé le million d'utilisateurs en seulement cinq jours, établissant un nouveau record parmi les produits Internet. Les médias sociaux et les sources réputées sont en effervescence avec des discussions sur la question de savoir si ChatGPT et des technologies similaires vont perturber des industries entières et révolutionner le lieu de travail.
Maintenant, la question se pose : ChatGPT offre-t-il des avantages concurrentiels à votre entreprise ? Alternativement, devriez-vous craindre que vos concurrents ne s’emparent d’une partie de votre part de marché en utilisant ChatGPT ? Examinons cette question.
ChatGPT peut-il créer un avantage concurrentiel pour votre entreprise ?
La clé pour obtenir un avantage durable réside dans la possession de quelque chose qui ne peut pas être facilement reproduit : des actifs, des relations, une réputation, une marque ou une conception commerciale unique. Au cours des dernières décennies, les technologies d’apprentissage automatique et d’IA ont été saluées pour transformer les données en un avantage concurrentiel durable. Ce processus fonctionne selon un cycle : l’IA a le pouvoir de convertir vos données propriétaires en une valeur perçue pour votre produit. À mesure que cette valeur perçue augmente, la quantité de données exclusives augmente également, créant une boucle de rétroaction positive qui aboutit à un produit extrêmement difficile à imiter. Le positionnement concurrentiel optimal pour un produit d’IA peut être visualisé comme suit :
- Vous devez proposer un produit de qualité supérieure pour conquérir la part de marché d’un produit d’IA.
- Puisque la valeur provient des modèles d’IA, vous avez besoin de meilleurs modèles.
- Étant donné que les modèles d’IA modernes sont entraînés grâce à l’apprentissage automatique sur les données, vous avez besoin de plus de données.
- Comme les données proviennent de l’utilisation du produit, vous avez besoin d’un produit amélioré.
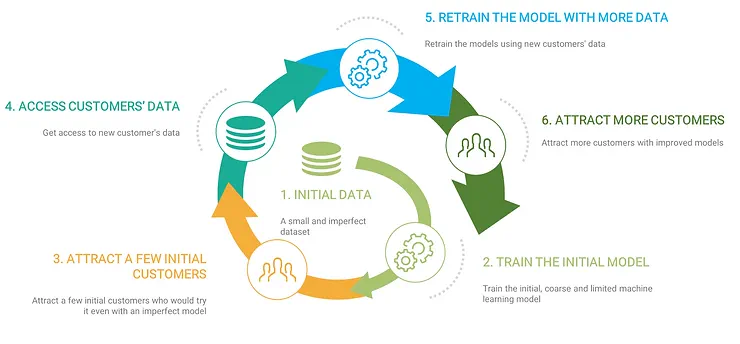
Cette conception stratégique dissuade efficacement les concurrents, même dans le cas de produits comme la recherche Google et YouTube, qui, s'ils étaient reproductibles, propulseraient une entreprise sur le territoire de plusieurs milliards de dollars. Néanmoins, leur position sur le marché reste aujourd'hui solide : les concurrents potentiels soit comprennent la futilité de la bataille avant qu'elle ne commence, soit l'apprennent à leurs dépens au travers de vaines tentatives.
Revenons maintenant à ChatGPT, un produit OpenAI dans sa forme actuelle. Quelle est sa place dans ce cycle ?
Un système d’IA devrait améliorer ses performances avec davantage de données au fur et à mesure de sa formation continue. Cependant, ChatGPT est un produit immuable : vous ne pouvez pas le former à l'aide de vos données propriétaires. L'ingénierie des invites s'apparente à de la programmation plutôt qu'à une formation en apprentissage automatique, ce qui signifie que vos invites peuvent être copiées également par des ingénieurs qualifiés ou même par l'un de vos propres concurrents. De ce point de vue, vous pouvez comparer ChatGPT à une feuille de calcul sophistiquée : elle peut apporter de la valeur et gagner du temps, mais elle ne crée pas un avantage concurrentiel durable pour votre entreprise.
Pour établir un avantage concurrentiel, votre système d’IA doit être entraîné avec des données propriétaires, des données que possède votre entreprise et qui sont difficiles à acquérir pour les concurrents. Cela rend votre système d’IA différent de celui que vos concurrents peuvent entraîner sans accéder à vos données.
Tout ce que vous envoyez à ChatGPT se retrouve dans les ensembles de données d'OpenAI et contribue aux performances du produit, bénéficiant non seulement à votre entreprise mais à tous vos concurrents prêts à payer 20 $ par mois pour accéder à un outil ayant accès à vos données propriétaires. L'extraction de données de formation à partir de modèles linguistiques est un défi permanent, et vous devez considérer toutes les données que vous partagez avec ChatGPT comme étant essentiellement ouvertes au monde entier. De ce point de vue, si vous transmettez vos données propriétaires à ChatGPT, vous faites le contraire de les transformer en un avantage concurrentiel : vous donnez vos données propriétaires.
En résumé, ChatGPT est un produit d'IA que vous ne pouvez pas personnaliser en vous entraînant avec vos propres données. Bien qu'OpenAI puisse améliorer le modèle en exploitant vos données propriétaires, il met ces avantages (et potentiellement vos données propriétaires) à votre disposition non seulement, mais également à tous vos concurrents.
Vous pouvez et devez utiliser ChatGPT pour améliorer l'efficacité, le cas échéant. Néanmoins, il ne faut pas le confondre avec les technologies d’IA qui ont le potentiel de faire de votre entreprise un leader du marché dans votre secteur – ChatGPT ne peut pas remplir ce rôle.
Grands modèles de langage (LLM)
En effet, il est évident que ChatGPT ne peut à lui seul vous apporter un avantage concurrentiel. Cependant, qu’en est-il des autres grands modèles de langage ? Est-il possible de développer votre propre système ressemblant à ChatGPT et de déclencher le cycle vertueux de l’IA ?
Examinons les technologies qui génèrent des opportunités d’avantages concurrentiels en matière d’IA. Nous avons en premier lieu celles qui permettent de construire ce cercle vertueux à partir de nouveaux types de données. Le moment « Eurêka » est survenu avec AlexNet lors du concours ImageNet 2012, où les réseaux neuronaux convolutifs ont atteint un niveau de sophistication qui leur a permis d'extraire de la valeur à partir de vastes ensembles de données d'images du monde réel – un défi avec lequel les algorithmes de vision par ordinateur antérieurs basés sur des extracteurs de caractéristiques avaient du mal à le relever. En termes simples, cela a montré que vous pouvez créer une entreprise durable et défendable avec un produit qui collecte des photos du monde réel tout en les utilisant pour s'améliorer grâce aux réseaux de neurones convolutifs. Ceux qui ont compris ce concept très tôt ont rapidement identifié les niches applicables et en ont tiré parti. Un excellent exemple est Blue River Technology, qui a émergé peu de temps après la percée d'AlexNet et a appliqué les nouveaux réseaux de neurones convolutifs disponibles aux images de champs agricoles.
Revenons maintenant aux grands modèles linguistiques (LLM). Permettent-ils le cycle vertueux de l’IA pour de nouveaux types de données ?
Le LLM, semblable à ChatGPT, suit une formation en trois étapes.
Dans la première étape, un modèle de langage est développé en entraînant le modèle Transformer pour prédire le mot suivant en fonction du texte précédent d'une longueur spécifique (pour ChatGPT, il s'agissait de 2048 mots). À ce stade, le modèle peut compléter automatiquement le texte saisi, mais n'a pas la capacité d'engager un dialogue ou de répondre aux demandes.
Dans la deuxième étape, vous entraînez le modèle à répondre aux demandes des utilisateurs sur un petit ensemble de données « question-réponse » de haute qualité. Le modèle résultant est appelé modèle SFT (supervised fine-tuning).
La troisième étape est l’apprentissage par renforcement à partir de la rétroaction humaine (RLHF). En termes simples, cela implique de demander au LLM de classer différentes réponses, reflétant leur proximité avec le résultat attendu. RLHF transforme essentiellement le LLM en l'assistant de type chat que nous avons aujourd'hui.
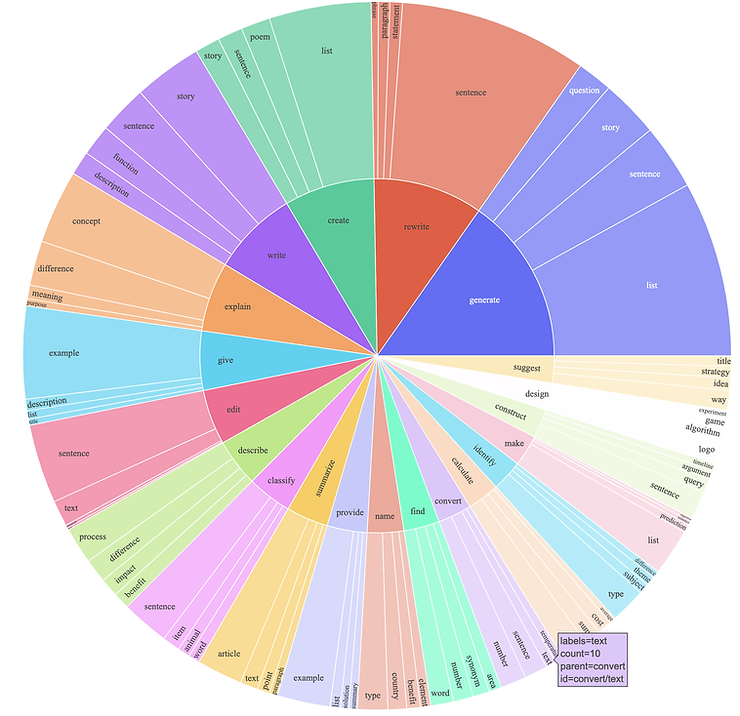
L'une de ces technologies ouvre-t-elle de nouvelles niches en permettant de nouveaux types de données, à l'instar de la percée d'AlexNet ?
Former le LLM à prédire le mot suivant peut être une entreprise exigeante et coûteuse. Le coût de formation estimé pour la formation du modèle GPT3 à partir de zéro dépasse 4 millions de dollars et la durée de formation peut prendre jusqu'à 9 jours. Très peu d’entreprises peuvent se permettre de telles dépenses régulièrement (rappelons que le modèle nécessite un recyclage régulier pour capitaliser sur de nouvelles données propriétaires). De plus, bien que des architectures LLM plus petites et plus rentables soient disponibles, un modèle qui prédit seul le prochain mot est d'une utilité limitée, même s'il est formé avec des données propriétaires. Vous devez toujours activer les fonctionnalités de chat via RLHF.
Il existe ici une opportunité fascinante : la formation « questions-réponses » (SFT) et la technologie RLHF peuvent réellement créer un avantage concurrentiel durable.
Si vous pouvez imaginer un produit qui offre de la valeur grâce à des capacités de chat ou d'assistant et génère simultanément des données applicables au RLHF à partir des interactions des utilisateurs, vous êtes peut-être sur quelque chose d'important.
De cette façon, votre produit s'améliorera avec de nouvelles données de mesure de la qualité des questions-réponses ou des réponses et, à son tour, générera davantage de données de formation à mesure qu'il améliorera ses performances.
L’ampleur de cette opportunité est difficile à déterminer. De toute évidence, il existe des niches spécifiques où de tels retours peuvent être obtenus, principalement sur le marché des aides à l’écriture où opèrent des sociétés comme Grammarly. Il reste à voir avec quelle facilité les technologies LLM peuvent perturber ce marché évident. Cependant, si vous souhaitez évaluer votre propre idée de startup basée sur un LLM ou celle de quelqu'un d'autre, posez-vous deux questions :
- Comment les améliorations LLM apportent-elles plus de valeur aux utilisateurs ?
- Comment les utilisateurs génèrent-ils des données de formation lorsqu’ils utilisent le produit ?
Si au moins l’une d’elles n’a pas de bonne réponse, il sera probablement difficile de bâtir une entreprise défendable autour de cette idée.
Concurrence entre les LLM
Depuis les débuts explosifs des LLM, d’éminents géants de la technologie sont entrés dans la mêlée. Microsoft a investi la somme colossale de 10 milliards de dollars dans OpenAI et a intégré ChatGPT dans son moteur de recherche Bing. Google a présenté Bard, tandis que Meta a ouvert le grand modèle de langage LLaMA, entre autres développements notables. Beaucoup considèrent les LLM comme un perturbateur potentiel sur le marché de la recherche en ligne, un domaine longtemps dominé par la recherche Google. Pour mieux comprendre leurs efforts, appliquons la logique de l’avantage concurrentiel.
Boucle de rétroaction
ChatGPT fait preuve d'une maîtrise remarquable dans diverses tâches, y compris le codage, un sujet qui suscite souvent des débats sur l'automatisation du génie logiciel. Cependant, ces capacités reposent fortement sur les données de formation du RLHF. OpenAI, par exemple, emploie des ingénieurs logiciels dédiés à la production de telles données en résolvant des défis de programmation similaires à ceux rencontrés sur LeetCode et en fournissant des explications détaillées en langage humain. De plus, l'entreprise fait appel à un nombre important d'étiqueteurs de données pour créer d'autres formes de données de formation RLHF. Il y a des rumeurs selon lesquelles Google extrait les données RLHF de ChatGPT pour former ses propres LLM. Néanmoins, du point de vue de l’avantage concurrentiel de l’IA, ces approches présentent des défauts inhérents.
Alors que l'étiquetage manuel des données peut produire des données de formation substantielles, une conception de produit qui génère des données RLHF directement via les interactions des utilisateurs dans le cadre de leur parcours peut surpasser l'étiquetage manuel grâce à une boucle de rétroaction plus forte.
OpenAI a tenté de résoudre ce problème en introduisant une fonctionnalité « j'aime/je n'aime pas » dans ChatGPT. Cependant, aimer ou ne pas aimer les réponses au chat n'est pas un aspect essentiel du parcours utilisateur : je peux bénéficier du produit sans exprimer explicitement ma préférence.
Accès aux données
De plus, un solide avantage concurrentiel de l’IA doit reposer sur des données exclusives difficiles à acquérir pour les concurrents. La domination de la recherche Google est en grande partie due à l'exploitation de nos requêtes et interactions de recherche historiques, complétées par de grandes quantités de données collectées via divers produits Alphabet. Nos e-mails Gmail, nos recherches, vues et interactions YouTube, les données de navigation de Google Chrome et même les données d'utilisation du téléphone des appareils Android contribuent tous aux modèles d'utilisateur et intégrations complexes que Google construit méticuleusement pour chaque individu. Ces modèles d'utilisateurs personnalisés, combinés à nos requêtes de recherche, permettent à la recherche Google de présenter des résultats personnalisés et pertinents. À mesure que les résultats de recherche s'améliorent, nous revenons naturellement à Google pour d'autres recherches, fournissant à l'entreprise encore plus de données pour enrichir nos modèles d'utilisateurs individuels. La puissance des produits d'IA d'Alphabet provient de cet ensemble de données exclusif. Tenter de reproduire la recherche Google est une entreprise vouée à l’échec précisément en raison du manque d’accès à ces données.
OpenAI, Google ou toute autre entreprise possède-t-elle des données de formation uniques ou une conception de produit qui les génère ? Ce n’est guère le cas.
Alternatives open source
Considérez l'écosystème florissant de LLM et de chats LLM open source qui a prospéré au cours des six derniers mois. Il existe des centaines de LLM open source, dont beaucoup peuvent être utilisés commercialement. Ces modèles sont plus petits, plus rentables à former et, surtout, personnalisables, puisque l’avantage concurrentiel réside dans le fait de disposer d’un modèle unique. La pré-formation open source et les ensembles de données RLHF sont facilement disponibles, et de nouveaux développements émergent quotidiennement. Dans cet environnement, ni OpenAI, ni Google, ni Microsoft ne possèdent une asymétrie distinctive qui leur permettrait de créer des LLM de qualité supérieure tout en étant difficiles à reproduire par d'autres entreprises ou même par des ingénieurs individuels.
Il est intéressant de noter que même Google, une entreprise habituée à créer des avantages concurrentiels en matière d’IA, semble reconnaître cette réalité. Dans un document divulgué, Luke Sernau, ingénieur logiciel senior chez Google, admet que Google n'a pas d'avantage concurrentiel dans le développement de LLM. Le document note : « La vérité inconfortable est que nous ne sommes pas en mesure de gagner cette course aux armements, et OpenAI non plus. Pendant que nous nous chamaillions, une troisième faction a tranquillement mangé notre déjeuner... Je parle, bien sûr, de l'open source. Sernau suggère que sans « sauce secrète », la meilleure approche de Google consiste à apprendre des efforts externes et à collaborer avec eux tout en donnant la priorité aux intégrations tierces. Sernau a déclaré que les ingénieurs open source faisaient des choses avec 100 dollars avec lesquelles "nous avons du mal" à 10 millions de dollars, "et cela en quelques semaines, pas en mois".
En résumé, le développement des LLM généraux semble échapper au contrôle de toute grande entreprise, même des plus grandes. Actuellement, aucun d’entre eux ne semble disposer d’une stratégie infaillible pour consolider sa position – cela inclut Google, qui s’est imposé avec succès avec la recherche, YouTube et de nombreux produits plus petits.
Une fois de plus, cela confirme ma suggestion précédente : trouver un créneau dans lequel les LLM peuvent établir un avantage concurrentiel durable qui ne peut pas être rapidement reproduit est incroyablement difficile.
Que devriez-vous faire à ce sujet ?
Ayant commencé ma carrière dans l'IA bien avant le battage médiatique actuel et même avant le « moment AlexNet » d'ImageNet 2012, je peux affirmer avec confiance que la frénésie actuelle de ChatGPT submerge même quelqu'un comme moi qui connaît bien le domaine. Je ne peux qu'imaginer à quoi cela ressemble à ceux qui ne font pas partie de l'industrie, avec cet immense buzz générant de l'anxiété et la peur de passer à côté chez de nombreuses personnes. Depuis le lancement de ChatGPT, de nombreux amis et collègues m'ont contacté pour me demander s'ils devaient se soucier de leur entreprise ou même de leur carrière.
Permettez-moi de vous fournir un cadre de réflexion sur le développement actuel du LLM.
Une bonne analogie vaut des milliers de mots, alors considérez les LLM semblables à la vague IBM PC des années 1980 et 1990.
Les ordinateurs personnels ont gagné en popularité au cours de ces décennies, principalement grâce aux traitements de texte et aux tableurs qui simplifiaient les tâches de routine. En 1984, les revenus d'IBM sur le marché des PC dépassaient les 4 milliards de dollars, soit plus du double de ceux d'Apple. Une étude réalisée en 1983 a révélé que les deux tiers des gros clients qui optaient pour un seul ordinateur optaient pour le PC, tandis que seulement 9 % choisissaient Apple. Une enquête Fortune de 1985 a révélé que 56 % des entreprises américaines possédant des ordinateurs personnels utilisaient des PC, tandis que 16 % utilisaient Apple.
Cependant, une série d'erreurs commises par IBM en matière de protection de la propriété intellectuelle ont conduit à l'émergence de l'ensemble de l'industrie des clones « compatibles IBM PC ». Cela a été dévastateur pour IBM, mais pour le monde de la technologie, le PC IBM et ses clones sont devenus l'un des événements les plus marquants de l'histoire.
Si vous êtes un dirigeant d'entreprise et que vous envisagez aujourd'hui le battage médiatique de ChatGPT, mettez-vous à la place de vos collègues qui ont vécu l'ère du PC. Les PC constituaient sans aucun doute une grande innovation, automatisant de nombreuses tâches de routine, simplifiant la comptabilité et remplaçant les machines à écrire. Cependant, ces machines étaient également abordables et facilement disponibles.
Vous attendriez-vous à ce que votre concurrent ou une jeune startup vous évince du marché simplement en introduisant les PC sur son lieu de travail ? Pour la plupart, la réponse est : à peine. Après tout, vous pouvez acquérir ces ordinateurs pour votre propre entreprise quand bon vous semble. Même s’ils peuvent améliorer votre activité, ils ne constituent pas une menace pour votre part de marché.
Et si vous êtes un entrepreneur envisageant de créer une nouvelle entreprise, sachez que l’industrie des clones de PC IBM des années 1980 et 1990 avait des marges bénéficiaires incroyablement faibles.
Même si vous pouviez assembler et vendre vos propres ordinateurs à l'aide de composants compatibles IBM PC facilement disponibles, tout le monde le pourrait également. Dans un tel scénario, la seule façon d’être compétitif est de jouer sur les prix, ce qui en fin de compte vous amène, ainsi que tous les autres acteurs du marché, à des marges bénéficiaires extrêmement minces.
Cependant, inspirez-vous de Microsoft, qui a développé des systèmes d'exploitation pour les PC IBM et a finalement transformé Windows en l'une des plates-formes les plus performantes de tous les temps. Si vous parvenez à créer un produit dont chaque utilisateur de LLM a besoin et à le construire avec le concept d'avantage concurrentiel durable, vous pourriez vous retrouver avec une entreprise florissante en temps voulu. Mais c’est une tout autre histoire.
Ce blog est dédié à l'avantage concurrentiel de l'IA, et nous faisons de notre mieux pour expliquer son fonctionnement et comment vous pouvez en créer un pour votre produit ou votre entreprise. Vous pouvez consulter nos autres articles pour obtenir une explication détaillée de quel est l'effet de réseau et comment l'IA le permet, comment créer un avantage concurrentiel en matière d'IA pour votre entreprise, quelle culture vous aide à créer les bons produits d'IA, ce qu'il faut éviter dans votre stratégie et votre exécution d'IA, et plus encore.
Besoin d'aide pour créer un avantage concurrentiel en matière d'IA ?
Notre équipe d'experts commerciaux et de consultants en technologie d'IA possède des années d'expérience dans l'aide aux entreprises technologiques comme la vôtre pour créer des avantages concurrentiels durables grâce à la technologie d'IA.