
Llama 3.1 avec Unsloth : deux fois plus vite
Le fine-tuning de grands modèles de langage (LLM) sur de petits jeux de données ou des datasets pédagogiques peut être relativement simple. En revanche, dans des usages commerciaux avec de longues séquences d'entrée ou des sorties très volumineuses, la difficulté augmente très vite. Même avec des techniques avancées comme QLoRA, un seul exemple d'entraînement peut suffire à saturer une GPU de 80 Go, comme une H100 ou une A100. Et avec des entrées longues, le fine-tuning peut devenir particulièrement lent.
Heureusement, il existe une solution qui permet d’économiser à la fois du temps et des ressources : Unsloth. Dans cet article, nous présentons Unsloth, expliquons comment l’installer et l’utiliser sur des plateformes cloud GPU comme Vast AI, MassedCompute et RunPod, et partageons des bonnes pratiques qui vont au-delà de la documentation officielle.
Qu’est-ce qu’Unsloth ?
Unsloth est une bibliothèque open source gratuite sous licence Apache 2.0, conçue pour rendre le fine-tuning des LLM beaucoup plus efficace. Elle est 2,2 fois plus rapide que la bibliothèque standard Hugging Face Transformers, consomme 70 % de mémoire GPU en moins et conserve la précision avec QLoRA en 4 bits comme avec LoRA en 16 bits. En prime, elle accélère aussi l'inférence.
Si cela semble trop beau pour être vrai, c’est surtout parce que le fine-tuning des LLM reste un domaine jeune, encore plein d’inefficacités. Unsloth s’attaque précisément à ces points en améliorant l’usage de la mémoire et les performances d’entraînement.
Le code de la bibliothèque est clair et bien structuré, ce qui permet de comprendre assez facilement comment elle optimise le modèle. En pratique, Unsloth élimine des calculs inutiles et harmonise les types de données, d’où ses gains de performance.
Nous avons largement utilisé Unsloth dans nos projets, et cet article reflète nos expériences en août 2024. Comme Unsloth évolue rapidement, nous vous recommandons de consulter la documentation officielle pour les dernières mises à jour si vous lisez ceci à une date ultérieure.
Installation d'Unsloth
Démarrer avec Unsloth peut être un peu délicat, surtout lors de l'installation. Le processus n’est pas aussi simple qu’on pourrait s’y attendre, et le moyen le plus fiable de le configurer consiste à utiliser un environnement Conda.
Dans ce guide, nous montrons l’installation sur une VM H100 de MassedCompute. Les mêmes étapes s’appliquent toutefois aussi à des instances GPU Docker sur des plateformes comme Vast AI et RunPod.
1. Créez la VM
Tout d’abord, rendez-vous sur MassedCompute et créez une nouvelle VM. Dans cet exemple, nous utilisons une instance spot H100 pour profiter de tarifs inférieurs. Cependant, gardez à l’esprit que les instances ponctuelles peuvent être résiliées avec un préavis d’une heure seulement, alors planifiez en conséquence si vous choisissez cette option.
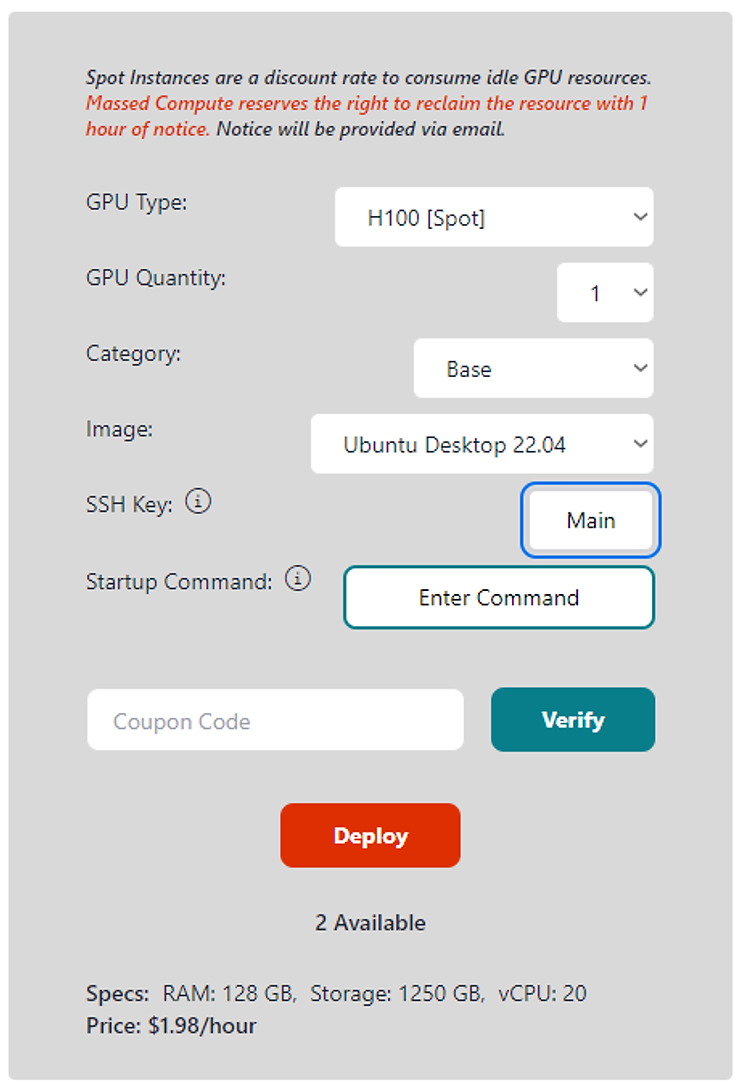
Sélectionnez le type d'instance « Base » et l'image du système d'exploitation « Ubuntu Desktop 22.04 », puis cliquez sur « Déployer ».
2. Mettre à jour les packages
Mettez ensuite à jour les paquets de base, installez la CLI Hugging Face et authentifiez-vous avec votre token Hugging Face.
sudo apt update
sudo apt upgrade -y
sudo apt install python3-pip -y
python3 -m pip install --upgrade pip
pip3 install packaging huggingface_hub[cli]
export PATH=$PATH:~/.local/bin
huggingface-cli login --token hf_<YOUR HUGGINGFACE TOKEN>
3. Installez Conda
mkdir -p /home/Ubuntu/miniconda3
wget https://repo.anaconda.com/miniconda/Miniconda3-latest-Linux-x86_64.sh -O ~/miniconda3/miniconda.sh
bash /home/Ubuntu/miniconda3/miniconda.sh -b -u -p ~/miniconda3
rm -rf /home/Ubuntu/miniconda3/miniconda.sh
/home/Ubuntu/miniconda3/bin/conda init bash
. /home/Ubuntu/.bashrc
4. Créer un environnement Conda Unsloth
conda create --name unsloth_env python=3.10
conda activate unsloth_env
conda install pytorch==2.2.0 cudatoolkit torchvision torchaudio pytorch-cuda=12.1 -c pytorch -c nvidia
conda install xformers -c xformers
pip install bitsandbytes matplotlib datasets transformers trl peft accelerate sentencepiece
pip install --upgrade --force-reinstall --no-cache-dir git+https://github.com/unslothai/unsloth.git
Si vous utilisez Weights & Biases, installez-le également :
pip3 install wandb
wandb login
<YOUR WEIGHTS & BIASES TOKEN>
5. Installez et lancez Jupyter Notebook
sudo apt-get install nano -y
pip3 install jupyter
jupyter notebook --generate-config
Modifiez la configuration Jupyter pour définir l'adresse IP et le port :
nano ~/.jupyter/jupyter_notebook_config.pyAjoutez les lignes suivantes après "c = get_config()" :
# Set the IP address to '*'
c.NotebookApp.ip = '0.0.0.0'

# Set the port to 10000
c.NotebookApp.port = 10000

# Disable browser opening
c.NotebookApp.open_browser = False
Définissez le mot de passe de votre Jupyter Notebook et démarrez-le :
jupyter notebook password
jupyter notebook --allow-root
Ouvrez ensuite votre navigateur et accédez à http://<VM_IP_ADDRESS>:10000
Entraînement du modèle
Pour l'entraînement, nous utiliserons le notebook officiel Unsloth dédié à Llama 3.1 8B.
1. Supprimer l'installation du package PIP
Comme nous avons déjà préparé un environnement Conda Unsloth pleinement opérationnel, la première étape consiste à supprimer du notebook les commandes d’installation des paquets via pip.
2. Adapter la structure de prompt à Llama 3.1
Le notebook Unsloth d'origine utilise le dataset Alpaca et la structure de prompt associée à des fins de démonstration. Pour obtenir les meilleurs résultats avec un modèle Llama 3.1 fine-tuné, il est essentiel de reprendre exactement la structure de prompt utilisée pendant l'entraînement.
Le modèle meta-llama/Meta-Llama-3.1-8B-Instruct utilise la structure de prompt suivante :
| Token | Description |
|---|---|
| <|begin_of_text|> | Marque le début du prompt |
| <|end_of_text|> | Le modèle cesse de générer d'autres tokens |
| <|start_header_id|> <|end_header_id|> | Délimitent le rôle d’un message donné (system, user, assistant, ipython) |
| <|eom_id|> | Fin du message – signale qu'un appel d'outil doit être effectué |
| <|eot_id|> | Fin du tour – signale que le modèle a fini de générer une réponse |
| <|python_tag|> | Balise spéciale utilisée dans la réponse du modèle pour signifier un appel d'outil |
Notez que nous n’ajoutons pas le token <|begin_of_text|> à notre structure de prompt, car le tokenizer l’insère automatiquement.
3. Entraîner uniquement sur la completion
Pendant l’entraînement d’un LLM, un problème potentiel peut apparaître : le « surapprentissage sur l’entrée ». Cela se produit parce que les LLM modernes, en tant que modèles decoder-only, apprennent la probabilité de chaque token à partir de tous les tokens précédents, y compris ceux présents dans l’entrée du modèle. Si la même entrée apparaît plusieurs fois dans l’ensemble d’apprentissage, le modèle peut finir par apprendre cette structure au lieu de se concentrer réellement sur la qualité de la réponse.
Pour atténuer ce problème, la bibliothèque Transformers permet d’entraîner le modèle uniquement sur la completion, c’est-à-dire la réponse générée par l’IA. Dans ce mode, le modèle continue de voir à la fois l’entrée et la sortie, mais la mise à jour des poids ne se fait que sur la partie réponse.
Pour activer ce mode, importez DataCollatorForCompletionOnlyLM et configurez-le avec le modèle de texte qui identifie la partie de réponse :
from trl import SFTTrainer, DataCollatorForCompletionOnlyLM

response_template = "<|start_header_id|>assistant<|end_header_id|>"
collator = DataCollatorForCompletionOnlyLM(response_template, tokenizer=tokenizer)
L'entraînement se termine en 1 min 39 s et nécessite 14,5 Go de mémoire GPU.
4. Inférence
Bien que la séquence de Fibonacci soit une tâche relativement simple, elle sert de test de base de la fonctionnalité du modèle. Il est important de noter que l’ensemble de données Alpaca faisait probablement partie des données d’entraînement originales pour Llama 3.1. Cependant, lorsque vous utilisez votre propre ensemble de données propriétaire, le processus de formation peut améliorer considérablement les performances du modèle, lui permettant ainsi de gérer efficacement des tâches plus complexes et spécialisées.
Vous trouverez le code complet de ce tutoriel dans notre notebook Colab.
Limites
Bien qu'Unsloth offre une solution puissante à de nombreux défis, la version gratuite a ses limites.
- La version gratuite n'est compatible qu'avec les modèles modifiés par Unsloth. Même si l’équipe travaille activement à prendre en charge les modèles les plus populaires et les plus avancés, les modèles plus spécialisés ou de niche ne bénéficient pas toujours encore de ses optimisations.
- Unsloth ne prend pas en charge l’entraînement multi-GPU. Si vous atteignez la limite de mémoire GPU, même avec son approche économe en mémoire, il faudra envisager d’autres options, car il n’existe aucun moyen de répartir la charge sur plusieurs GPU.
- Unsloth prend également en charge nativement le RoPE scaling (Rotary Positional Encoding), qui permet d’étendre la fenêtre de contexte au-delà de sa taille d’origine. En revanche, seuls quelques modèles le supportent aujourd’hui réellement avec Unsloth.
Conclusion
Le développement de votre LLM personnalisé pourrait améliorer la sécurité et la conformité des données et permettre à votre produit de bénéficier d'un avantage concurrentiel en matière d'IA. Consultez nos autres articles pour en savoir plus :
- Adaptation de bas rang (LoRA) pour un réglage fin efficace des grands modèles de langage
- Pourquoi avez-vous besoin d’une stratégie d’IA ? L'IA comme avantage concurrentiel
- Des stratégies d'IA qui offrent un avantage concurrentiel durable
- Commencez par la bonne culture de développement de l’IA
Vous recherchez un réglage fin du LLM rapide et rentable ?
Évaluons le meilleur framework de réglage fin pour votre cas d'utilisation et construisons un modèle personnalisé qui vous donne un avantage concurrentiel.