
Guide du praticien LLM : Falcon, Mistral, Smaug
So, you want to fine-tune a large language model for your own language. What model should you use?
The world of open-access LLMs is rapidly expanding, with hardly a week passing without the announcement of a new benchmark leader. At the time of writing this post, the Huggingface Open LLM Leaderboard has crowned a new champion: Smaug LLM. This field is incredibly dynamic, reminding us of the bustling IBM PC clone market in the late 1980s to early 1990s.
Despite the variety, many of these models share common origins. Smaug, for example, is based on Qwen-72B. While fine-tuning allows for significant adjustments to a model\u2019s behavior, one aspect you can\u2019t alter is its tokenizer.
Nous avons été profondément impliqués dans la personnalisation, la mise au point et le déploiement de divers LLM en libre accès. À travers cette série d’articles, nous souhaitons partager nos idées sur ce qu’ils peuvent et ne peuvent pas faire, ainsi que des instructions détaillées et les meilleures pratiques pour un réglage précis.
Guide du praticien LLM :
- À quoi ressemble réellement Llama-2 multilingue ?
- À quel point Falcon, Mistral, Smaug et autres LLMs sont-ils multilingues ?
In a previous post, we explored the Llama-2 tokenizer and discussed why it struggles with certain languages. Today, we\u2019re conducting comprehensive tokenizer tests on six of the most popular LLMs across 12 languages. Our goal is to determine which models are the most adaptable for each language. We\u2019ll also share the source code for our experiments, enabling you to include any language you wish in this benchmark.
Tous les grands modèles de langage (LLM), qu'ils soient propriétaires comme ChatGPT ou open source, traitent les informations à l'aide de nombres. Pour interpréter le texte, ces modèles le convertissent dans un premier temps sous forme numérique. Le principal défi du traitement du langage naturel (NLP) réside dans la recherche de la méthode la plus efficace pour représenter les langues sous forme de nombres.
Une approche simple attribue à chaque lettre ou symbole un numéro unique. Le modèle tente ensuite de prédire le numéro suivant dans une séquence. Cependant, cette approche peut transformer une brève phrase en une longue séquence de 61 nombres. Toute erreur dans la prédiction d’une seule lettre peut affecter toutes les prédictions ultérieures, rendant cette méthode à la fois complexe et sujette aux erreurs.
Pour relever ces défis, les chercheurs ont développé la tokenisation. Cette méthode découpe les mots en unités plus petites, ou tokens, réutilisables dans de nombreux contextes. Le modèle n’a alors plus besoin de prédire chaque lettre ou chaque mot entier, mais des séquences de tokens plus courtes et plus maniables. En réduisant drastiquement le nombre d’options à considérer, le processus devient à la fois plus efficace et plus précis.
Configuration du test : six modèles, douze langues
Examinons comment les tokenizers LLM les plus populaires d'aujourd'hui gèrent différentes langues. Nous testerons les modèles suivants :
- Mixtral-8x7B-Instruct-v0.1
- Mistral-7B-Instruct-v0.2
- falcon-7b-instruct
- Llama-2-7b-chat-hf
- Smaug-72B-v0.1
- mt5
Nous avons inclus le mt5 LLM dans notre gamme car il possède l'un des meilleurs tokenizers multilingues, ce qui en fait une excellente référence pour comparer les autres modèles de notre liste.
Tout d’abord, nous devons importer les tokenizers :
from transformers import AutoTokenizer

tokenizers = {
    'Mixtral-8x7B-Instruct-v0.1': AutoTokenizer.from_pretrained("mistralai/Mixtral-8x7B-Instruct-v0.1"),
    'Mistral-7B-Instruct-v0.2': AutoTokenizer.from_pretrained("mistralai/Mistral-7B-Instruct-v0.2"),
    'falcon-7b-instruct': AutoTokenizer.from_pretrained("tiiuae/falcon-7b-instruct"),
    'Llama-2-7b-chat-hf': AutoTokenizer.from_pretrained("meta-llama/Llama-2-7b-chat-hf"),
    'Smaug-72B-v0.1': AutoTokenizer.from_pretrained("abacusai/Smaug-72B-v0.1"),
    'mt5': AutoTokenizer.from_pretrained("google/mt5-small")
}
Ensuite, nous sélectionnerons les langues et leurs phrases connues à tester. Si vous souhaitez ajouter une autre langue au test, incluez-la simplement comme nouvelle entrée dans le dictionnaire ci-dessous.
sentences = {
    'English': 'Call me Ishmael. Some years ago...',
    'German': 'Da steh ich nun, ich armer Tor!...',
    'French': "On ne voit bien qu'avec le cœur...",
    'Spanish': "En un lugar de la Mancha...",
    'Polish': 'Litwo, ojczyzno moja!...',
    'Ukrainian': 'Як умру, то поховайте мене...',
    'Greek': 'ἄνδρα μοι ἔννεπε, Μοῦσα...',
    'Hebrew': 'בְּרֵאשִׁית בָּרָא אֱלֹהִים...',
    'Arabic': "حدثني أبي، عن جدي...",
    'Hindi': "कर्मण्येवाधिकारस्ते...",
    'Chinese': "道可道,非常道。名可名,非常名。",
    'Japanese': "私は、その男の写真を三葉..."
}
Ensuite, définissons le processus de test :
def tokenizer_test(sentences):
    results = {}
    for model_name, tokenizer in tokenizers.items():
        results[model_name] = {}
        for language, sentence in sentences.items():
            token_list = tokenizer.tokenize(sentence)
            results[model_name][language] = {
                'length': len(token_list),
                'tokens': token_list
            }
    return results

results = tokenizer_test(sentences)
Résultats : longueur du jeton par modèle et langue
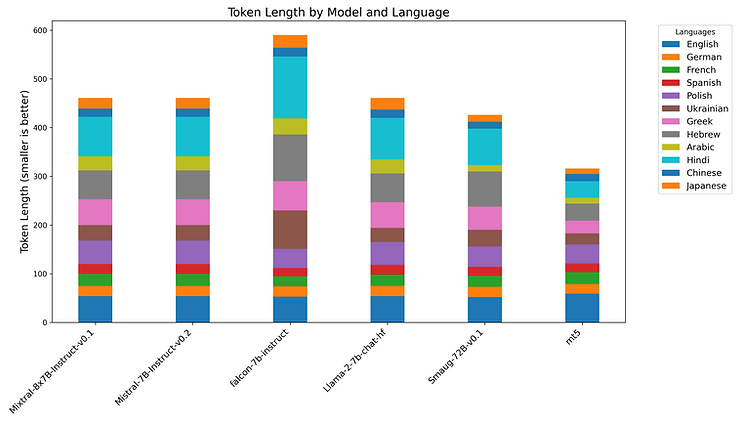
Il est important de noter qu’un nombre plus faible de tokens indique généralement un tokenizer plus efficace : à entrée identique, une séquence plus courte traduit souvent une meilleure représentation du contexte. Pour les LLM, les séquences courtes sont également plus simples à traiter que les longues.
| Langue | Mixtral | Mistral | Falcon | Llama-2 | Smaug | mt5 |
|---|---|---|---|---|---|---|
| Anglais | 54 | 54 | 53 | 54 | 52 | 59 |
| Allemand | 21 | 21 | 21 | 21 | 21 | 20 |
| Français | 25 | 25 | 21 | 23 | 23 | 24 |
| Espagnol | 20 | 20 | 17 | 20 | 18 | 18 |
| polonais | 48 | 48 | 39 | 47 | 42 | 39 |
| ukrainien | 32 | 32 | 79 | 29 | 34 | 23 |
| grec | 53 | 53 | 60 | 53 | 48 | 26 |
| hébreu | 59 | 59 | 96 | 59 | 72 | 35 |
| arabe | 29 | 29 | 33 | 29 | 13 | 12 |
| Hindi | 81 | 81 | 127 | 85 | 75 | 34 |
| Chinois | 17 | 17 | 18 | 17 | 14 | 15 |
| japonais | 22 | 22 | 26 | 24 | 14 | 11 |
Valeurs inférieures = meilleure tokenisation. Les valeurs en surbrillance indiquent le meilleur tokenizer pour cette langue.
Tailles du vocabulaire
Chaque tokenizer est livré avec une taille de vocabulaire différente, ce qui influence la quantité de données requise pour affiner le LLM. Comparons ces tailles de vocabulaire.
vocab_sizes = {name: tokenizer.vocab_size for name, tokenizer in tokenizers.items()}

plt.figure(figsize=(10, 6))
plt.bar(range(len(vocab_sizes)), list(vocab_sizes.values()), tick_label=list(vocab_sizes.keys()))
plt.ylabel('Vocabulary Size')
plt.title('Vocabulary Sizes of Various Tokenizers')
plt.show()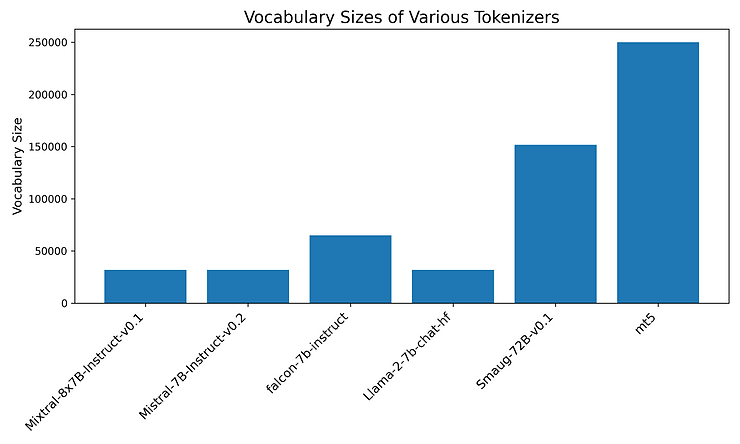
Conclusions
La qualité remarquable de la tokenisation de mt5 peut être largement attribuée à la taille étendue de son vocabulaire. Cependant, l’efficacité d’un tokenizer ne se limite pas à sa taille. Par exemple, même si la taille du vocabulaire de Smaug est nettement supérieure à celle de Llama-2, leurs performances de tokenisation sont relativement similaires.
Il est clair qu’aucun des LLM populaires n’égale l’efficacité du tokenizer de mt5, falcon-7b-instruct se montrant particulièrement inefficace en moyenne. Pour certaines langues, notamment romanes et germaniques, les modèles restent comparables. Mais dès que l’on s’éloigne de ces familles linguistiques, les performances des LLM populaires sur les tâches multilingues chutent fortement. Un tokenizer multilingue médiocre rend le fine-tuning sur ces usages presque impossible.
Dans nos projets, nous avons essayé d’adapter Llama-2 à des tâches multilingues à l’aide d’un vaste jeu de données soigneusement préparé, représentant plus d’un milliard de tokens, avant de devoir basculer vers mt5 en cours de projet.
Étant donné que mt5 n'est qu'un modèle de base et nécessite des efforts substantiels pour lui apprendre à suivre les instructions, il nécessite un ensemble de données volumineux et de haute qualité. Nos clients ont eu la chance de disposer d’une telle ressource, mais dans l’ensemble, il s’agit d’un atout rare et inaccessible au public.
Malgré le paysage impressionnant des LLM, il reste une lacune pour un modèle multilingue performant. La conception des tokenizers dans les LLM en libre accès les plus puissants limite intrinsèquement leur efficacité dans certaines langues, et ce problème ne peut pas être surmonté avec une formation supplémentaire. Actuellement, la formation de mt5 à partir du modèle de base semble être l'approche la plus prometteuse pour parvenir à un modèle véritablement multilingue. Sans cela, créer un LLM en libre accès et véritablement multilingue reste un défi presque impossible.
Building your custom LLM could enhance data security and compliance and enable an AI competitive advantage for your product. Check our other posts: what the network effect is and how AI enables it, how to build an AI competitive advantage, what culture helps, what to avoid, and more.
Construire l’IA pour les marchés non anglophones ?
La conception du Tokenizer limite fondamentalement les capacités multilingues de la plupart des LLM. Déterminons le modèle et la stratégie de formation adaptés à vos besoins linguistiques.