
Fine-tuning di Llama 3.1 con SWIFT: multi-GPU
Unsloth si è imposto come una delle librerie più interessanti per il fine-tuning dei large language model. Riduce in modo significativo sia l’uso di memoria GPU sia i tempi di training. Ne abbiamo parlato in dettaglio nel nostro precedente articolo "Come fare fine-tuning di Llama 3.1 con Unsloth".
Unsloth, però, ha anche dei limiti. Il principale è che al momento supporta soltanto il training su una singola GPU.
Che cosa fare, quindi, quando il training su una sola GPU non basta più, perché è troppo lento o perché il workload supera la capacità anche delle GPU più avanzate? In questo articolo presentiamo SWIFT, un’alternativa solida a Unsloth che consente un fine-tuning multi-GPU efficiente di Llama 3.1.
Che cos’è SWIFT?
SWIFT è una libreria avanzata sviluppata da ModelScope per il training dei large language model. Copre l’intero spettro delle attività: pre-training, fine-tuning, reinforcement learning from human feedback (RLHF), inferenza, valutazione e deployment. Con SWIFT è possibile lavorare con oltre 300 LLM e più di 50 modelli multimodali di grandi dimensioni.
SWIFT non si limita alle funzioni base di training: supporta anche approcci leggeri come il Parameter-Efficient Fine-Tuning (PEFT) e include una libreria completa di adapter con tecniche recenti come NEFTune, LoRA+ e LLaMA-PRO.
Per rendere la piattaforma accessibile anche a chi è meno esperto di deep learning, SWIFT offre un’interfaccia web semplice basata su Gradio. In questo articolo vedremo come fare fine-tuning di Llama 3.1 con SWIFT su infrastruttura RunPod.
Preparare l’ambiente RunPod
Accedete alla console di RunPod, aprite la sezione "Pods" e fate clic su "Deploy". Per questa dimostrazione useremo la Community Cloud. Se però avete requisiti di sicurezza più rigidi, valutate la Secure Cloud di RunPod.
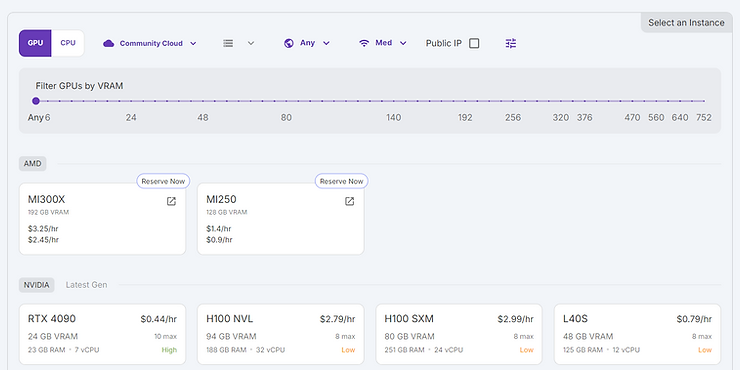
Per il nostro esempio useremo un’istanza multi-GPU. Scegliamo 2 GPU RTX A6000, perché ciascuna A6000 offre 48 GB di memoria GPU, più che sufficienti per la maggior parte degli LLM di taglia medio-piccola.
Useremo l’immagine RunPod PyTorch 2.4.0, che al momento della stesura è la versione più aggiornata disponibile. Per contenere i costi, utilizzeremo istanze Spot.
Quando lavorate con le GPU, avete bisogno di spazio di archiviazione aggiuntivo. RunPod offre due tipi di storage:
- Container Disk: Storage temporaneo, che viene cancellato ogni volta che fermate il container.
- Volume Disk: Storage persistente, che conserva i dati anche se il container viene riavviato o un’istanza Spot viene terminata. Per impostazione predefinita è montata in /workspace.
Installare SWIFT
La documentazione ufficiale di SWIFT propone un’installazione semplice tramite PyPI. Tuttavia, se la eseguite a partire da settembre 2024, molto probabilmente incontrerete il seguente errore:
Failed to import swift.trainers.trainers because of the following error:
Failed to import modelscope.msdatasets because of the following error:
cannot import name 'ftp_head' from 'datasets.utils.file_utils'
Per risolvere il problema, installate SWIFT con questo comando:
pip install --upgrade --force-reinstall --no-cache-dir \
  git+https://github.com/modelscope/ms-swift.git@88dab2b6625280e813bd8835662e1d2be24a3132
Addestrare Llama 3.1 con SWIFT
Create un nuovo notebook Jupyter e verificate che l’installazione funzioni correttamente:
from swift import Trainer, TrainingArgumentsA questo punto eseguite gli import necessari:
from swift import Trainer, TrainingArguments
from modelscope import MsDataset, AutoTokenizer
from modelscope import AutoModelForCausalLM
from modelscope import snapshot_download
from swift import Swift, LoraConfig, get_peft_model
from swift.llm import get_template, TemplateType, register_template, Template, TEMPLATE_MAPPING
import torch
import wandb
from datasets import load_dataset
from transformers import BitsAndBytesConfig
from trl import SFTTrainer, DataCollatorForCompletionOnlyLM
A differenza di altri framework, SWIFT è pensato per lavorare con modelli ospitati su ModelScope, non su Hugging Face:
model_name = 'LLM-Research/Meta-Llama-3.1-8B-Instruct'
model = AutoModelForCausalLM.from_pretrained(
    model_name, torch_dtype=torch.bfloat16,
    device_map='auto', trust_remote_code=True
)
tokenizer = AutoTokenizer.from_pretrained(model_name, trust_remote_code=True)
tokenizer.pad_token_id = 12488
train_set = load_dataset("yahma/alpaca-cleaned", split="train")Uniformare la lunghezza degli esempi di training
SWIFT offre diversi template di prompt già pronti. Tuttavia, l’elaborazione del dataset basata su template non applica automaticamente truncation e padding. Se volete usare più esempi di training per GPU, tutti gli esempi devono avere la stessa lunghezza.
def create_prompt_formats(sample, test=False):
    result = f"""<|start_header_id|>system<|end_header_id|>

You are a helpful assistant.<|eot_id|><|start_header_id|>user<|end_header_id|>

{sample['instruction']}<|eot_id|><|start_header_id|>assistant<|end_header_id|>

"""
    if not test:
        result += f"""{sample['output']}<|eot_id|>"""
    sample["prompt"] = result
    return sample
def preprocess_batch(batch, tokenizer, max_length, truncation, padding):
return tokenizer(
batch['prompt'],
max_length=max_length,
truncation=truncation,
padding='max_length' if padding else False
)def preprocess_dataset(tokenizer, max_length, seed, dataset, truncation, padding, test):
print("Preprocessing dataset...")
_create_prompt_formats = partial(create_prompt_formats, test=test)
dataset = dataset.map(_create_prompt_formats)
_preprocessing_function = partial(
preprocess_batch, max_length=max_length,
tokenizer=tokenizer, truncation=truncation, padding=padding
)
dataset = dataset.map(_preprocessing_function, batched=True)
dataset = dataset.shuffle(seed=seed)
return datasetPer individuare la lunghezza massima più adatta, elaboriamo inizialmente il dataset senza truncation né padding:
exploration_set = preprocess_dataset(
    tokenizer=tokenizer, max_length=128000, seed=seed,
    dataset=train_set, truncation=False, padding=False, test=False
)

lengths = [len(entry['input_ids']) for entry in exploration_set]
plt.hist(lengths, bins=30, color='blue', edgecolor='black')
plt.title('Histogram of Lengths of input_ids')
plt.xlabel('Length of input_ids')
plt.ylabel('Frequency')
plt.show()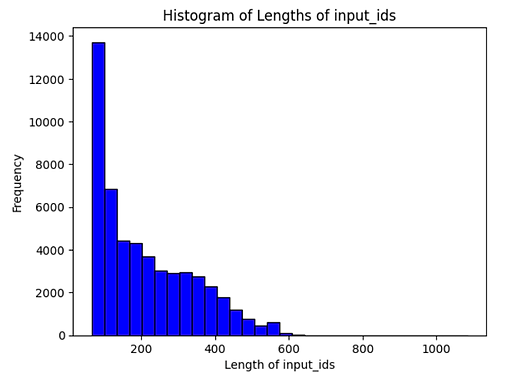
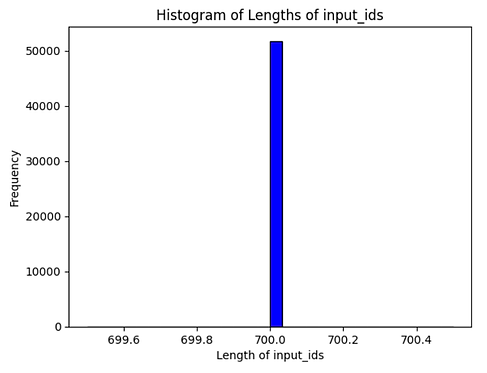
Come mostra l’istogramma, la maggior parte degli esempi del dataset Alpaca, dopo la conversione nel formato di prompt di Llama 3.1, resta sotto i 700 token. Impostiamo quindi la lunghezza massima a 700 token:
train_set_processed = preprocess_dataset(
    tokenizer=tokenizer, max_length=max_length, seed=seed,
    dataset=train_set, truncation=True, padding=True, test=False
)
Configurare i parametri LoRA
lora_config = LoraConfig(
    r=4,
    target_modules=["q_proj", "k_proj", "v_proj", "o_proj",
                     "gate_proj", "up_proj", "down_proj"],
    lora_alpha=8,
    lora_dropout=0.05
)

model = Swift.prepare_model(model, lora_config)
Configurare il data collator
response_template = "<|start_header_id|>assistant<|end_header_id|>"
collator = DataCollatorForCompletionOnlyLM(response_template, tokenizer=tokenizer)
Definire la configurazione di training
train_args = TrainingArguments(
    output_dir='output',
    learning_rate=1e-4,
    num_train_epochs=2,
    eval_steps=500,
    save_steps=500,
    optim="adamw_8bit",
    fp16=True,
    evaluation_strategy='steps',
    save_strategy='steps',
    log_level="debug",
    dataloader_num_workers=16,
    per_device_train_batch_size=1,
    gradient_accumulation_steps=16,
    logging_steps=1,
)
Inizializzare il trainer e avviare il training
trainer = Trainer(
    model=model,
    args=train_args,
    train_dataset=train_set_processed,
    tokenizer=tokenizer,
    data_collator=collator
)

trainer.train()
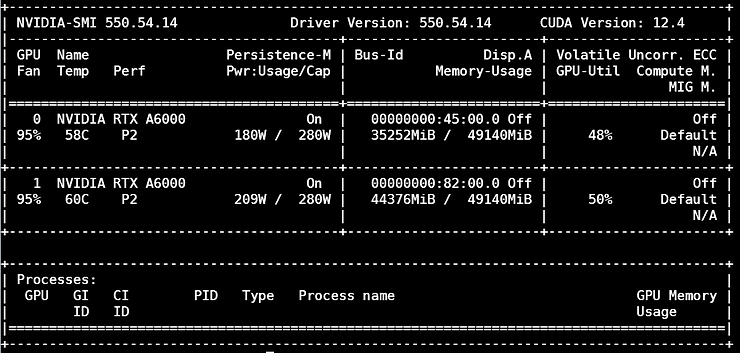
Durante il training è utile monitorare l’utilizzo della GPU con il comando nvidia-smi:
Trovate il codice completo di questo tutorial nel nostro Colab.
Conclusione
Sviluppare un vostro LLM personalizzato può migliorare sicurezza dei dati e compliance, oltre a creare un vantaggio competitivo concreto per il vostro prodotto. Per approfondire, leggete anche questi articoli correlati:
- Come fare il fine-tuning di Llama 3.1 con Unsloth
- Low-Rank Adaptation (LoRA) per un fine-tuning efficiente
- Perché vi serve una strategia AI?
- Strategie AI che creano un vantaggio competitivo sostenibile
Vi serve un fine-tuning multi-GPU per il vostro progetto LLM?
Definiamo insieme l’infrastruttura di training e la strategia di fine-tuning più adatte al vostro modello linguistico personalizzato.