
Guida per professionisti LLM: modelli multilingui
Quindi volete fare fine-tuning di un large language model per la vostra lingua. Da quale modello conviene partire?
Il mondo degli LLM open-access si sta espandendo a ritmi altissimi, e quasi ogni settimana compare un nuovo leader nei benchmark. Al momento della stesura di questo articolo, l’Open LLM Leaderboard di Hugging Face incorona un nuovo campione: Smaug LLM. È un mercato estremamente dinamico, che ricorda per certi versi il vivacissimo ecosistema dei cloni IBM PC tra la fine degli anni Ottanta e l’inizio dei Novanta.
Nonostante la varietà apparente, molti di questi modelli condividono la stessa base. Smaug, per esempio, deriva da Qwen-72B. Il fine-tuning consente di modificare in profondità il comportamento di un modello, ma c’è un elemento che non potete cambiare: il tokenizer.
Abbiamo lavorato direttamente su personalizzazione, fine-tuning e deployment di diversi LLM open-access. In questa serie condividiamo quello che abbiamo imparato sul campo: cosa sanno fare questi modelli, dove si fermano e quali pratiche funzionano davvero nel fine-tuning.
Guida per professionisti LLM:
- Quanto è davvero multilingue Llama-2?
- Quanto sono multilingui Falcon, Mistral, Smaug e gli altri LLM?
In un articolo precedente abbiamo analizzato il tokenizer di Llama-2 e spiegato perché fatica su alcune lingue. Qui allarghiamo il confronto: testiamo i tokenizer di sei fra gli LLM più popolari su dodici lingue diverse, per capire quali modelli siano davvero più adattabili a seconda della lingua target. Condividiamo anche il codice usato per l’esperimento, così potrete aggiungere facilmente anche le vostre lingue di interesse.
Tutti i large language model, siano essi proprietari come ChatGPT o open source, elaborano le informazioni sotto forma di numeri. Per interpretare un testo devono prima convertirlo in una rappresentazione numerica. Il problema centrale del NLP è trovare il modo più efficiente per rappresentare una lingua come sequenza di numeri.
Un approccio molto semplice assegna un numero a ogni lettera o simbolo. Il modello prova poi a prevedere il numero successivo. Ma questo metodo trasforma rapidamente una frase breve in una sequenza molto lunga, e un singolo errore all’inizio può compromettere tutto ciò che segue.
Per risolvere questo problema si usa la tokenizzazione: le parole vengono suddivise in unità più piccole, o token, ricorrenti in molti contesti. Così il modello non deve più prevedere ogni lettera o ogni parola intera, ma sequenze più corte e gestibili. Riducendo drasticamente il numero di opzioni da considerare, il processo diventa molto più efficiente e più accurato.
Setup del test: sei modelli, dodici lingue
Vediamo ora come i tokenizer degli LLM più popolari gestiscono lingue diverse. Testeremo i seguenti modelli:
- Mixtral-8x7B-Instruct-v0.1
- Mistral-7B-Instruct-v0.2
- falcon-7b-instruct
- Llama-2-7b-chat-hf
- Smaug-72B-v0.1
- mt5
Abbiamo incluso mt5 perché possiede uno dei migliori tokenizer multilingui oggi disponibili. Per questo è un ottimo benchmark con cui confrontare gli altri modelli della lista.
Per prima cosa importiamo i tokenizer:
from transformers import AutoTokenizer

tokenizers = {
    'Mixtral-8x7B-Instruct-v0.1': AutoTokenizer.from_pretrained("mistralai/Mixtral-8x7B-Instruct-v0.1"),
    'Mistral-7B-Instruct-v0.2': AutoTokenizer.from_pretrained("mistralai/Mistral-7B-Instruct-v0.2"),
    'falcon-7b-instruct': AutoTokenizer.from_pretrained("tiiuae/falcon-7b-instruct"),
    'Llama-2-7b-chat-hf': AutoTokenizer.from_pretrained("meta-llama/Llama-2-7b-chat-hf"),
    'Smaug-72B-v0.1': AutoTokenizer.from_pretrained("abacusai/Smaug-72B-v0.1"),
    'mt5': AutoTokenizer.from_pretrained("google/mt5-small")
}
Poi selezioniamo un insieme di lingue e una frase nota per ciascuna. Se volete aggiungere un’altra lingua al test, vi basta inserirla come nuova voce nel dizionario.
sentences = {
    'English': 'Call me Ishmael. Some years ago...',
    'German': 'Da steh ich nun, ich armer Tor!...',
    'French': "On ne voit bien qu'avec le cœur...",
    'Spanish': "En un lugar de la Mancha...",
    'Polish': 'Litwo, ojczyzno moja!...',
    'Ukrainian': 'Як умру, то поховайте мене...',
    'Greek': 'ἄνδρα μοι ἔννεπε, Μοῦσα...',
    'Hebrew': 'בְּרֵאשִׁית בָּרָא אֱלֹהִים...',
    'Arabic': "حدثني أبي، عن جدي...",
    'Hindi': "कर्मण्येवाधिकारस्ते...",
    'Chinese': "道可道,非常道。名可名,非常名。",
    'Japanese': "私は、その男の写真を三葉..."
}
A questo punto definiamo il processo di test:
def tokenizer_test(sentences):
    results = {}
    for model_name, tokenizer in tokenizers.items():
        results[model_name] = {}
        for language, sentence in sentences.items():
            token_list = tokenizer.tokenize(sentence)
            results[model_name][language] = {
                'length': len(token_list),
                'tokens': token_list
            }
    return results

results = tokenizer_test(sentences)
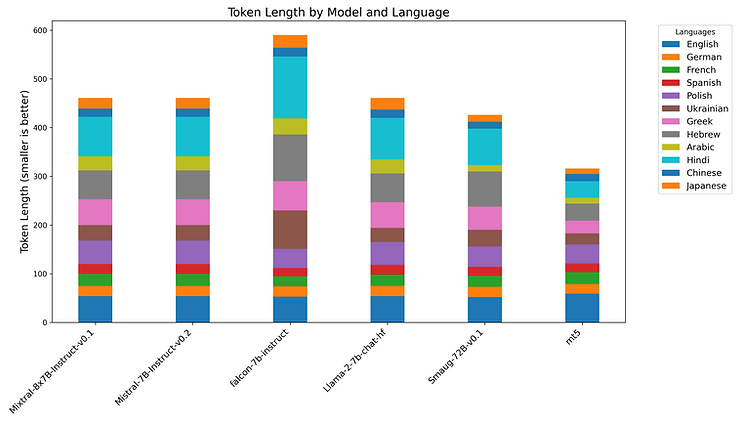
Risultati: lunghezza dei token per modello e lingua
In generale, un numero inferiore di token indica un tokenizer più efficiente: a parità di input, una sequenza più corta segnala una rappresentazione migliore del contesto. Per un LLM, inoltre, gestire sequenze più brevi è più semplice e più economico.
| Lingua | Mixtral | Mistral | Falcon | Llama-2 | Smaug | mt5 |
|---|---|---|---|---|---|---|
| Inglese | 54 | 54 | 53 | 54 | 52 | 59 |
| Tedesco | 21 | 21 | 21 | 21 | 21 | 20 |
| Francese | 25 | 25 | 21 | 23 | 23 | 24 |
| Spagnolo | 20 | 20 | 17 | 20 | 18 | 18 |
| Polacco | 48 | 48 | 39 | 47 | 42 | 39 |
| Ucraino | 32 | 32 | 79 | 29 | 34 | 23 |
| Greco | 53 | 53 | 60 | 53 | 48 | 26 |
| Ebraico | 59 | 59 | 96 | 59 | 72 | 35 |
| Arabo | 29 | 29 | 33 | 29 | 13 | 12 |
| Hindi | 81 | 81 | 127 | 85 | 75 | 34 |
| Cinese | 17 | 17 | 18 | 17 | 14 | 15 |
| Giapponese | 22 | 22 | 26 | 24 | 14 | 11 |
Valori più bassi = tokenizzazione migliore. I valori evidenziati indicano il miglior tokenizer per quella lingua.
Dimensioni del vocabolario
Ogni tokenizer ha una dimensione di vocabolario diversa, e questo influisce sulla quantità di dati necessaria per il fine-tuning. Confrontiamo quindi anche le dimensioni del vocabolario.
vocab_sizes = {name: tokenizer.vocab_size for name, tokenizer in tokenizers.items()}

plt.figure(figsize=(10, 6))
plt.bar(range(len(vocab_sizes)), list(vocab_sizes.values()), tick_label=list(vocab_sizes.keys()))
plt.ylabel('Vocabulary Size')
plt.title('Vocabulary Sizes of Various Tokenizers')
plt.show()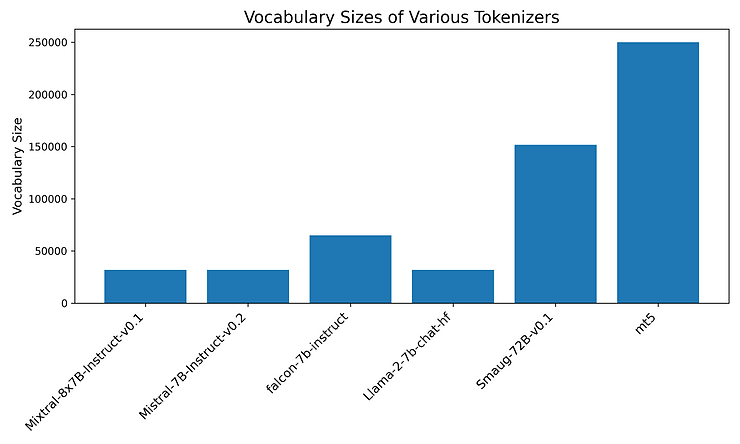
Conclusioni
L’ottima qualità della tokenizzazione di mt5 dipende in larga parte dalla sua ampia dimensione di vocabolario. Ma l’efficacia di un tokenizer non si riduce solo a quello. Per esempio, anche se Smaug ha un vocabolario molto più grande di Llama-2, le prestazioni di tokenizzazione dei due modelli restano piuttosto simili.
È evidente che nessuno degli LLM più popolari eguaglia l’efficienza del tokenizer di mt5. In media, falcon-7b-instruct risulta particolarmente inefficiente. Per alcune lingue, soprattutto romanze e germaniche, i modelli si comportano in modo simile. Ma quando usciamo da queste famiglie linguistiche, le prestazioni dei modelli più popolari crollano. Con un tokenizer multilingue debole, il fine-tuning su questi casi diventa quasi impraticabile.
Nei nostri progetti abbiamo provato a fare fine-tuning di Llama-2 per task multilingui usando un dataset molto ampio e accuratamente curato, superiore a un miliardo di token, per poi dover comunque passare a mt5 a metà del lavoro.
mt5, però, è disponibile solo come base model e richiede un lavoro significativo per imparare a seguire istruzioni. Questo significa che servono dataset grandi e di alta qualità. Alcuni nostri clienti disponevano di una risorsa del genere, ma nel complesso si tratta di un asset raro e quasi mai pubblico.
Nonostante l’impressionante evoluzione del mercato, manca ancora un modello davvero forte sul piano multilingue. Il design del tokenizer nei migliori LLM open-access limita in modo strutturale l’efficacia su molte lingue, e questo limite non si supera semplicemente con altro training. Oggi, partire da mt5 e addestrarlo dal base model resta probabilmente la strada più promettente verso un vero LLM multilingue.
Costruire un LLM personalizzato può migliorare sicurezza dei dati, compliance e vantaggio competitivo del prodotto. Negli altri articoli approfondiamo che cos’è l’effetto rete e come l’AI lo abilita, come costruire un vantaggio competitivo AI, quale cultura aiuta, cosa evitare e altro ancora.
State costruendo soluzioni AI per mercati non anglofoni?
Il design del tokenizer limita in modo strutturale le capacità multilingui della maggior parte degli LLM. Identifichiamo insieme il modello e la strategia di training più adatti alle vostre lingue target.