
Llama 3.3 mit Hugging Face TGI beschleunigen
Das Open-Access-Ökosystem für große Sprachmodelle (LLMs) wächst rasant. Im Juli 2024 stellte Meta Llama 3.1 vor, ein beeindruckendes Modell mit 405 Milliarden Parametern, das die Grenzen der LLM-Leistung verschob. Nur fünf Monate später, im Dezember 2024, veröffentlichte Meta Llama 3.3, eine kompakte Version mit nur 70 Milliarden Parametern.
Obwohl es fast sechsmal kleiner ist, erreicht Llama 3.3 die Leistung seines größeren Vorgängers. Es übertrifft GPT-4o bei mehreren Aufgaben, während es bis zu 50-mal günstiger und 10-mal schneller als OpenAIs Modell ist.
Was Llama 3.3 wirklich spannend macht, ist seine Fine-Tuning-Fähigkeit. Sie können es mit Ihren eigenen Daten trainieren, um es für Ihre spezifischen Anforderungen noch effektiver zu machen.
Dieser Blog konzentriert sich auf die Schaffung eines Wettbewerbsvorteils mit KI. Wenn Sie sicherstellen wollen, dass Ihre Konkurrenten Ihr Produkt nicht einfach replizieren können, müssen Sie Ihre eigenen KI-Modelle trainieren. Llama 3.3 ist eine hervorragende Option für Anwendungen, die Text oder Konversationen beinhalten.
Aber sobald Ihr Modell feinabgestimmt ist, stellt sich die nächste Herausforderung: Wie setzen Sie es ein? Wie können Sie sicherstellen, dass Ihr LLM hohe Leistung liefert, sich in Standardtools integriert und sicher innerhalb Ihrer Organisation funktioniert?
Huggingface Text Generation Inference
Das Huggingface-Ökosystem bietet viel mehr als nur Repositories für Modelle und Datensätze. Mit Text Generation Inference (TGI) können Sie Ihr feinabgestimmtes LLM für schnelle, effiziente und sichere Inferenz einsetzen.
TGI ist für den Unternehmenseinsatz optimiert und ermöglicht Ihnen:
- Modelle mit einem einfachen Launcher bereitstellen.
- Produktionsreife Leistung mit Funktionen wie verteiltem Tracing (OpenTelemetry) und Prometheus-Metriken erzielen.
- Tensor-Parallelismus für schnellere Inferenz über mehrere GPUs nutzen.
- Tokens in Echtzeit mit Server-Sent Events (SSE) streamen.
- Quantisierung mit Tools wie bitsandbytes und GPT-Q zur Leistungsoptimierung anwenden.
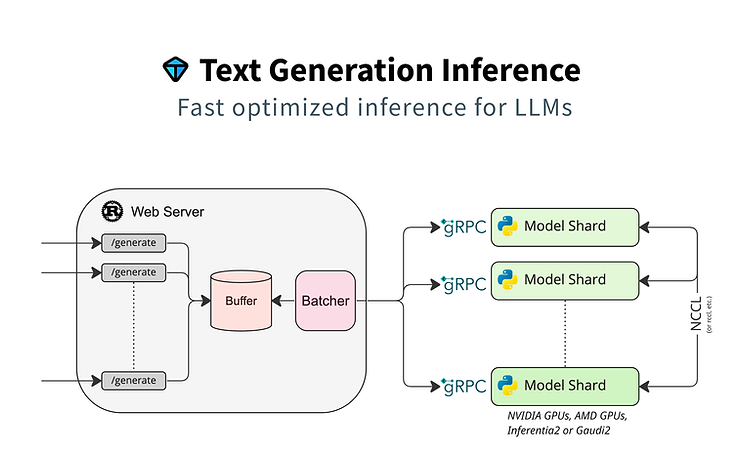
TGI betreibt auch HuggingChat, einen kostenlosen KI-Chatbot, mit dem Sie Modelle wie Llama 3.3 ausprobieren können.
TGI ist in Rust geschrieben, was es für Inferenz-Aufgaben hochoptimiert macht. Es unterstützt Out-of-the-Box-Konnektoren für Tools wie LangChain und gewährleistet eine nahtlose Integration mit Standardbibliotheken. Ob Sie Geschwindigkeit, Skalierbarkeit oder Einfachheit suchen, TGI liefert.
In diesem Blog demonstrieren wir die Llama 3.3 Inferenz mit Standard-Transformers, setzen es dann mit TGI ein und vergleichen die Generierungsgeschwindigkeit.
Bereitstellung mit Hyperstack
Für diese Demonstration verwenden wir Hyperstack, einen GPU-Cloud-Anbieter, der NVIDIA H100 GPUs zu einem wettbewerbsfähigen Preis von 1,90 $ pro Stunde anbietet.
Schritt 1: Wählen Sie Ihre GPU
Um Llama 3.3 effektiv auszuführen, benötigen wir mindestens zwei NVIDIA H100 GPUs mit jeweils 80 GB GPU-Speicher. Während es technisch möglich ist, Llama 3.3 auf einer einzigen H100 GPU auszuführen, müssten die Modellgewichte zwischen GPU und CPU aufgeteilt werden. Dieses Setup erhöht die Antwortzeiten drastisch, oft über 10 Minuten pro Anfrage, was für die meisten Anwendungen unpraktisch ist.
Schritt 2: Betriebssystem wählen
Wählen Sie als Nächstes ein Betriebssystem, das Docker enthält. Docker ist für den reibungslosen Betrieb von TGI unerlässlich.
Schritt 3: Fernzugriff aktivieren
Aktivieren Sie bei der Konfiguration Ihrer virtuellen Maschine (VM) sowohl SSH-Zugriff für sichere Befehlszeilenverwaltung als auch eine öffentliche IP-Adresse, um Remoteverbindungen während des Experiments zu ermöglichen.
Schritt 4: VM bereitstellen
Sobald Ihre Konfiguration abgeschlossen ist, klicken Sie auf Deploy. Innerhalb von Sekunden ist Ihre VM einsatzbereit. Um den Fernzugriff für das Jupyter Notebook zu ermöglichen, konfigurieren Sie eine Ingress-Regel für den gewünschten Port. In dieser Demonstration verwenden wir Port 10000.
Llama 3.3 Inferenz mit Transformers
Zunächst testen wir die Inferenzgeschwindigkeit von Llama 3.3 mit der Standard-Transformers-Bibliothek. Später setzen wir dasselbe Modell mit TGI ein, um die Leistung zu vergleichen.
Schritt 1: Llama 3.3 Modell laden
Hyperstack bietet 750 GB temporären Speicher pro GPU, was uns mit zwei H100 GPUs insgesamt 1,5 TB Speicher gibt. Beachten Sie, dass Llama 3.3 ein Gated-Modell ist. Sie müssen den Zugang bei Huggingface oder direkt bei Meta beantragen.
pip3 install packaging huggingface_hub[cli]
huggingface-cli login --token <YOUR_HUGGINGFACE_TOKEN>
Als Nächstes laden Sie das Modell:
from transformers import AutoTokenizer, AutoModelForCausalLM
import torch

model_name = 'meta-llama/Llama-3.3-70B-Instruct'

tokenizer = AutoTokenizer.from_pretrained(
    model_name, trust_remote_code=True, cache_dir="/ephemeral/"
)

model = AutoModelForCausalLM.from_pretrained(
    model_name, trust_remote_code=True, torch_dtype=torch.bfloat16,
    device_map="auto", cache_dir="/ephemeral/"
)
Schritt 2: Datensatz laden
Für diese Demonstration verwenden wir den Alpaca-Datensatz:
from datasets import load_dataset

train_set = load_dataset("yahma/alpaca-cleaned", split="train")
Mit der Transformers-Bibliothek müssen Sie die Eingabe gemäß der Prompt-Struktur von Llama formatieren:
def create_prompt_formats(sample):
    result = f"""<|start_header_id|>system<|end_header_id|>

You are a helpful assistant.<|eot_id|><|start_header_id|>user<|end_header_id|>

{sample['instruction']}<|eot_id|><|start_header_id|>assistant<|end_header_id|>
"""
    sample["prompt"] = result
    return sample

train_set_processed = train_set.map(create_prompt_formats)
terminators = [tokenizer.eos_token_id]Schritt 3: Inferenzgeschwindigkeit messen
Um die Inferenzgeschwindigkeit zu testen, führen wir das Modell auf den ersten 10 Eingaben des Alpaca-Datensatzes aus:
import time
from statistics import mean

transformers_processing_time = []

for i in range(10):
    start_time = time.time()
    data_point = train_set_processed[i]
    inputs = tokenizer(data_point['prompt'], return_tensors="pt",
                       add_special_tokens=False).to('cuda')
    outputs = model.generate(
        input_ids=inputs['input_ids'],
        attention_mask=inputs['attention_mask'],
        max_new_tokens=30000,
        pad_token_id=18610,
        eos_token_id=terminators
    )
    processing_time = time.time() - start_time
    transformers_processing_time.append(processing_time)

print(mean(transformers_processing_time))
# Output: ~30.37 seconds
Im Durchschnitt dauert es mit diesem Ansatz etwa 30 Sekunden pro Beispiel.
Schritt 4: Test mit Transformers Pipeline
Die Transformers-Pipeline vereinfacht die Batch-Verarbeitung. Schauen wir, ob sie die Leistung verbessert:
from transformers import pipeline

pipe = pipeline("text-generation", model=model, tokenizer=tokenizer)

generation_args = {
    "max_new_tokens": 30000,
    "return_full_text": True,
    "temperature": 0.0,
    "do_sample": False,
}

transformers_pipeline_processing_time = []

for i in range(10):
    start_time = time.time()
    data_point = train_set_processed[i]
    output = pipe(data_point['prompt'], **generation_args)
    processing_time = time.time() - start_time
    transformers_pipeline_processing_time.append(processing_time)

print(mean(transformers_pipeline_processing_time))
# Output: ~28.31 seconds
Die Pipeline reduziert die durchschnittliche Verarbeitungszeit leicht, aber es dauert immer noch etwa 28–30 Sekunden pro Beispiel.
Llama 3.3 Inferenz mit TGI
Jetzt testen wir Llama 3.3 mit TGI. Stellen Sie vor dem Start sicher, dass Ihre Python-Kernel gestoppt und Ihr GPU-Speicher vollständig freigegeben ist.
Schritt 1: TGI Docker-Container starten
model=meta-llama/Llama-3.3-70B-Instruct
volume=/ephemeral/data

docker run --gpus all --shm-size=1g \
  -e HUGGING_FACE_HUB_TOKEN=<YOUR_HUGGINGFACE_TOKEN> \
  -v $volume:/data \
  -d -p 8080:80 \
  ghcr.io/huggingface/text-generation-inference:3.0.1 \
  --model-id $model --num-shard 2
Wenn Sie diesen Befehl ausführen, wird Docker den TGI-Container pullen, die Llama 3.3 Gewichte herunterladen und die erforderlichen Shards starten. Sobald das Modell betriebsbereit ist, sehen Sie folgende Log-Nachricht:
INFO text_generation_router::server: router/src/server.rs:2402: ConnectedSchritt 2: Mit TGI verbinden
from langchain.prompts import SystemMessagePromptTemplate, \
    HumanMessagePromptTemplate, ChatPromptTemplate
from langchain_huggingface import HuggingFaceEndpoint
from langchain_experimental.chat_models.llm_wrapper import ChatWrapper
import time
from statistics import mean
Schritt 3: Prompts einrichten
class Llama3Chat(ChatWrapper):
    @property
    def _llm_type(self) -> str:
        return "meta-llama/Llama-3.3-70B-Instruct"
    sys_beg: str = "<|begin_of_text|><|start_header_id|>system<|end_header_id|>\n\n"
    sys_end: str = "<|eot_id|>"
    ai_n_beg: str = ""
    ai_n_end: str = "<|eot_id|>"
    usr_n_beg: str = "<|start_header_id|>user<|end_header_id|>\n\n"
    usr_n_end: str = "<|eot_id|><|start_header_id|>assistant<|end_header_id|>\n\n"
    usr_0_beg: str = "<|start_header_id|>user<|end_header_id|>\n\n"
    usr_0_end: str = "<|eot_id|><|start_header_id|>assistant<|end_header_id|>\n\n"
def get_response():
system_template = "You are a helpful assistant."
user_template = "{message}"
messages = [
SystemMessagePromptTemplate.from_template(system_template),
HumanMessagePromptTemplate.from_template(user_template)
]
return ChatPromptTemplate(messages=messages)Schritt 4: LangChain mit TGI verbinden
llm = Llama3Chat(
    llm=HuggingFaceEndpoint(
        endpoint_url="http://127.0.0.1:8080",
        task="text-generation",
        max_new_tokens=10000,
        huggingfacehub_api_token="<YOUR_HUGGINGFACE_TOKEN>"
    )
)
Schritt 5: Inferenzgeschwindigkeit testen
tgi_processing_time = []

for i in range(10):
    start_time = time.time()
    data_point = train_set[i]
    response = llm.invoke({'message': data_point['instruction']}).strip()
    processing_time = time.time() - start_time
    tgi_processing_time.append(processing_time)

print(mean(tgi_processing_time))
# Output: ~14.21 seconds
Im Durchschnitt verarbeitet TGI jede Eingabe in 14,2 Sekunden \u2014 mehr als doppelt so schnell wie die 28\u201330 Sekunden mit der Transformers-Bibliothek.
TGI bietet eine erhebliche Leistungssteigerung und halbiert die Inferenzzeiten. Neben Llama 3.3 unterstützt TGI Modelle wie Mistral, Mixtral, Gemma, Qwen, Falcon und mehr, alle mit der gleichen beeindruckenden Effizienz. Mit TGI können Sie leistungsstarke Modelle auf Ihrer eigenen Infrastruktur einsetzen und sicherstellen, dass keine Daten Ihren Sicherheitsperimeter verlassen.
Ein eigenes benutzerdefiniertes LLM könnte die Datensicherheit und Compliance verbessern und einen KI-Wettbewerbsvorteil für Ihr Produkt ermöglichen. Lesen Sie unsere anderen Beiträge:
- Was ist der Netzwerkeffekt und wie ermöglicht KI ihn
- Wie Sie einen KI-Wettbewerbsvorteil aufbauen
- Welche Kultur beim Aufbau der richtigen KI-Produkte hilft
- Was Sie in Ihrer KI-Strategie vermeiden sollten
Bereit, LLMs auf Ihrer eigenen Infrastruktur einzusetzen?
Von der Modellauswahl bis zur Inferenz-Optimierung — lassen Sie uns eine sichere und leistungsstarke KI-Deployment-Pipeline für Ihr Produkt aufbauen.