
Llama 3.1 mit SWIFT: Multi-GPU-Fine-Tuning
Unsloth hat als Bibliothek f\u00FCr das Fine-Tuning gro\u00DFer Sprachmodelle (LLMs) an Popularit\u00E4t gewonnen. Sie reduziert sowohl den GPU-Speicherverbrauch als auch die Trainingszeit erheblich. Wir haben Unsloth ausf\u00FChrlich in unserem fr\u00FCheren Blogbeitrag \u201EWie man Llama 3.1 mit Unsloth feinabstimmt\u201C behandelt.
Allerdings hat Unsloth seine Einschränkungen. Die bemerkenswerteste ist, dass es derzeit nur Single-GPU-Training unterstützt.
Was können Sie also tun, wenn Single-GPU-Training für Ihr Projekt nicht ausreicht – entweder weil es zu langsam ist oder die Kapazität selbst der fortschrittlichsten GPUs überschreitet? In diesem Beitrag stellen wir SWIFT vor, eine robuste Alternative zu Unsloth, die effizientes Multi-GPU-Training für das Fine-Tuning von Llama 3.1 ermöglicht.
Was ist SWIFT?
SWIFT ist eine hochmoderne Bibliothek, die von ModelScope f\u00FCr das Training gro\u00DFer Sprachmodelle entwickelt wurde. Sie unterst\u00FCtzt das gesamte Aufgabenspektrum: Pre-Training, Fine-Tuning, Reinforcement Learning from Human Feedback (RLHF), Inferenz, Evaluierung und Deployment. Mit SWIFT k\u00F6nnen Sie nahtlos mit \u00FCber 300 LLMs und mehr als 50 multimodalen Modellen arbeiten.
SWIFT geht über grundlegende Trainingsfähigkeiten hinaus und unterstützt leichtgewichtige Lösungen wie Parameter-Efficient Fine-Tuning (PEFT). Es enthält auch eine umfassende Adapter-Bibliothek mit den neuesten Techniken wie NEFTune, LoRA+ und LLaMA-PRO.
Um die Plattform auch f\u00FCr Deep-Learning-Einsteiger zug\u00E4nglich zu machen, bietet SWIFT eine benutzerfreundliche Weboberfl\u00E4che auf Basis von Gradio. In diesem Blogbeitrag f\u00FChren wir Sie durch den Prozess des Fine-Tunings von Llama 3.1 mit SWIFT auf RunPod-Infrastruktur.
RunPod-Umgebung einrichten
Melden Sie sich bei der RunPod-Konsole an, navigieren Sie zu „Pods“ und klicken Sie auf „Deploy“. Für diese Demonstration verwenden wir die Community Cloud. Wenn Sie jedoch strenge Sicherheitsanforderungen haben, ziehen Sie RunPods Secure-Cloud-Option in Betracht.
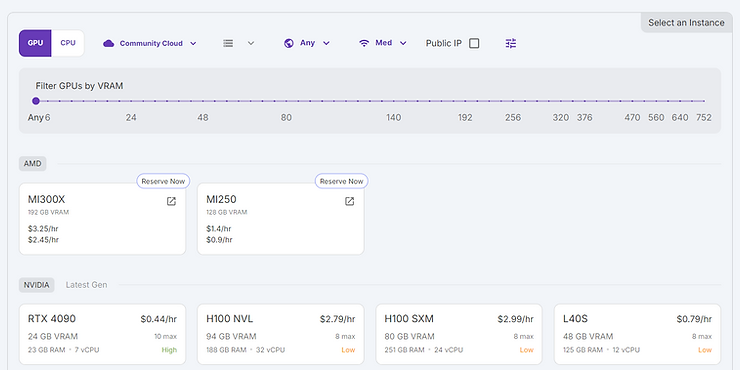
Für unser Beispiel verwenden wir eine Multi-GPU-Instanz. Wir wählen 2 x RTX A6000 GPUs, da jede A6000 48 GB GPU-Speicher bietet – ausreichend für die meisten kleineren LLMs.
Wir verwenden das RunPod PyTorch 2.4.0-Image, die zum Zeitpunkt des Schreibens neueste Version. Um Kosten zu optimieren, verwenden wir Spot-Instanzen.
Beim Arbeiten mit GPUs benötigen Sie zusätzlichen Speicher. RunPod bietet zwei Speichertypen:
- Container Disk: Temporärer Speicher, der bei jedem Stoppen des Containers gelöscht wird.
- Volume Disk: Persistenter Speicher, der Daten auch bei Neustart des Containers oder Beendigung einer Spot-Instanz behält. Standardmäßig unter /workspace gemountet.
SWIFT installieren
Die offizielle SWIFT-Dokumentation schlägt eine einfache Installation über das PyPI-Paket vor. Wenn Sie es jedoch ab September 2024 ausführen, werden Sie auf folgenden Fehler stoßen:
Failed to import swift.trainers.trainers because of the following error:
Failed to import modelscope.msdatasets because of the following error:
cannot import name 'ftp_head' from 'datasets.utils.file_utils'
Um dies zu beheben, installieren Sie SWIFT mit:
pip install --upgrade --force-reinstall --no-cache-dir \
  git+https://github.com/modelscope/ms-swift.git@88dab2b6625280e813bd8835662e1d2be24a3132
Llama 3.1 mit SWIFT trainieren
Erstellen Sie ein neues Jupyter Notebook und testen Sie Ihre Installation:
from swift import Trainer, TrainingArgumentsFühren Sie dann die notwendigen Imports durch:
from swift import Trainer, TrainingArguments
from modelscope import MsDataset, AutoTokenizer
from modelscope import AutoModelForCausalLM
from modelscope import snapshot_download
from swift import Swift, LoraConfig, get_peft_model
from swift.llm import get_template, TemplateType, register_template, Template, TEMPLATE_MAPPING
import torch
import wandb
from datasets import load_dataset
from transformers import BitsAndBytesConfig
from trl import SFTTrainer, DataCollatorForCompletionOnlyLM
Im Gegensatz zu anderen Frameworks ist SWIFT f\u00FCr die Arbeit mit Modellen auf ModelScope konzipiert, nicht Hugging Face:
model_name = 'LLM-Research/Meta-Llama-3.1-8B-Instruct'
model = AutoModelForCausalLM.from_pretrained(
    model_name, torch_dtype=torch.bfloat16,
    device_map='auto', trust_remote_code=True
)
tokenizer = AutoTokenizer.from_pretrained(model_name, trust_remote_code=True)
tokenizer.pad_token_id = 12488
train_set = load_dataset("yahma/alpaca-cleaned", split="train")Trainingsbeispiele auf einheitliche Länge verarbeiten
SWIFT bietet eine Vielzahl vorgefertigter LLM-Prompt-Templates. Template-basierte Datensatzverarbeitung verfügt jedoch nicht über Standard-Truncation- und Padding-Parameter. Bei der Verwendung mehrerer Trainingsbeispiele pro GPU müssen alle Beispiele die gleiche Länge haben.
def create_prompt_formats(sample, test=False):
    result = f"""<|start_header_id|>system<|end_header_id|>

You are a helpful assistant.<|eot_id|><|start_header_id|>user<|end_header_id|>

{sample['instruction']}<|eot_id|><|start_header_id|>assistant<|end_header_id|>

"""
    if not test:
        result += f"""{sample['output']}<|eot_id|>"""
    sample["prompt"] = result
    return sample
def preprocess_batch(batch, tokenizer, max_length, truncation, padding):
return tokenizer(
batch['prompt'],
max_length=max_length,
truncation=truncation,
padding='max_length' if padding else False
)def preprocess_dataset(tokenizer, max_length, seed, dataset, truncation, padding, test):
print("Preprocessing dataset...")
_create_prompt_formats = partial(create_prompt_formats, test=test)
dataset = dataset.map(_create_prompt_formats)
_preprocessing_function = partial(
preprocess_batch, max_length=max_length,
tokenizer=tokenizer, truncation=truncation, padding=padding
)
dataset = dataset.map(_preprocessing_function, batched=True)
dataset = dataset.shuffle(seed=seed)
return datasetUm die optimale maximale Länge zu finden, verarbeiten wir den Datensatz zunächst ohne Truncation oder Padding:
exploration_set = preprocess_dataset(
    tokenizer=tokenizer, max_length=128000, seed=seed,
    dataset=train_set, truncation=False, padding=False, test=False
)

lengths = [len(entry['input_ids']) for entry in exploration_set]
plt.hist(lengths, bins=30, color='blue', edgecolor='black')
plt.title('Histogram of Lengths of input_ids')
plt.xlabel('Length of input_ids')
plt.ylabel('Frequency')
plt.show()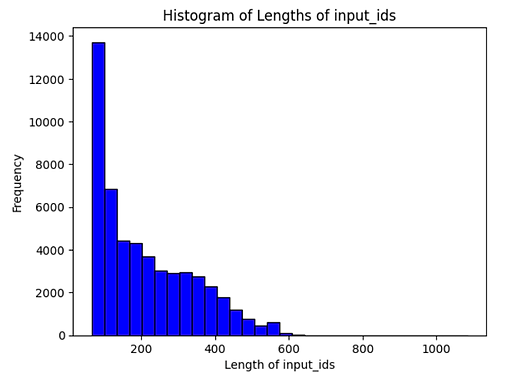
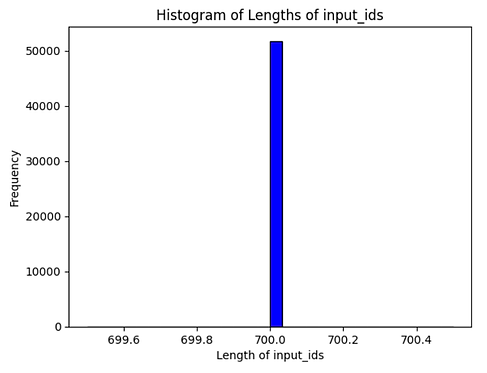
Wie im Histogramm zu sehen, liegen die meisten Beispiele im Alpaca-Datensatz nach Konvertierung ins Llama-3.1-Prompt-Format unter 700 Tokens. Wir setzen die maximale Länge auf 700 Tokens:
train_set_processed = preprocess_dataset(
    tokenizer=tokenizer, max_length=max_length, seed=seed,
    dataset=train_set, truncation=True, padding=True, test=False
)
LoRA-Parameter konfigurieren
lora_config = LoraConfig(
    r=4,
    target_modules=["q_proj", "k_proj", "v_proj", "o_proj",
                     "gate_proj", "up_proj", "down_proj"],
    lora_alpha=8,
    lora_dropout=0.05
)

model = Swift.prepare_model(model, lora_config)
Data Collator einrichten
response_template = "<|start_header_id|>assistant<|end_header_id|>"
collator = DataCollatorForCompletionOnlyLM(response_template, tokenizer=tokenizer)
Trainingskonfiguration definieren
train_args = TrainingArguments(
    output_dir='output',
    learning_rate=1e-4,
    num_train_epochs=2,
    eval_steps=500,
    save_steps=500,
    optim="adamw_8bit",
    fp16=True,
    evaluation_strategy='steps',
    save_strategy='steps',
    log_level="debug",
    dataloader_num_workers=16,
    per_device_train_batch_size=1,
    gradient_accumulation_steps=16,
    logging_steps=1,
)
Trainer initialisieren und Training starten
trainer = Trainer(
    model=model,
    args=train_args,
    train_dataset=train_set_processed,
    tokenizer=tokenizer,
    data_collator=collator
)

trainer.train()
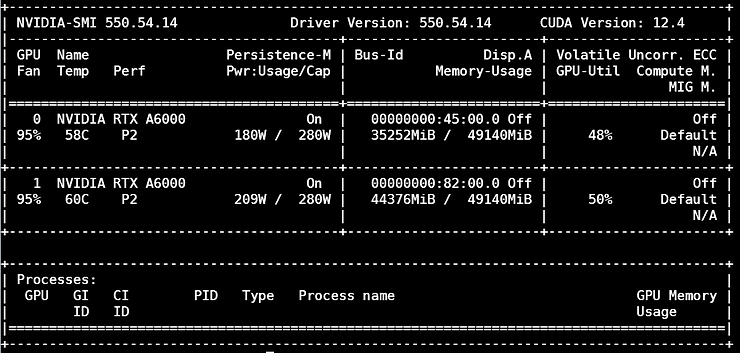
Während des Trainings ist es nützlich, die GPU-Auslastung mit dem nvidia-smi-Befehl zu überwachen:
Den vollst\u00E4ndigen Code f\u00FCr dieses Tutorial finden Sie in unserem Colab.
Fazit
Die Entwicklung Ihres eigenen benutzerdefinierten LLM könnte die Datensicherheit und Compliance verbessern und einen KI-Wettbewerbsvorteil für Ihr Produkt ermöglichen. Lesen Sie unsere anderen Beiträge für weitere Einblicke:
- Wie man Llama 3.1 mit Unsloth feinabstimmt
- Low-Rank Adaptation (LoRA) für effizientes Fine-Tuning
- Warum brauchen Sie eine KI-Strategie?
- KI-Strategien für einen nachhaltigen Wettbewerbsvorteil
Brauchen Sie Multi-GPU Fine-Tuning für Ihr LLM-Projekt?
Lassen Sie uns die richtige Trainingsinfrastruktur und Fine-Tuning-Strategie für Ihr benutzerdefiniertes Sprachmodell entwerfen.