
¿Puede ChatGPT crear una ventaja competitiva?
Sergii Shelpuk · Socio director
En los últimos seis meses, ChatGPT ha arrasado en Internet. Este producto OpenAI de primera categoría superó el millón de usuarios en sólo cinco días, estableciendo un nuevo récord entre los productos de Internet. Las redes sociales y fuentes acreditadas están llenas de debates sobre si ChatGPT y tecnologías similares alterarán industrias enteras y revolucionarán el lugar de trabajo.
Ahora surge la pregunta: ¿ChatGPT ofrece alguna ventaja competitiva para su empresa? Alternativamente, ¿debería preocuparse de que sus competidores puedan apoderarse de una parte de su participación de mercado utilizando ChatGPT? Profundicemos en este asunto.
¿Puede ChatGPT generar una ventaja competitiva para su empresa?
La clave para lograr una ventaja sostenible radica en poseer algo que no pueda replicarse fácilmente: activos, conexiones, reputación, marca o un diseño empresarial único. En las últimas décadas, las tecnologías de aprendizaje automático y de inteligencia artificial han demostrado que los datos pueden convertirse en una ventaja competitiva sostenible. Este proceso funciona en ciclo: la IA convierte sus datos propietarios en valor percibido para el producto. A medida que ese valor crece, también aumenta el volumen de datos propietarios, creando un bucle de retroalimentación positiva que culmina en un producto extremadamente difícil de imitar. El posicionamiento competitivo óptimo para un producto de IA puede visualizarse así:
- Debe ofrecer un producto superior para captar participación de mercado de un producto de IA.
- Dado que el valor proviene de los modelos de IA, se necesitan mejores modelos.
- Dado que los modelos de IA modernos se entrenan con aprendizaje automático sobre datos, se necesitan más datos.
- Como los datos provienen del uso del producto, necesita un producto mejorado.
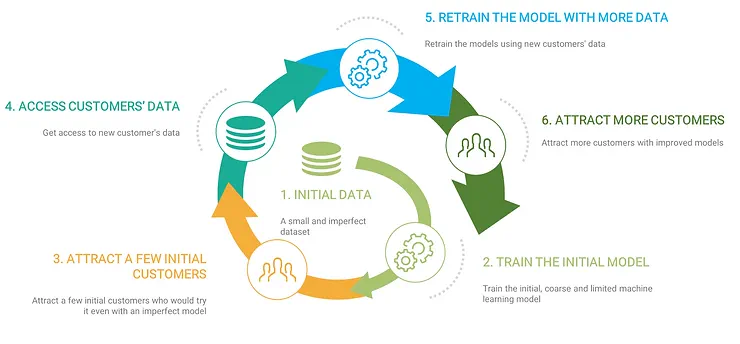
Este diseño estratégico disuade efectivamente a los competidores, incluso en el caso de productos como la Búsqueda de Google y YouTube, que, de ser reproducibles, impulsarían a una empresa a un territorio de billones de dólares. Sin embargo, su posición en el mercado sigue siendo firme hoy: los competidores potenciales o comprenden la inutilidad de la batalla antes de que comience o aprenden por las malas a través de intentos inútiles.
Volvamos ahora a ChatGPT, un producto OpenAI en su forma actual. ¿Dónde encaja dentro de este ciclo?
Un sistema de IA debería mejorar su rendimiento a medida que se entrena con más datos. Sin embargo, ChatGPT es un producto inmutable: no puede entrenarlo con sus datos propietarios. La ingeniería de prompts se parece más a la programación que al entrenamiento de modelos, lo que implica que sus prompts pueden ser copiados por ingenieros cualificados o incluso por sus competidores. Desde esta perspectiva, ChatGPT se parece más a una hoja de cálculo sofisticada: puede aportar valor y ahorrar tiempo, pero no crea una ventaja competitiva sostenible para su empresa.
Para establecer una ventaja competitiva, su sistema de IA debe estar entrenado con datos propietarios, datos que posee su empresa y que son difíciles de adquirir para los competidores. Eso hace que su sistema de IA sea distinto del que sus competidores pueden entrenar sin acceso a sus datos.
Todo lo que envíe a ChatGPT puede acabar en los conjuntos de datos de OpenAI y contribuir al rendimiento del producto, no solo para su empresa, sino también para sus competidores. La extracción de datos de entrenamiento desde modelos de lenguaje sigue siendo un reto abierto, por lo que conviene asumir que cualquier dato compartido con ChatGPT puede quedar potencialmente expuesto. Desde esta perspectiva, enviar datos propietarios a ChatGPT suele hacer justo lo contrario de construir una ventaja competitiva: diluye el valor exclusivo de esos datos.
En resumen, ChatGPT es un producto de inteligencia artificial que no puede personalizar entrenándolo con sus propios datos. Aunque OpenAI pueda mejorar el modelo aprovechando sus datos propietarios, esos beneficios (y potencialmente parte de esos datos) no quedan solo en su empresa, sino que acaban llegando también al mercado.
Puede y debe utilizar ChatGPT para mejorar la eficiencia cuando corresponda. Aún así, no debe confundirse con tecnologías de inteligencia artificial que tienen el potencial de convertir a su empresa en un líder del mercado en su industria; ChatGPT no puede cumplir ese papel.
Modelos de lenguajes grandes (LLM)
De hecho, es evidente que ChatGPT por sí solo no puede proporcionarle una ventaja competitiva. Sin embargo, ¿qué pasa con otros modelos de lenguaje grandes? ¿Es posible desarrollar su propio sistema parecido a ChatGPT e iniciar el círculo virtuoso de la IA?
Examinemos las tecnologías que generan oportunidades para las ventajas competitivas de la IA. En primer lugar, tenemos aquellos que permiten construir este círculo virtuoso utilizando nuevos tipos de datos. El momento "Eureka" llegó con AlexNet en la competencia ImageNet de 2012, donde las redes neuronales convolucionales alcanzaron un nivel de sofisticación que les permitió extraer valor de vastos conjuntos de datos de imágenes del mundo real, un desafío con el que lucharon los anteriores algoritmos de visión por computadora basados en extractores de características. En palabras simples, demostró que se puede construir un negocio sustentable y defendible con un producto que recopila fotografías del mundo real y al mismo tiempo las utiliza para mejorarse con redes neuronales convolucionales. Quienes captaron este concepto desde el principio identificaron rápidamente nichos aplicables y los capitalizaron. Un excelente ejemplo es Blue River Technology, que surgió poco después del avance de AlexNet y aplicó las redes neuronales convolucionales recientemente disponibles a imágenes de campos agrícolas.
Ahora, volvamos a los modelos de lenguajes grandes (LLM). ¿Habilitan el círculo virtuoso de la IA para nuevos tipos de datos?
El LLM, similar a ChatGPT, se capacita en tres etapas.
En la primera etapa, se desarrolla un modelo de lenguaje entrenando el modelo Transformer para predecir la siguiente palabra en función del texto anterior de una longitud específica (para ChatGPT, era 2048 palabras). En esta etapa, el modelo puede completar automáticamente el texto de entrada, pero carece de la capacidad de entablar un diálogo o responder a solicitudes.
En la segunda etapa, entrena el modelo para responder a las solicitudes de los usuarios en un conjunto de datos pequeño y de alta calidad de "pregunta-respuesta". El modelo resultante se denomina modelo SFT (ajuste fino supervisado).
La tercera etapa es el aprendizaje por refuerzo a partir de la retroalimentación humana (RLHF). En pocas palabras, esto implica solicitar al LLM que clasifique diferentes respuestas, reflejando su proximidad al resultado esperado. Básicamente, RLHF transforma el LLM en el asistente tipo chat que tenemos hoy.
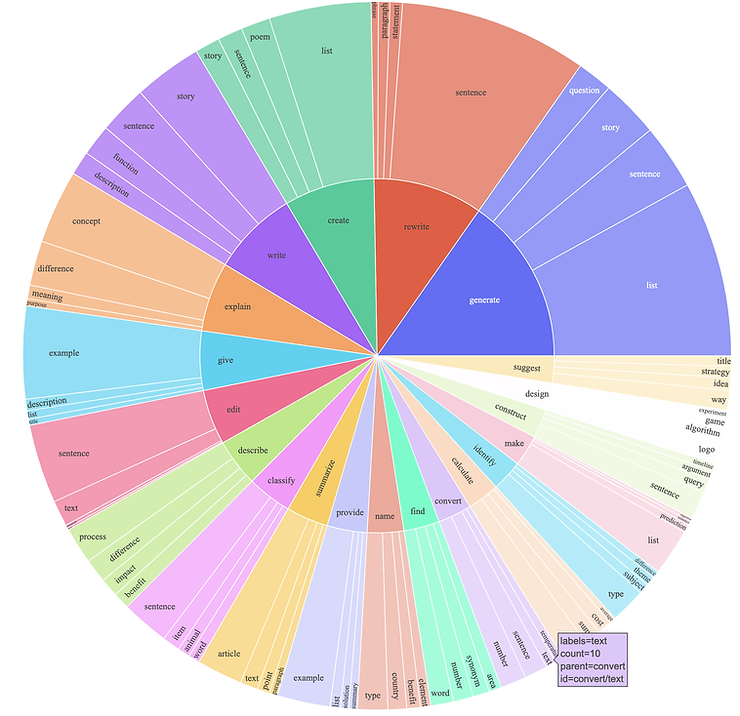
¿Alguna de estas tecnologías abre nuevos nichos al permitir nuevos tipos de datos, similar al avance de AlexNet?
Entrenar un LLM para predecir la siguiente palabra puede ser un proceso exigente y costoso. El coste estimado para entrenar GPT-3 desde cero supera los 4 millones de dólares y el entrenamiento puede tardar hasta 9 días. Muy pocas empresas pueden asumir ese nivel de gasto de forma recurrente (y el modelo debe reentrenarse para aprovechar nuevos datos propietarios). Además, aunque existan arquitecturas LLM más pequeñas y rentables, un modelo que solo predice la siguiente palabra tiene utilidad limitada, incluso con datos propietarios: todavía necesita habilitar capacidades conversacionales mediante RLHF.
Aquí reside una oportunidad intrigante: la capacitación de "preguntas-respuestas" (SFT) y la tecnología RLHF en realidad pueden generar una ventaja competitiva sostenible.
Si puede imaginar un producto que ofrezca valor a través de capacidades de chat o asistente y que simultáneamente genere datos aplicables a RLHF a partir de las interacciones de los usuarios, es posible que esté en algo importante.
De esta manera, su producto mejorará con nuevos datos de métricas de calidad de "pregunta-respuesta" o respuesta y, a su vez, generará más datos de entrenamiento a medida que mejora su rendimiento.
Es difícil determinar el tamaño de esta oportunidad. Claramente, existen nichos específicos donde se puede obtener dicha retroalimentación, principalmente en el mercado de ayudas para la escritura, donde operan empresas como Grammarly. Queda por ver con qué facilidad las tecnologías LLM pueden alterar este mercado obvio. Sin embargo, si desea evaluar su propia idea de inicio basada en un LLM o la de otra persona, considere dos preguntas:
- ¿Cómo las mejoras de LLM aportan más valor a los usuarios?
- ¿Cómo generan los usuarios datos de entrenamiento cuando utilizan el producto?
Si al menos uno de ellos no tiene una buena respuesta, es probable que sea difícil construir un negocio defendible en torno a esta idea.
Competencia entre LLM
Desde el explosivo debut de los LLM, destacados gigantes tecnológicos han entrado en escena. Microsoft invirtió la asombrosa cantidad de 10 mil millones de dólares en OpenAI e incorporó ChatGPT a su motor de búsqueda Bing. Google presentó Bard, mientras que Meta abrió el modelo de lenguaje grande LLaMA, entre otros desarrollos notables. Muchos ven los LLM como un potencial disruptor en el mercado de búsqueda en línea, un área que durante mucho tiempo ha estado dominada por la Búsqueda de Google. Para comprender mejor sus esfuerzos, apliquemos la lógica de la ventaja competitiva.
Bucle de retroalimentación
ChatGPT muestra una notable competencia en diversas tareas, incluida la codificación, un tema que a menudo genera debates sobre la automatización de la ingeniería de software. Sin embargo, estas capacidades dependen en gran medida de los datos de entrenamiento de RLHF. OpenAI, por ejemplo, emplea ingenieros de software dedicados a producir dichos datos resolviendo desafíos de programación similares a los que se encuentran en LeetCode y brindando explicaciones detalladas en lenguaje humano. Además, la empresa contrata un número significativo de etiquetadores de datos para crear otras formas de datos de entrenamiento RLHF. Hay rumores de que Google extrae datos RLHF de ChatGPT para entrenar sus propios LLM. Sin embargo, desde la perspectiva de la ventaja competitiva de la IA, estos enfoques tienen fallas inherentes.
Si bien el etiquetado de datos manual puede generar datos de capacitación sustanciales, un diseño de producto que genere datos RLHF directamente a través de las interacciones del usuario como parte de su recorrido puede superar el etiquetado manual a través de un circuito de retroalimentación más sólido.
OpenAI intentó solucionar este problema introduciendo una función de "me gusta/no me gusta" en ChatGPT. Sin embargo, que me gusten o no las respuestas del chat no es un aspecto esencial del recorrido del usuario: puedo beneficiarme del producto sin expresar explícitamente mi preferencia.
Acceso a datos
Además, una ventaja competitiva robusta en IA debe construirse sobre datos propietarios que sean difíciles de conseguir para la competencia. El dominio de Google Search se explica, en gran parte, por el uso de su histórico de consultas e interacciones, reforzado por enormes volúmenes de datos procedentes de otros productos de Alphabet. Correos de Gmail, búsquedas e interacciones en YouTube, navegación en Chrome y uso en Android alimentan modelos de usuario altamente refinados. Esos modelos personalizados, combinados con cada consulta, permiten ofrecer resultados cada vez más relevantes. Cuanto mejor funciona el buscador, más se utiliza y más datos acumula. Ahí reside la fortaleza de los productos de IA de Alphabet: en un conjunto de datos exclusivo y difícil de replicar.
¿OpenAI, Google o cualquier otra empresa poseen datos de capacitación únicos o un diseño de producto que los genera? No es así.
Alternativas de código abierto
Considere el próspero ecosistema de LLM de código abierto y chats de LLM que ha florecido durante los últimos seis meses. Hay cientos de LLM de código abierto, muchos de los cuales se pueden utilizar comercialmente. Estos modelos son más pequeños, más rentables de entrenar y, lo más importante, personalizables, ya que la ventaja competitiva radica en tener un modelo único. La capacitación previa de código abierto y los conjuntos de datos RLHF están disponibles y diariamente surgen nuevos desarrollos. En este entorno, ni OpenAI, Google ni Microsoft poseen una asimetría distintiva que les permitiría crear LLM superiores y al mismo tiempo sería un desafío replicar por otras empresas o incluso ingenieros individuales.
Curiosamente, incluso Google, una empresa muy versada en la construcción de ventajas competitivas de la IA, parece reconocer esta realidad. En un documento filtrado, el ingeniero de software senior de Google, Luke Sernau, admite que Google carece de una ventaja competitiva en el desarrollo de LLM. El documento señala: "La verdad incómoda es que no estamos posicionados para ganar esta carrera armamentista, y tampoco lo está OpenAI. Mientras hemos estado peleándonos, una tercera facción ha estado comiendo silenciosamente nuestro almuerzo... Estoy hablando, por supuesto, de código abierto". Sernau sugiere que sin una "salsa secreta", el mejor enfoque de Google es aprender de los esfuerzos externos y colaborar con ellos, dando prioridad a las integraciones de terceros. Sernau dijo que los ingenieros de código abierto estaban haciendo cosas con 100 dólares que "nos cuestan" con 10 millones de dólares, "haciéndolo en semanas, no en meses".
En resumen, el desarrollo de LLM generales parece estar más allá del control de cualquier gran empresa individual, incluso las más grandes. Actualmente, ninguno de ellos parece poseer una estrategia infalible para afianzar su posición; esto incluye a Google, que se ha establecido con éxito con la Búsqueda, YouTube y numerosos productos más pequeños.
Una vez más, esto confirma mi sugerencia anterior: encontrar un nicho donde los LLM puedan establecer una ventaja competitiva sostenible que no pueda replicarse rápidamente es un desafío increíble.
¿Qué debería hacer al respecto?
Habiendo comenzado mi carrera en IA mucho antes del revuelo actual e incluso antes del "momento AlexNet" de ImageNet 2012, puedo decir con seguridad que el frenesí actual de ChatGPT incluso abruma a alguien como yo, que conoce bien el campo. Sólo puedo imaginar cómo lo verán quienes están fuera de la industria, con este inmenso zumbido que genera ansiedad y miedo a perderse algo entre muchas personas. Desde el lanzamiento de ChatGPT, numerosos amigos y colegas se han acercado a mí en busca de consejo sobre si deberían preocuparse por sus negocios o incluso por sus carreras.
Permítame brindarle un marco para pensar sobre el desarrollo actual de LLM.
Una buena analogía vale miles de palabras, así que considere los LLM similares a la ola de PC de IBM de los años 1980 y 1990.
Las computadoras personales ganaron tremenda popularidad durante esas décadas, principalmente debido a los procesadores de texto y al software de hojas de cálculo que simplificaban las tareas rutinarias. En 1984, los ingresos de IBM en el mercado de PC excedieron los 4 mil millones de dólares, más del doble que los de Apple. Un estudio realizado en 1983 encontró que dos tercios de los grandes clientes que estandarizaron una computadora optaron por la PC, mientras que sólo el 9% eligió Apple. Una encuesta de Fortune de 1985 reveló que el 56% de las empresas estadounidenses con computadoras personales usaban PC, mientras que el 16% usaba Apple.
Sin embargo, una serie de errores de protección de la propiedad intelectual cometidos por IBM llevaron al surgimiento de toda la industria de clones "compatibles con PC IBM". Esto fue devastador para IBM, pero para el mundo tecnológico, la PC de IBM y sus clones se convirtieron en uno de los acontecimientos más importantes de la historia.
Si usted es un ejecutivo de negocios que contempla el revuelo actual de ChatGPT, póngase en el lugar de sus colegas que vivieron la era de las PC. Sin duda, las PC fueron una gran innovación, ya que automatizaron muchas tareas rutinarias, simplificaron la contabilidad y reemplazaron las máquinas de escribir. Sin embargo, estas máquinas también eran asequibles y fáciles de conseguir.
¿Esperaría que un competidor o una startup joven le expulsara del mercado simplemente por introducir PC en su lugar de trabajo? Para la mayoría, la respuesta es: difícilmente. Al fin y al cabo, usted también puede adquirir esos ordenadores para su empresa cuando lo considere oportuno. Aunque puedan mejorar su negocio, no suponen una amenaza directa para su cuota de mercado.
Y si usted es un empresario que está considerando un nuevo negocio, tenga en cuenta que la industria de clonación de PC de IBM de las décadas de 1980 y 1990 tenía márgenes de ganancia increíblemente bajos.
Si bien usted puede ensamblar y vender sus propias computadoras utilizando componentes compatibles con IBM PC disponibles, todos los demás también pueden hacerlo. En tal escenario, la única forma de competir es a través del precio, lo que en última instancia le lleva a usted y a todos los demás en el mercado a márgenes de beneficio extremadamente reducidos.
Sin embargo, inspírese en Microsoft, que desarrolló sistemas operativos para PC IBM y finalmente transformó Windows en una de las plataformas más exitosas de todos los tiempos. Si puede crear un producto que todo usuario de LLM necesita y desarrollarlo con el concepto de ventaja competitiva sostenible, es posible que a su debido tiempo se encuentre con un negocio próspero. Pero esa es una historia completamente diferente.
Este blog está dedicado a la ventaja competitiva de la IA y estamos haciendo todo lo posible para explicar cómo funciona y cómo puede crear una para su producto o empresa. Puede consultar nuestras otras publicaciones para obtener una explicación detallada de ¿Cuál es el efecto de red? y cómo la IA lo permite, Cómo construir una ventaja competitiva de IA para su empresa, ¿Qué cultura le ayuda a crear los productos de IA adecuados?, Qué evitar en su estrategia y ejecución de IAy más.
¿Necesita ayuda para crear una ventaja competitiva de la IA?
Nuestro equipo de expertos empresariales y consultores en tecnología de IA tiene años de experiencia ayudando a empresas de tecnología como la suya a crear ventajas competitivas sostenibles a través de la tecnología de IA.