
Guía para profesionales de LLM: multilingüismo
Quiere ajustar un modelo de lenguaje grande para su propio idioma. ¿Con qué modelo conviene empezar?
El mundo de los LLM de acceso abierto evoluciona a gran velocidad y casi no pasa una semana sin que aparezca un nuevo líder en los benchmarks. Cuando escribimos este artículo, el Open LLM Leaderboard de Hugging Face acababa de coronar a un nuevo campeón: Smaug LLM. Es un mercado extremadamente dinámico, que recuerda al bullicioso ecosistema de clones del IBM PC de finales de los ochenta y principios de los noventa.
A pesar de la variedad, muchos de estos modelos comparten orígenes comunes. Smaug, por ejemplo, se basa en Qwen-72B. Si bien el ajuste fino permite realizar ajustes significativos en el comportamiento de un modelo, un aspecto que no se puede modificar es su tokenizador.
Hemos estado profundamente involucrados en la personalización, el ajuste y la implementación de varios LLM de acceso abierto. A través de esta serie de publicaciones, nuestro objetivo es compartir nuestros conocimientos sobre lo que pueden y no pueden hacer, junto con instrucciones detalladas y mejores prácticas para realizar ajustes.
Guía para profesionales de LLM:
- ¿Qué tan multilingüe es realmente Llama-2?
- ¿Qué tan multilingües son Falcon, Mistral, Smaug y otros LLM?
En una publicación anterior analizamos el tokenizador de Llama-2 y explicamos por qué falla con determinados idiomas. Hoy ampliamos el experimento: comparamos los tokenizadores de seis de los LLM más populares en 12 idiomas para ver qué modelos se adaptan mejor a cada caso. También compartimos el código fuente de nuestras pruebas para que pueda añadir cualquier idioma que le interese a este benchmark.
Todos los modelos de lenguaje de gran tamaño (LLM), ya sean propietarios como ChatGPT o de código abierto, procesan la información mediante números. Para interpretar el texto, primero lo convierten en una representación numérica. El reto central del procesamiento del lenguaje natural (PLN) consiste en encontrar la manera más eficiente de representar los idiomas como secuencias de números.
Un método sencillo asigna a cada letra o símbolo un número único. Luego, el modelo intenta predecir el siguiente número en una secuencia. Sin embargo, este enfoque puede convertir una frase breve en una secuencia larga de 61 números. Cualquier error al predecir una sola letra puede afectar todas las predicciones posteriores, lo que hace que este método sea complejo y propenso a errores.
Para abordar estos desafíos, los investigadores han desarrollado un método conocido como tokenización. La tokenización divide las palabras en unidades más pequeñas, o tokens, que son comunes a varias palabras. Este enfoque significa que el modelo no tiene que predecir cada letra o palabra completa, sino secuencias de tokens más pequeñas y manejables. Al reducir significativamente la cantidad de opciones que el modelo debe considerar (desde un diccionario completo hasta aproximadamente 2000 tokens para inglés), el proceso se vuelve más eficiente y preciso.
Configuración de prueba: seis modelos, doce idiomas
Examinemos cómo los tokenizadores LLM más populares de la actualidad manejan varios idiomas. Probaremos los siguientes modelos:
- Mixtral-8x7B-Instruct-v0.1
- Mistral-7B-Instruct-v0.2
- falcon-7b-instruct
- Llama-2-7b-chat-hf
- Smaug-72B-v0.1
- mt5
Incluimos el mt5 LLM en nuestra línea porque cuenta con uno de los mejores tokenizadores multilingües, lo que lo convierte en un excelente punto de referencia para comparar los otros modelos de nuestra lista.
Primero, necesitamos importar los tokenizadores:
from transformers import AutoTokenizer

tokenizers = {
    'Mixtral-8x7B-Instruct-v0.1': AutoTokenizer.from_pretrained("mistralai/Mixtral-8x7B-Instruct-v0.1"),
    'Mistral-7B-Instruct-v0.2': AutoTokenizer.from_pretrained("mistralai/Mistral-7B-Instruct-v0.2"),
    'falcon-7b-instruct': AutoTokenizer.from_pretrained("tiiuae/falcon-7b-instruct"),
    'Llama-2-7b-chat-hf': AutoTokenizer.from_pretrained("meta-llama/Llama-2-7b-chat-hf"),
    'Smaug-72B-v0.1': AutoTokenizer.from_pretrained("abacusai/Smaug-72B-v0.1"),
    'mt5': AutoTokenizer.from_pretrained("google/mt5-small")
}
A continuación, seleccionaremos idiomas y sus oraciones conocidas para realizar pruebas. Si está interesado en agregar otro idioma a la prueba, simplemente inclúyalo como una nueva entrada en el diccionario a continuación.
sentences = {
    'English': 'Call me Ishmael. Some years ago...',
    'German': 'Da steh ich nun, ich armer Tor!...',
    'French': "On ne voit bien qu'avec le cœur...",
    'Spanish': "En un lugar de la Mancha...",
    'Polish': 'Litwo, ojczyzno moja!...',
    'Ukrainian': 'Як умру, то поховайте мене...',
    'Greek': 'ἄνδρα μοι ἔννεπε, Μοῦσα...',
    'Hebrew': 'בְּרֵאשִׁית בָּרָא אֱלֹהִים...',
    'Arabic': "حدثني أبي، عن جدي...",
    'Hindi': "कर्मण्येवाधिकारस्ते...",
    'Chinese': "道可道,非常道。名可名,非常名。",
    'Japanese': "私は、その男の写真を三葉..."
}
A continuación, definamos el proceso de prueba:
def tokenizer_test(sentences):
    results = {}
    for model_name, tokenizer in tokenizers.items():
        results[model_name] = {}
        for language, sentence in sentences.items():
            token_list = tokenizer.tokenize(sentence)
            results[model_name][language] = {
                'length': len(token_list),
                'tokens': token_list
            }
    return results

results = tokenizer_test(sentences)
Resultados: longitud del token por modelo e idioma
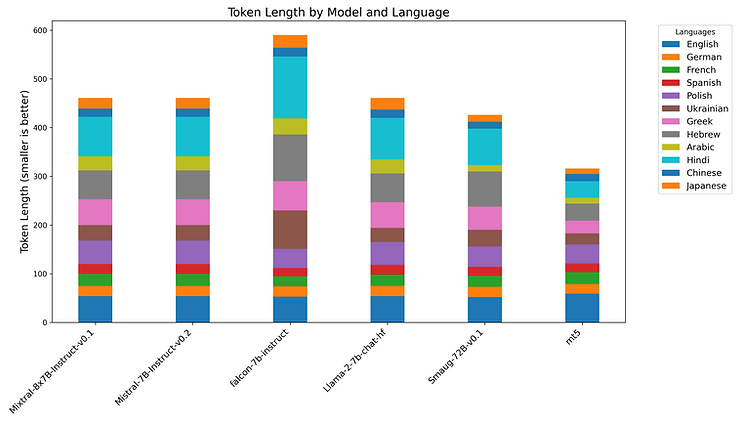
Es importante señalar que una cantidad menor de tokens generalmente indica un tokenizador más eficiente: dada la misma entrada, una lista más corta de tokens sugiere una mejor comprensión del contexto. Para los LLM, trabajar con secuencias más cortas también es más manejable que trabajar con secuencias más largas.
| Idioma | Mixtral | Mistral | Falcon | Llama-2 | Smaug | mt5 |
|---|---|---|---|---|---|---|
| Inglés | 54 | 54 | 53 | 54 | 52 | 59 |
| Alemán | 21 | 21 | 21 | 21 | 21 | 20 |
| Francés | 25 | 25 | 21 | 23 | 23 | 24 |
| Español | 20 | 20 | 17 | 20 | 18 | 18 |
| Polaco | 48 | 48 | 39 | 47 | 42 | 39 |
| ucranio | 32 | 32 | 79 | 29 | 34 | 23 |
| Griego | 53 | 53 | 60 | 53 | 48 | 26 |
| hebreo | 59 | 59 | 96 | 59 | 72 | 35 |
| árabe | 29 | 29 | 33 | 29 | 13 | 12 |
| Hindi | 81 | 81 | 127 | 85 | 75 | 34 |
| Chino | 17 | 17 | 18 | 17 | 14 | 15 |
| japonés | 22 | 22 | 26 | 24 | 14 | 11 |
Valores más bajos = mejor tokenización. Los valores resaltados indican el mejor tokenizador para ese idioma.
Tamaños de vocabulario
Cada tokenizador viene con un tamaño de vocabulario diferente, lo que influye en la cantidad de datos necesarios para ajustar el LLM. Comparemos estos tamaños de vocabulario.
vocab_sizes = {name: tokenizer.vocab_size for name, tokenizer in tokenizers.items()}

plt.figure(figsize=(10, 6))
plt.bar(range(len(vocab_sizes)), list(vocab_sizes.values()), tick_label=list(vocab_sizes.keys()))
plt.ylabel('Vocabulary Size')
plt.title('Vocabulary Sizes of Various Tokenizers')
plt.show()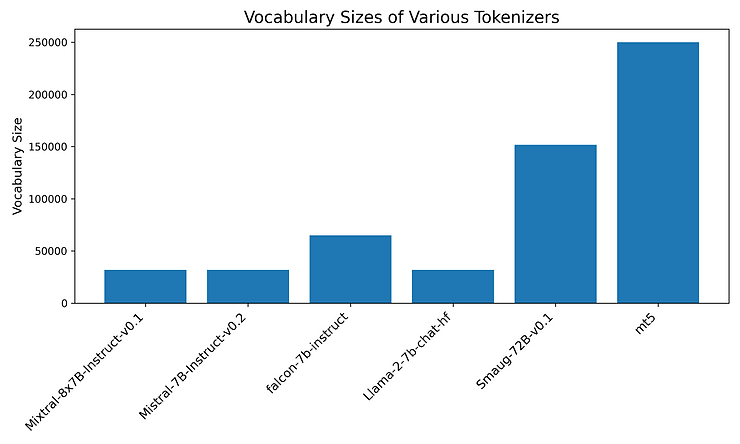
Conclusiones
La notable calidad de la tokenización de mt5 se puede atribuir en gran medida a su extenso vocabulario. Sin embargo, la eficacia de un tokenizador implica algo más que su tamaño. Por ejemplo, aunque el tamaño del vocabulario de Smaug es significativamente mayor que el de Llama-2, su rendimiento de tokenización es relativamente similar.
Está claro que ninguno de los LLM populares iguala la eficiencia del tokenizador de mt5, y que falcon-7b-instruct resulta especialmente ineficiente de media. Para ciertas lenguas, sobre todo dentro de las familias romances y germánicas, los modelos se comportan de forma relativamente parecida. Pero cuando salimos de esas familias lingüísticas, el rendimiento de los LLM más populares en tareas multilingües cae con fuerza. Un tokenizador multilingüe deficiente hace que el ajuste fino para estos casos sea casi inviable.
En nuestros proyectos, intentamos ajustar Llama-2 para tareas multilingües utilizando un conjunto de datos vasto y cuidadosamente seleccionado de más de mil millones de tokens, solo para cambiar a mt5 a mitad del proyecto.
Dado que mt5 solo viene como modelo base y requiere un esfuerzo sustancial para enseñarle a seguir instrucciones, necesita un conjunto de datos grande y de alta calidad. Nuestros clientes tuvieron la suerte de contar con un recurso de este tipo, pero en general es un activo poco común y no disponible públicamente.
A pesar del impresionante panorama de los LLM, todavía existe una brecha para un modelo multilingüe de alto rendimiento. El diseño de tokenizadores en los LLM de acceso abierto más potentes limita inherentemente su efectividad en ciertos idiomas, y esto no es algo que pueda superarse con capacitación adicional. Actualmente, entrenar mt5 a partir del modelo base parece ser el enfoque más prometedor para lograr un modelo verdaderamente multilingüe. Sin él, crear un LLM de acceso abierto que sea genuinamente multilingüe sigue siendo un desafío casi imposible.
Desarrollar su propio LLM puede mejorar la seguridad y el cumplimiento de los datos, además de crear una ventaja competitiva en IA para su producto. Puede leer también nuestras otras publicaciones sobre qué es el efecto red, cómo la IA lo impulsa, cómo construir una ventaja competitiva basada en IA, qué tipo de cultura ayuda, qué conviene evitar y mucho más.
¿Está construyendo IA para mercados no anglófonos?
El diseño del tokenizador limita fundamentalmente las capacidades multilingües de la mayoría de los LLM. Identifiquemos el modelo y la estrategia de formación adecuados para sus necesidades lingüísticas.