
Low-Rank Adaptation (LoRA) para LLM eficientes
En el mundo de la inteligencia artificial en rápida evolución, es crucial adaptar de manera eficiente grandes modelos de lenguaje a nuevas tareas o conjuntos de datos. Esta publicación de blog tiene como objetivo desmitificar la Adaptación de bajo rango (LoRA), una técnica de vanguardia diseñada para afinar modelos de lenguaje grandes como Llama-2, Llama-3 y Mistral. Al final de este artículo, comprenderá qué es LoRA, cómo funciona y por qué se está convirtiendo en una herramienta esencial para los profesionales de la IA.
Por qué es importante LoRA
El ajuste tradicional de modelos grandes puede llevar mucho tiempo y ser costoso, y a menudo requiere recursos computacionales sustanciales. LoRA introduce un enfoque novedoso que mitiga estos problemas al reducir la cantidad de parámetros entrenables mediante la descomposición de matrices de bajo rango. Este método no sólo acelera el proceso de entrenamiento sino que también conserva la memoria, lo que hace más factible implementar estos modelos en diversas aplicaciones prácticas.
LoRA es particularmente beneficioso en escenarios donde los modelos deben actualizarse o adaptarse con frecuencia a nuevas tareas sin el lujo de una gran potencia computacional. Al simplificar el proceso de adaptación, LoRA permite que más organizaciones aprovechen el poder de grandes modelos lingüísticos, democratizando el acceso a capacidades avanzadas de IA.
En las secciones siguientes, profundizaremos en la mecánica de LoRA, exploraremos sus aplicaciones prácticas y destacaremos algunos estudios de casos del mundo real que demuestran su eficacia. Ya sea que sea un investigador de inteligencia artificial, un científico de datos o un ingeniero de aprendizaje automático, comprender LoRA puede mejorar significativamente su capacidad para trabajar con modelos de lenguaje grandes de manera efectiva.
¿Qué es LoRA?
LoRA es una técnica innovadora diseñada para reducir la cantidad de parámetros entrenables en modelos de lenguaje grandes. Al centrarse en esta reducción, LoRA hace que el proceso de ajuste sea más rápido y eficiente sin comprometer el rendimiento del modelo. Este método aprovecha principios matemáticos para simplificar y acelerar la adaptación de modelos grandes a nuevas tareas o conjuntos de datos.
Conceptos clave:
- Descomposición de bajo rango: En el corazón de LoRA está el concepto de descomposición de bajo rango. Esto implica dividir matrices grandes en partes más pequeñas y manejables. Al hacer esto, podemos centrarnos en las partes más críticas de los datos, lo que hace que el proceso de formación sea más eficiente. Básicamente, la descomposición de bajo rango ayuda a identificar y aislar los parámetros más influyentes que necesitan ajuste durante el ajuste fino.
- Rango de matriz: El rango de una matriz es una medida de su complejidad, determinada por el número de filas o columnas linealmente independientes que contiene. En el contexto de LoRA, nuestro objetivo es utilizar matrices con rangos más bajos para representar cambios en los pesos del modelo. Este enfoque reduce significativamente la carga computacional, ya que las matrices de rango inferior son más simples y requieren menos recursos para procesar.
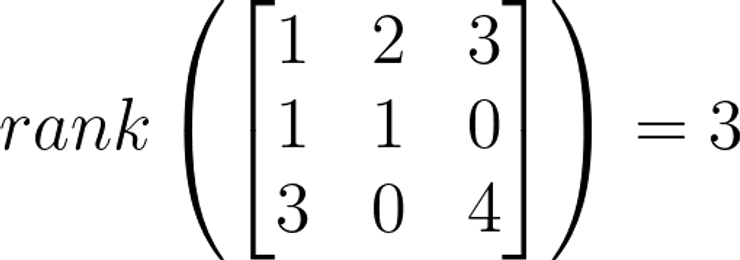
Matriz de rango completo (por ML6)
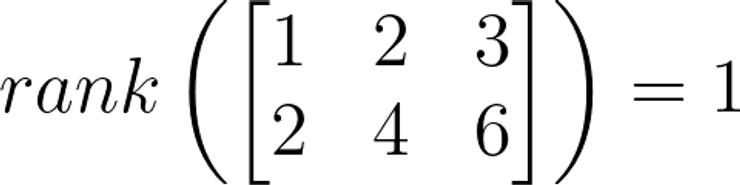
Matriz de rango deficiente (por ML6)
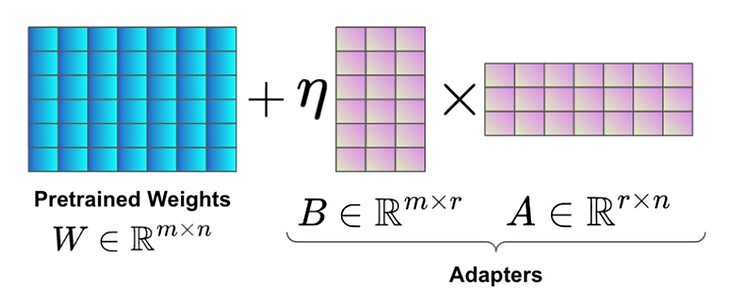
Reparametrización de peso con adaptadores LoRA (mediante Wang et al.)
Beneficios:
- Tiempos de entrenamiento más rápidos: Al reducir la cantidad de parámetros entrenables, LoRA acelera el proceso de entrenamiento. Esto resulta especialmente beneficioso cuando se trabaja con grandes conjuntos de datos o cuando se necesitan actualizaciones rápidas del modelo.
- Uso reducido de memoria: La eficiencia de LoRA también se extiende al uso de la memoria. Los conjuntos de parámetros más pequeños requieren menos memoria, lo que permite entrenar y ajustar modelos grandes en hardware con especificaciones más modestas.
- Almacenamiento y uso compartido de modelos más sencillos: Los modelos optimizados con LoRA tienen archivos más pequeños, lo que los hace más fáciles de almacenar y compartir. Esto es particularmente útil para proyectos colaborativos o cuando se implementan modelos en diferentes plataformas.
Cómo funciona LoRA
Al adaptar modelos grandes con LoRA, actualizamos las matrices de peso utilizando matrices de rango bajo. En lugar de modificar toda la matriz de peso directamente, LoRA introduce dos matrices más pequeñas que, cuando se multiplican, se aproximan a los cambios necesarios en la matriz original. Este método no sólo simplifica los cálculos sino que también preserva las características esenciales del modelo mientras lo adapta a nuevas tareas o conjuntos de datos.
Parámetros clave:
- rank: Define la dimensión interna de las matrices de rango bajo. Un rango más alto significa más parámetros entrenables.
- lora_alpha: Un factor de escala para las matrices de bajo rango. Ajusta la influencia de la adaptación de rango bajo en el modelo general.
- target_modules: Especifica qué partes del modelo utilizarán LoRA. Esto permite realizar ajustes específicos y ayuda a reducir cálculos innecesarios.
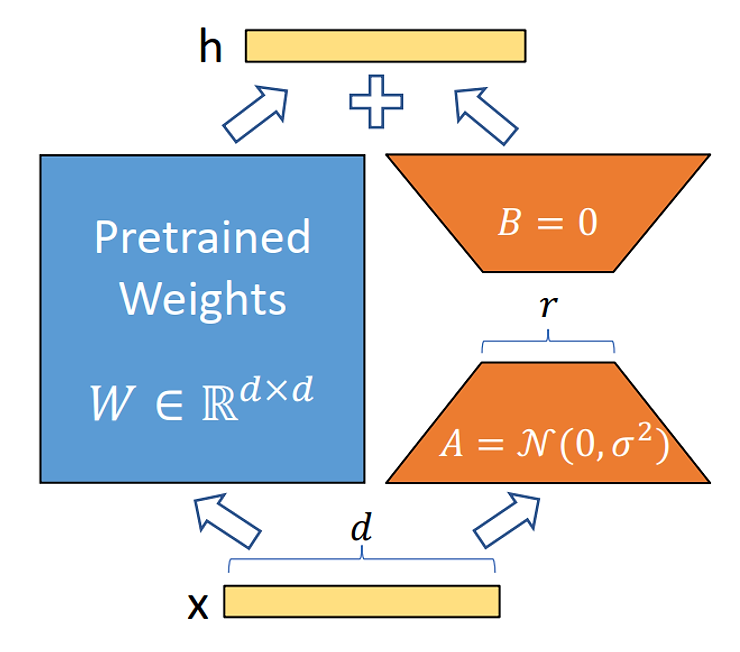
Reparametrización de LoRA. Solo entrenamos las matrices A y B cuando afinamos los LLM (mediante Hu et al.)
Desafíos y consideraciones
Si bien LoRA ofrece numerosos beneficios para ajustar modelos de lenguaje grandes, también presenta su propio conjunto de desafíos. Comprender estos desafíos y cómo abordarlos es crucial para implementar LoRA de manera efectiva.
Sobreajuste y desajuste:
Uno de los principales desafíos al utilizar LoRA es encontrar el equilibrio adecuado en la complejidad de las matrices de bajo rango. Si las matrices son demasiado simples, el modelo podría no ajustarse lo suficiente y no capturar la información y los matices esenciales de los datos. Por el contrario, si las matrices son demasiado complejas, el modelo podría sobreajustarse, capturando el ruido junto con los datos relevantes. Lograr el equilibrio adecuado garantiza que el modelo se generalice bien a datos nuevos e invisibles.
Heterogeneidad de datos:
Otro desafío importante es lidiar con la heterogeneidad de los datos. Este problema surge cuando hay una diferencia sustancial entre el dominio de origen (donde se entrenó inicialmente el modelo) y el dominio de destino (donde se está adaptando el modelo). Estas diferencias pueden obstaculizar la capacidad del modelo para transferir conocimientos de forma eficaz.
Disponibilidad de datos:
Por último, la disponibilidad de datos es una consideración crítica. En muchos casos, obtener datos etiquetados en el dominio de destino puede resultar complicado y costoso. Esta limitación puede impedir el proceso de ajuste, ya que LoRA, al igual que otras técnicas de aprendizaje automático, generalmente requiere una cantidad sustancial de datos para construir modelos robustos. Explorar enfoques semisupervisados, en los que el modelo se entrena con una combinación de datos etiquetados y no etiquetados, puede ayudar a mitigar este problema.
Direcciones e investigaciones futuras
A medida que LoRA continúa ganando terreno en la comunidad de IA, existen varias vías interesantes para futuras investigaciones y desarrollo.
Avances en las técnicas LoRA:
Una de las principales áreas de investigación futura implica la exploración de nuevos métodos para reducir aún más la cantidad de parámetros entrenables. Si bien LoRA ya reduce significativamente la carga computacional, existe investigación en curso para ampliar aún más estos límites. Las innovaciones en técnicas de factorización matricial y algoritmos de optimización podrían conducir a modelos aún más compactos sin sacrificar el rendimiento.
Integración con otras tecnologías:
Otra dirección prometedora para futuras investigaciones es la integración de LoRA con otras tecnologías avanzadas de IA. Por ejemplo, combinar LoRA con técnicas como DreamBooth puede mejorar la personalización del modelo, permitiendo procesos de ajuste más personalizados y eficientes.
El futuro de LoRA es brillante, con investigaciones en curso preparadas para ampliar sus capacidades y aplicaciones. A medida que se desarrollen estos avances, LoRA seguirá desempeñando un papel fundamental en la evolución de la IA, permitiendo una adaptación de modelos más eficiente y versátil en diversos dominios.
Artículos relacionados
- Guía para profesionales de LLM: Gemma, un LLM multilingüe innovador
- ¿Qué tan multilingüe es realmente Llama-2?
- El tango requiere dos: crear sinergia entre la IA y la gestión de productos
¿Quiere ajustar un LLM para su caso de uso?
Determinemos el enfoque de ajuste correcto, desde la configuración de LoRA hasta la estrategia de datos, para sus requisitos específicos.