
Guía para profesionales de LLM: Gemma
Guía para profesionales de LLM:
- ¿Qué tan multilingüe es realmente Llama-2?
- ¿Qué tan multilingües son Falcon, Mistral, Smaug y otros LLM?
- Gemma, un LLM multilingüe innovador
El 21 de febrero de 2024, Google presentó su nuevo modelo de lenguaje grande (LLM) de acceso abierto, Gemma. Este lanzamiento supone un hito significativo, mucho más importante de lo que podría parecer inicialmente.
Desde que ChatGPT irrumpió en escena, el ámbito de los LLM de acceso abierto ha experimentado un crecimiento explosivo. Desde el principio, hemos estado profundamente involucrados en la capacitación y personalización de los LLM de chat de acceso abierto. A pesar del entusiasmo que nos rodea, quienes trabajamos con modelos multilingües somos muy conscientes de un problema crítico. Para las lenguas fuera de las familias romance y germánica, los tokenizadores ineficientes han limitado gravemente el rendimiento de los LLM de acceso abierto.
¿Qué es un tokenizador? Es un algoritmo que divide el texto en unidades más pequeñas, llamadas tokens. Estos tokens pueden ser palabras, subpalabras, caracteres individuales u otras unidades, según el diseño del tokenizador. La tokenización es un paso clave en el procesamiento de texto para LLM, ya que habilita aplicaciones como clasificación de texto, respuesta a preguntas y traducción automática.
Los tokenizadores son vitales para el proceso de procesamiento del lenguaje natural (NLP), y cumplen un objetivo singular: convertir texto a un formato que el modelo pueda comprender. Dado que los modelos operan con datos numéricos, los tokenizadores transforman nuestras entradas textuales en números que el modelo puede procesar.
Un método sencillo consiste en asignar un número único a cada letra o símbolo. Por ejemplo, a "a" se le podría asignar el número 1, a "b" el número 2, y así sucesivamente. Luego, el modelo intenta predecir el siguiente número en una secuencia. Sin embargo, este método puede convertir incluso una frase corta en una larga secuencia de números. Un solo error al predecir una letra puede alterar todas las predicciones posteriores, lo que hace que este método sea complicado y propenso a errores.
Una estrategia alternativa asigna a cada palabra un número único. Esto condensa significativamente la secuencia, pero no está exenta de desafíos. Con más de 200.000 palabras sólo en inglés, un modelo que funcione en varios idiomas puede necesitar diferenciar entre millones de números, lo que aumenta significativamente la posibilidad de errores.
Para abordar estos desafíos, los investigadores idearon la tokenización. Divide las palabras en piezas más pequeñas (tokens) que se encuentran comúnmente. Por ejemplo, "predecir" podría dividirse en "pred", "ict" y "ing". Esto reduce drásticamente las opciones que el modelo debe considerar: desde un diccionario completo hasta alrededor de 2000 tokens para inglés.
Sin embargo, hay un problema importante: todos los LLM de chat de acceso abierto conocidos, como Llama, Llama-2, Mistral, Mixtral, Falcon, Smaug y otros, tienen tokenizadores diseñados principalmente para lenguas romances y germánicas. Para los idiomas no germánicos, no romances y no eslavos, como el griego, el chino, el hebreo, el árabe, el hindi, el coreano, el japonés, etc., estos idiomas se reducen a caracteres.
Aunque puede mejorar el rendimiento de un modelo entrenándolo con más datos o con datos de mayor calidad, el tokenizador presenta un reto distinto. Funciona con un algoritmo determinista, no con aprendizaje automático. No puede entrenarlo ni ajustarlo. Además, el modelo está estrechamente acoplado a su tokenizador: sustituirlo lo dejaría inoperativo.
Ha habido modelos con tokenizadores multilingües eficaces, como el mt5 de Google, lanzado en 2020. Sin embargo, se trataba de modelos "básicos" y no entrenados específicamente para tareas conversacionales.
Esta situación limitó efectivamente las aplicaciones prácticas de los LLM principalmente a lenguas romances y germánicas. Para lograr un LLM conversacional de alta calidad, tenía dos opciones:
- Ajuste los LLM modernos, como Llama-2 o Mistral, de una manera que recuerde a 2015, utilizando representación de texto basada en caracteres.
- Comience con un modelo base equipado con un tokenizador robusto y entrénelo para que sea conversacional.
Ambas opciones exigen conjuntos de datos extensos y altamente precisos. Para la mayoría de los idiomas y empresas, esto hizo que el ajuste de los LLM conversacionales multilingües modernos estuviera prácticamente fuera de su alcance.
Hasta ahora.
Gemma
Gemma representa una nueva generación de modelos abiertos, livianos y de vanguardia que se basan en la investigación y la tecnología detrás de los modelos Gemini. Desarrollada por Google DeepMind y varios equipos de Google, Gemma se inspira en Géminis, y su nombre proviene de la palabra latina "gemma", que significa "piedra preciosa".
Esto es lo que necesita saber:
- Google ha presentado las pesas modelo Gemma en dos versiones: Gemma 2B y Gemma 7B. Cada versión viene en variantes previamente entrenadas y ajustadas a las instrucciones.
- El kit de herramientas de IA generativa responsable recientemente presentado ofrece orientación y herramientas vitales para desarrollar aplicaciones de IA más seguras utilizando Gemma.
- Google admite cadenas de herramientas para inferencia y ajuste fino supervisado (SFT) en todos los marcos principales, incluidos JAX, PyTorch y TensorFlow, compatibles de forma nativa con Keras 3.0.
- Google ha puesto a disposición portátiles Colab y Kaggle listos para usar, así como integración con herramientas ampliamente utilizadas como Hugging Face, MaxText, NVIDIA NeMo y TensorRT-LLM.
- Los modelos Gemma previamente entrenados y ajustados por instrucciones se ejecutan sin problemas en varias plataformas, desde su computadora portátil personal hasta Google Cloud, con opciones de implementación en Vertex AI y Google Kubernetes Engine (GKE).
- Los términos de uso permiten el uso comercial responsable y la distribución por parte de organizaciones de cualquier tamaño.
Anteriormente destacamos mt5, el LLM 2020 de Google, conocido por su excepcional tokenizador multilingüe. Ahora conoce a Gemma: equipada con un tokenizador aún más avanzado. En nuestro último análisis, realizamos pruebas exhaustivas de los tokenizadores de los principales LLM en una variedad de idiomas, y así es como se destaca el tokenizador de Gemma:
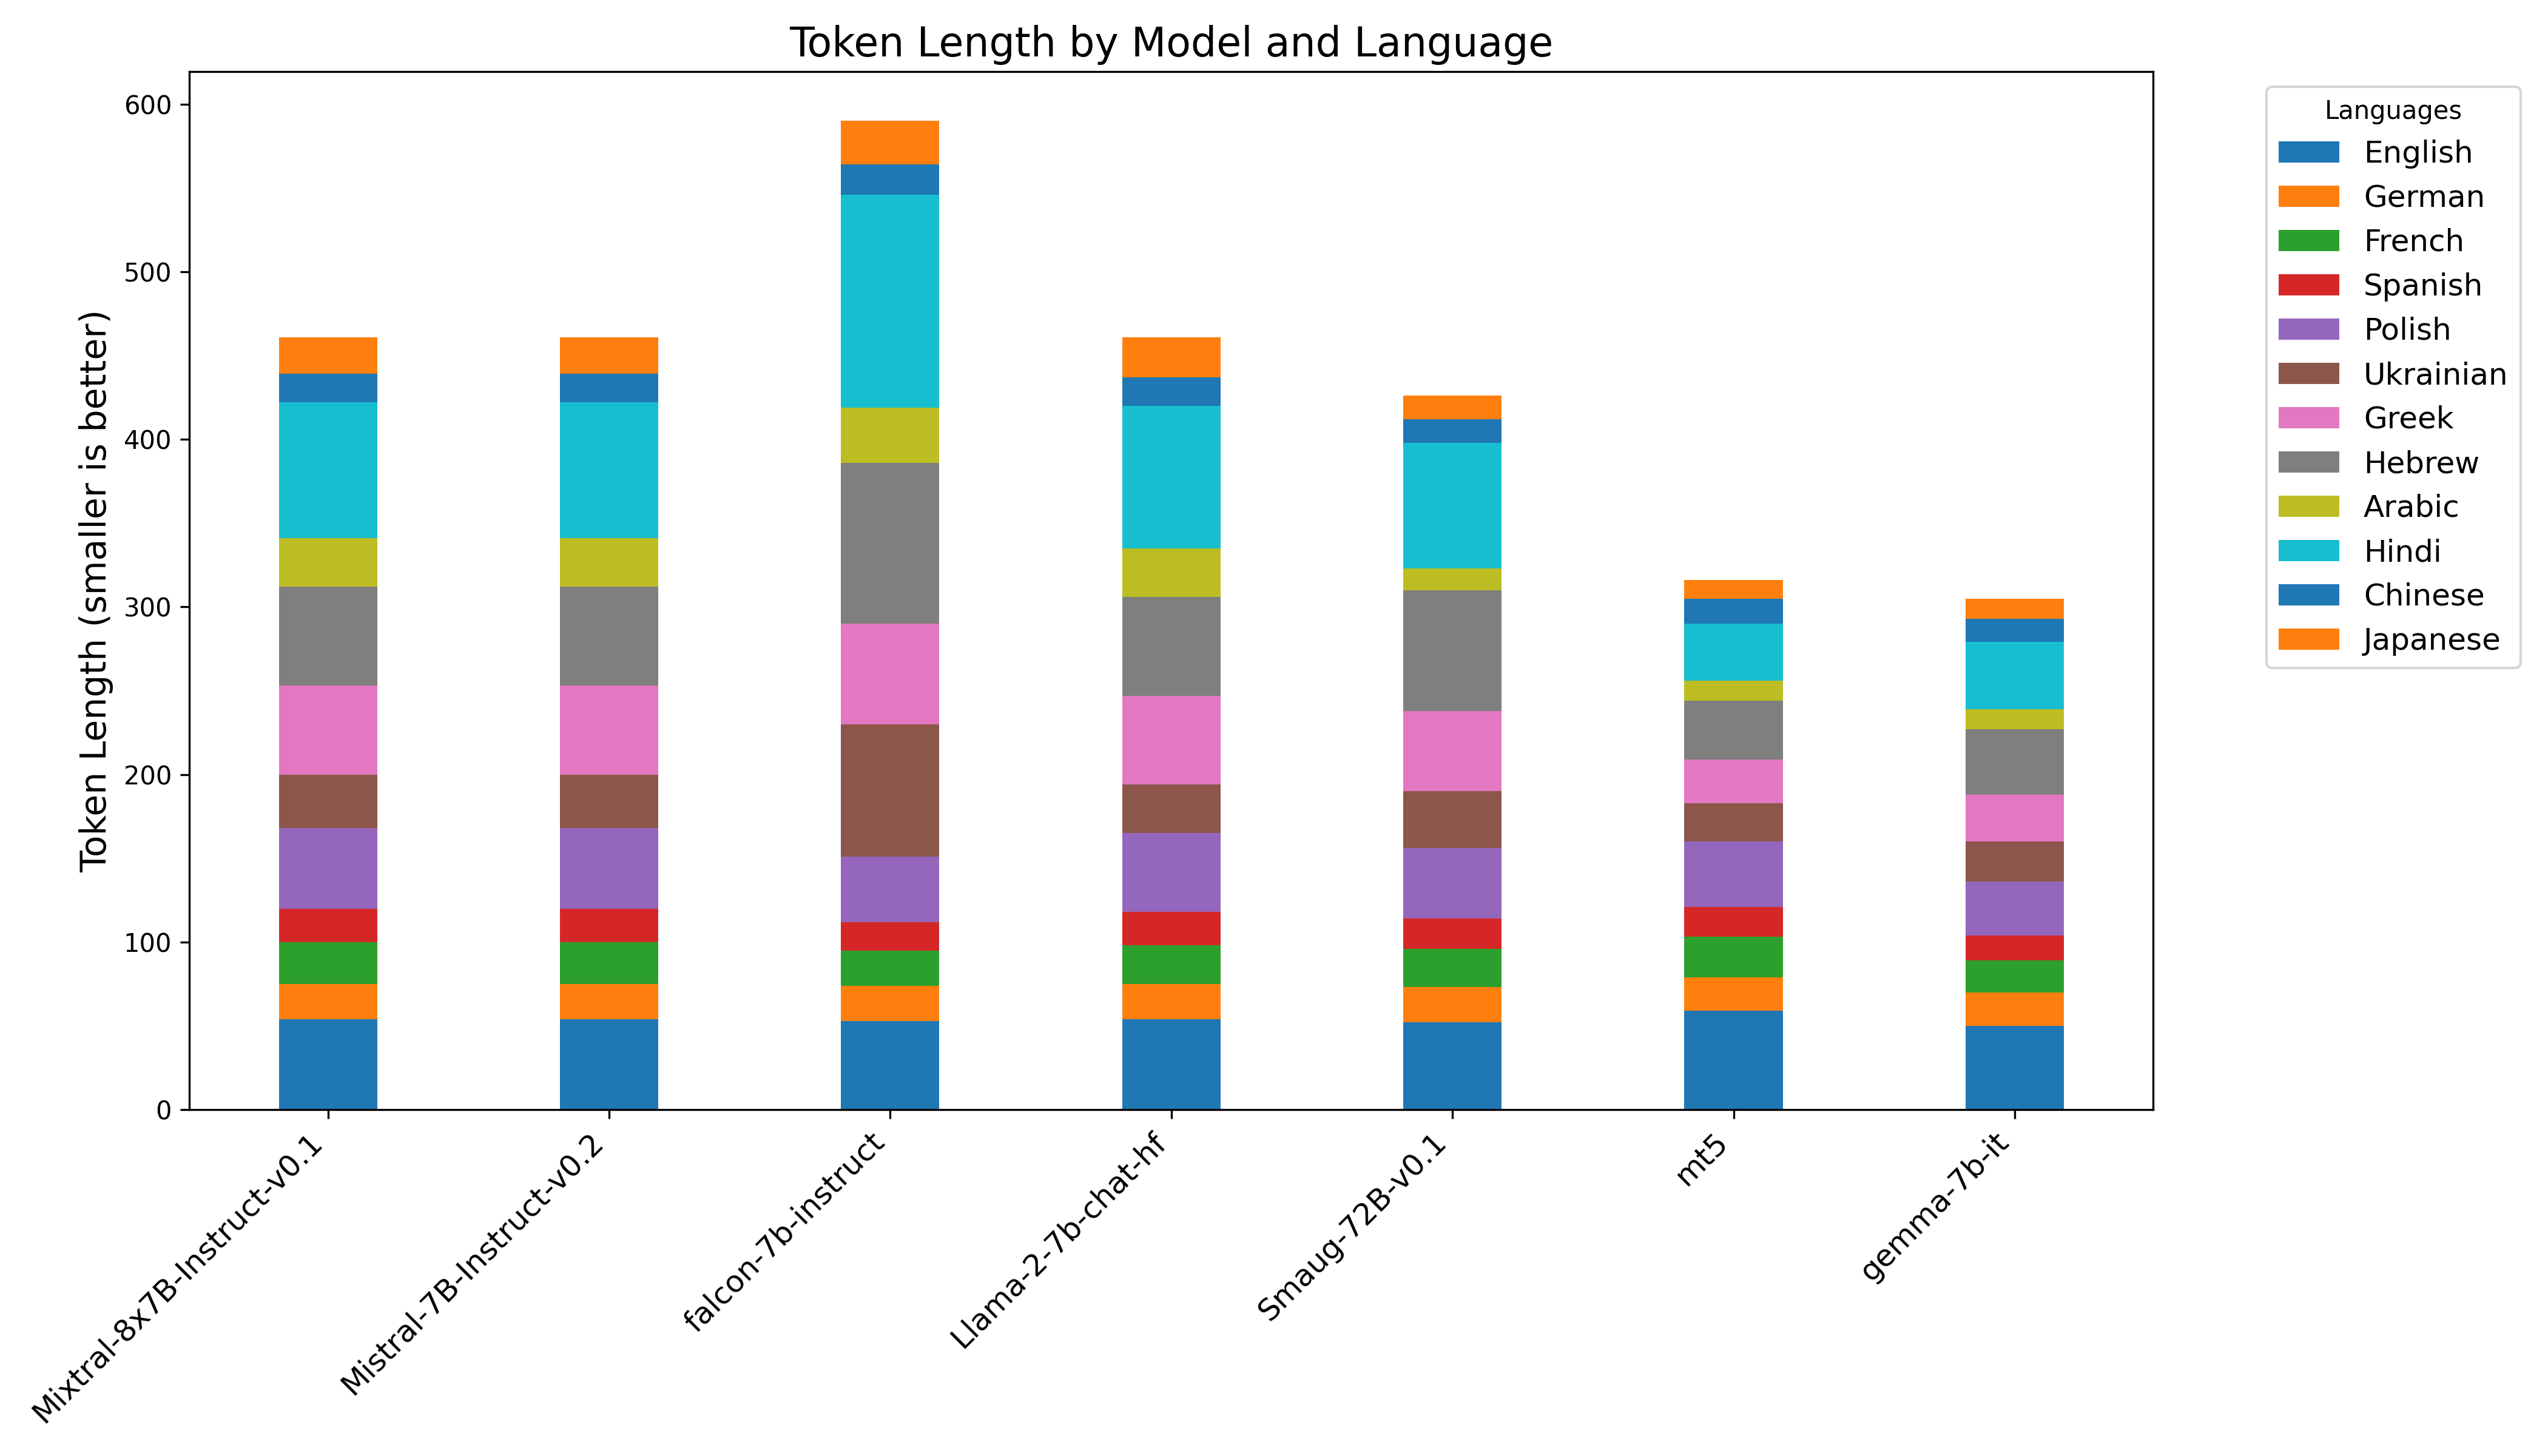
Y aquí hay una comparación directa del rendimiento de la tokenización entre Gemma y Llama-2:
| Idioma | Llama-2 Tokens | Gemma Tokens | Mejora |
|---|---|---|---|
| English | 54 | 50 | 7% |
| German | 21 | 20 | 5% |
| French | 23 | 19 | 17% |
| Spanish | 20 | 15 | 25% |
| Polish | 47 | 32 | 32% |
| Ukrainian | 29 | 24 | 17% |
| Greek | 53 | 28 | 47% |
| Hebrew | 59 | 39 | 34% |
| Arabic | 29 | 12 | 59% |
| Hindi | 85 | 40 | 53% |
| Chinese | 17 | 14 | 18% |
| Japanese | 24 | 12 | 50% |
A primera vista, Gemma podría parecer un LLM más, similar a muchos otros publicados por la comunidad de código abierto cada mes. Sin embargo, es importante no dejarse engañar; Esta es una gran noticia para el campo LLM. Con la introducción de Gemma, las empresas de todo el mundo ahora tienen la capacidad de ajustar los LLM de acceso abierto para una variedad de aplicaciones. Esto incluye la creación de traductores conversacionales, asistentes de escritura multilingües y sistemas de recuperación de generación aumentada (RAG). Este lanzamiento cierra efectivamente una brecha significativa, aunque anteriormente pasada por alto, en el panorama de los LLM. Marca la llegada del primer LLM de chat verdaderamente multilingüe.
Crear su LLM personalizado podría mejorar la seguridad y el cumplimiento de los datos y permitir una ventaja competitiva de IA para su producto. Consulte nuestras otras publicaciones para obtener explicaciones detalladas:
- ¿Qué es el efecto de red?
- Cómo la IA permite el efecto de red
- Cómo construir una ventaja competitiva de la IA
- ¿Qué cultura ayuda a crear los productos de IA adecuados?
- Qué evitar en su estrategia de IA
¿Crear un producto de IA multilingüe?
Elegir el modelo y el tokenizador correctos es fundamental. Busquemos la mejor base para su solución de IA multilingüe.