
Llama 3.3 plus rapide avec Hugging Face TGI
L’écosystème des grands modèles linguistiques (LLM) en libre accès continue de croître rapidement. En juillet 2024, Meta a dévoilé Llama 3.1, un modèle impressionnant de 405 milliards de paramètres qui a repoussé les limites des performances LLM. À peine cinq mois plus tard, en décembre 2024, Meta publiait Llama 3.3, une version compacte avec seulement 70 milliards de paramètres.
Bien qu'il soit près de six fois plus compact, Llama 3.3 égale les performances de son prédécesseur plus massif. Il surpasse GPT-4o sur plusieurs tâches, tout en étant jusqu’à 50 fois moins cher et 10 fois plus rapide que le modèle d’OpenAI.
Ce qui rend Llama 3.3 particulièrement intéressant, c'est sa capacité de fine-tuning. Vous pouvez l'entraîner sur vos propres données pour l'adapter à vos besoins spécifiques.
Ce blog se concentre sur la création d’un avantage concurrentiel grâce à l’IA. Si vous voulez vous assurer que vos concurrents ne peuvent pas facilement reproduire votre produit, vous devez former vos propres modèles d'IA. Llama 3.3 est une excellente option pour les applications impliquant du texte ou des conversations.
Mais une fois votre modèle affiné, le prochain défi se pose : comment le déployer ? Comment pouvez-vous garantir que votre LLM offre des performances élevées, s'intègre aux outils standard et fonctionne en toute sécurité au sein de votre organisation ?
Hugging Face Text Generation Inference
L'écosystème Hugging Face offre bien plus que de simples dépôts de modèles et de jeux de données. Avec Text Generation Inference (TGI), vous pouvez déployer votre LLM affiné pour une inférence rapide, efficace et sécurisée.
TGI est optimisé pour une utilisation en entreprise, vous permettant de :
- Déployez des modèles avec un simple lanceur.
- Obtenez des performances de niveau production grâce à des fonctionnalités telles que le traçage distribué (OpenTelemetry) et les métriques Prometheus.
- Utilisez le parallélisme tensoriel pour une inférence plus rapide sur plusieurs GPU.
- Diffuser les tokens en temps réel avec les Server-Sent Events (SSE).
- Appliquez la quantification avec des outils tels que bitsandbytes et GPT-Q pour optimiser les performances.
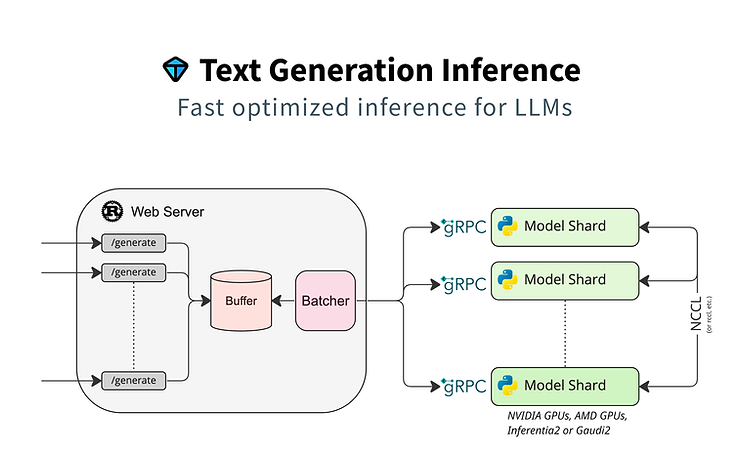
TGI alimente également HuggingChat, un chatbot d'IA gratuit avec lequel vous pouvez essayer des modèles comme Llama 3.3.
TGI est écrit en Rust, ce qui le rend hautement optimisé pour les tâches d'inférence. Il prend en charge des connecteurs prêts à l'emploi pour des outils tels que LangChain, garantissant une intégration transparente avec les bibliothèques standard. Que vous recherchiez la vitesse, l'évolutivité ou la simplicité, TGI est à la hauteur.
Dans cet article, nous allons d'abord mesurer l'inférence de Llama 3.3 avec la bibliothèque standard Transformers, puis le déployer avec TGI et comparer la vitesse de génération.
Déploiement avec Hyperstack
Pour cette démonstration, nous utiliserons Hyperstack, un fournisseur de cloud GPU proposant des GPU NVIDIA H100 à un tarif compétitif de 1,90 $ de l'heure.
Étape 1 : Sélectionnez votre GPU
Pour exécuter Llama 3.3 efficacement, nous avons besoin d'au moins deux GPU NVIDIA H100 avec 80 Go de mémoire GPU chacun. Bien qu'il soit techniquement possible d'exécuter Llama 3.3 sur un seul GPU H100, les poids du modèle devraient être répartis entre le GPU et le CPU. Cette configuration augmente considérablement les temps de réponse, dépassant souvent 10 minutes par requête, ce qui n'est pas pratique pour la plupart des applications.
Étape 2 : Choisissez le système d'exploitation
Ensuite, sélectionnez un système d'exploitation qui inclut Docker. Docker est essentiel au bon fonctionnement de TGI.
Étape 3 : Activer l'accès à distance
Lors de la configuration de votre machine virtuelle (VM), activez à la fois l'accès SSH pour une gestion sécurisée par ligne de commande et une adresse IP publique pour autoriser les connexions à distance pendant l'expérience.
Étape 4 : Déployez votre VM
Une fois votre configuration terminée, cliquez sur Déployer. En quelques secondes, votre VM sera prête à être utilisée. Pour activer l'accès à distance au Jupyter Notebook, configurez une règle d'entrée pour le port souhaité. Dans cette démonstration, nous utiliserons le port 10000.
Llama 3.3 Inférence avec des transformateurs
Pour commencer, nous allons tester la vitesse d'inférence de Llama 3.3 en utilisant la bibliothèque standard Transformers. Plus tard, nous déploierons le même modèle avec TGI pour comparer les performances.
Étape 1 : Charger le modèle Llama 3.3
Hyperstack fournit 750 Go de stockage éphémère par GPU, soit 1,5 To au total avec deux GPU H100. Gardez à l'esprit que Llama 3.3 est un modèle gated : vous devrez demander l'accès sur Hugging Face ou directement auprès de Meta.
pip3 install packaging huggingface_hub[cli]
huggingface-cli login --token <YOUR_HUGGINGFACE_TOKEN>
Ensuite, chargez le modèle :
from transformers import AutoTokenizer, AutoModelForCausalLM
import torch

model_name = 'meta-llama/Llama-3.3-70B-Instruct'

tokenizer = AutoTokenizer.from_pretrained(
    model_name, trust_remote_code=True, cache_dir="/ephemeral/"
)

model = AutoModelForCausalLM.from_pretrained(
    model_name, trust_remote_code=True, torch_dtype=torch.bfloat16,
    device_map="auto", cache_dir="/ephemeral/"
)
Étape 2 : Charger l'ensemble de données
Pour cette démonstration, nous utiliserons l'ensemble de données Alpaca :
from datasets import load_dataset

train_set = load_dataset("yahma/alpaca-cleaned", split="train")
Avec la bibliothèque Transformers, vous devrez formater l'entrée selon la structure d'invite de Llama :
def create_prompt_formats(sample):
    result = f"""<|start_header_id|>system<|end_header_id|>

You are a helpful assistant.<|eot_id|><|start_header_id|>user<|end_header_id|>

{sample['instruction']}<|eot_id|><|start_header_id|>assistant<|end_header_id|>
"""
    sample["prompt"] = result
    return sample

train_set_processed = train_set.map(create_prompt_formats)
terminators = [tokenizer.eos_token_id]Étape 3 : Mesurer la vitesse d’inférence
Pour mesurer la vitesse d'inférence, nous exécuterons le modèle sur les 10 premières entrées du dataset Alpaca :
import time
from statistics import mean

transformers_processing_time = []

for i in range(10):
    start_time = time.time()
    data_point = train_set_processed[i]
    inputs = tokenizer(data_point['prompt'], return_tensors="pt",
                       add_special_tokens=False).to('cuda')
    outputs = model.generate(
        input_ids=inputs['input_ids'],
        attention_mask=inputs['attention_mask'],
        max_new_tokens=30000,
        pad_token_id=18610,
        eos_token_id=terminators
    )
    processing_time = time.time() - start_time
    transformers_processing_time.append(processing_time)

print(mean(transformers_processing_time))
# Output: ~30.37 seconds
Avec cette approche, il faut en moyenne environ 30 secondes par exemple.
Étape 4 : tester avec la pipeline Transformers
Le pipeline Transformers simplifie le traitement par lots. Voyons si cela améliore les performances :
from transformers import pipeline

pipe = pipeline("text-generation", model=model, tokenizer=tokenizer)

generation_args = {
    "max_new_tokens": 30000,
    "return_full_text": True,
    "temperature": 0.0,
    "do_sample": False,
}

transformers_pipeline_processing_time = []

for i in range(10):
    start_time = time.time()
    data_point = train_set_processed[i]
    output = pipe(data_point['prompt'], **generation_args)
    processing_time = time.time() - start_time
    transformers_pipeline_processing_time.append(processing_time)

print(mean(transformers_pipeline_processing_time))
# Output: ~28.31 seconds
La pipeline réduit légèrement le temps de traitement moyen, mais on reste malgré tout autour de 28 à 30 secondes par exemple.
Inférence de Llama 3.3 avec TGI
Passons maintenant à Llama 3.3 avec TGI. Avant de commencer, assurez-vous que vos kernels Python sont arrêtés et que la mémoire GPU a bien été entièrement libérée.
Étape 1 : Exécutez le conteneur Docker TGI
model=meta-llama/Llama-3.3-70B-Instruct
volume=/ephemeral/data

docker run --gpus all --shm-size=1g \
  -e HUGGING_FACE_HUB_TOKEN=<YOUR_HUGGINGFACE_TOKEN> \
  -v $volume:/data \
  -d -p 8080:80 \
  ghcr.io/huggingface/text-generation-inference:3.0.1 \
  --model-id $model --num-shard 2
Lorsque vous exécutez cette commande, Docker récupère le conteneur TGI, télécharge les poids de Llama 3.3 et lance les shards nécessaires. Lorsque le modèle est prêt, vous verrez le message suivant dans les logs :
INFO text_generation_router::server: router/src/server.rs:2402: ConnectedÉtape 2 : se connecter à TGI
from langchain.prompts import SystemMessagePromptTemplate, \
    HumanMessagePromptTemplate, ChatPromptTemplate
from langchain_huggingface import HuggingFaceEndpoint
from langchain_experimental.chat_models.llm_wrapper import ChatWrapper
import time
from statistics import mean
Étape 3 : configurer les prompts
class Llama3Chat(ChatWrapper):
    @property
    def _llm_type(self) -> str:
        return "meta-llama/Llama-3.3-70B-Instruct"
    sys_beg: str = "<|begin_of_text|><|start_header_id|>system<|end_header_id|>\n\n"
    sys_end: str = "<|eot_id|>"
    ai_n_beg: str = ""
    ai_n_end: str = "<|eot_id|>"
    usr_n_beg: str = "<|start_header_id|>user<|end_header_id|>\n\n"
    usr_n_end: str = "<|eot_id|><|start_header_id|>assistant<|end_header_id|>\n\n"
    usr_0_beg: str = "<|start_header_id|>user<|end_header_id|>\n\n"
    usr_0_end: str = "<|eot_id|><|start_header_id|>assistant<|end_header_id|>\n\n"
def get_response():
system_template = "You are a helpful assistant."
user_template = "{message}"
messages = [
SystemMessagePromptTemplate.from_template(system_template),
HumanMessagePromptTemplate.from_template(user_template)
]
return ChatPromptTemplate(messages=messages)Étape 4 : Connectez LangChain à TGI
llm = Llama3Chat(
    llm=HuggingFaceEndpoint(
        endpoint_url="http://127.0.0.1:8080",
        task="text-generation",
        max_new_tokens=10000,
        huggingfacehub_api_token="<YOUR_HUGGINGFACE_TOKEN>"
    )
)
Étape 5 : tester la vitesse d'inférence
tgi_processing_time = []

for i in range(10):
    start_time = time.time()
    data_point = train_set[i]
    response = llm.invoke({'message': data_point['instruction']}).strip()
    processing_time = time.time() - start_time
    tgi_processing_time.append(processing_time)

print(mean(tgi_processing_time))
# Output: ~14.21 seconds
En moyenne, TGI traite chaque entrée en 14,2 secondes, soit plus de deux fois plus vite que les 28 à 30 secondes observées avec la bibliothèque Transformers.
TGI offre une amélioration significative des performances, réduisant les temps d'inférence de plus de moitié. Au-delà de Llama 3.3, TGI prend en charge des modèles comme Mistral, Mixtral, Gemma, Qwen, Falcon, et plus, le tout avec la même efficacité impressionnante. Avec TGI, vous pouvez déployer des modèles puissants sur votre propre infrastructure, garantissant qu'aucune donnée ne quitte votre périmètre de sécurité.
Disposer de votre propre LLM personnalisé peut renforcer la sécurité et la conformité de vos données, tout en créant un avantage concurrentiel pour votre produit. Consultez aussi nos autres articles :
- Qu'est-ce que l'effet de réseau et comment l'IA le permet
- Comment construire un avantage concurrentiel grâce à l'IA
- Quelle culture vous aide à créer les bons produits d'IA
- Ce qu'il faut éviter dans votre stratégie et exécution d'IA
Prêt à déployer des LLM sur votre propre infrastructure ?
De la sélection du modèle à l'optimisation de l'inférence, construisons un pipeline de déploiement d'IA sécurisé et performant pour votre produit.