
Fine-tuning de Llama 3.1 avec SWIFT : multi-GPU
Unsloth s’est imposé comme une bibliothèque de référence pour le fine-tuning des grands modèles de langage (LLM). Elle réduit fortement à la fois la consommation de mémoire GPU et le temps d’entraînement. Nous l’avons détaillée dans notre précédent article « Comment fine-tuner Llama 3.1 avec Unsloth ».
Cependant, Unsloth a ses limites. La principale est qu’il ne prend actuellement en charge que l’entraînement sur un seul GPU.
Que faire, donc, si l’entraînement sur un seul GPU ne suffit plus à votre projet, soit parce qu’il est trop lent, soit parce qu’il dépasse la capacité même des GPU les plus puissants ? Dans cet article, nous présentons SWIFT, une alternative robuste à Unsloth qui permet de fine-tuner Llama 3.1 efficacement sur plusieurs GPU.
Qu’est-ce que SWIFT ?
SWIFT est une bibliothèque avancée développée par ModelScope pour l’entraînement de grands modèles de langage. Elle couvre tout le cycle de vie : pré-entraînement, fine-tuning, reinforcement learning from human feedback (RLHF), inférence, évaluation et déploiement. Avec SWIFT, vous pouvez travailler avec plus de 300 LLM et plus de 50 modèles multimodaux.
SWIFT va bien au-delà des capacités d’entraînement de base en prenant en charge des approches légères comme le Parameter-Efficient Fine-Tuning (PEFT). Il embarque aussi une bibliothèque complète d’adapters avec des techniques récentes comme NEFTune, LoRA+ et LLaMA-PRO.
Pour rendre la plateforme accessible même aux équipes qui débutent en deep learning, SWIFT propose une interface web conviviale basée sur Gradio. Dans cet article, nous allons voir comment fine-tuner Llama 3.1 avec SWIFT sur une infrastructure RunPod.
Configurer l'environnement RunPod
Connectez-vous à la console RunPod, accédez à « Pods » et cliquez sur « Déployer ». Pour cette démonstration, nous utiliserons le Community Cloud. Cependant, si vous avez des exigences de sécurité strictes, envisagez l’option Secure Cloud de RunPod.
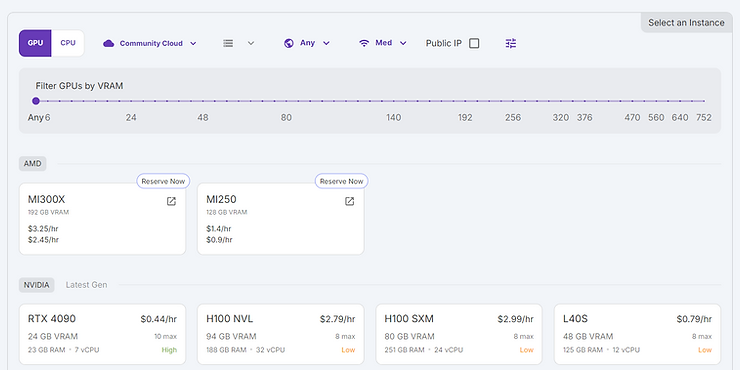
Pour notre exemple, nous utiliserons une instance multi-GPU. Nous sélectionnerons 2 GPU RTX A6000, car chaque A6000 offre 48 Go de mémoire GPU, suffisante pour la plupart des LLM plus petits.
Nous utiliserons l'image RunPod PyTorch 2.4.0, qui est la dernière version au moment de la rédaction. Pour optimiser les coûts, nous utiliserons des instances Spot.
Lorsque vous travaillez avec des GPU, vous avez besoin d’espace de stockage supplémentaire. RunPod propose deux types de stockage :
- Container Disk: Stockage temporaire qui est effacé à chaque fois que vous arrêtez le conteneur.
- Volume Disk: Stockage persistant qui conserve les données même si le conteneur est redémarré ou si une instance Spot est terminée. Monté sur /workspace par défaut.
Installation de SWIFT
Bien que la documentation officielle de SWIFT suggère une installation simple à l'aide du package PyPI, si vous l'exécutez à partir de septembre 2024, vous rencontrerez l'erreur suivante :
Failed to import swift.trainers.trainers because of the following error:
Failed to import modelscope.msdatasets because of the following error:
cannot import name 'ftp_head' from 'datasets.utils.file_utils'
Pour résoudre ce problème, installez SWIFT en exécutant :
pip install --upgrade --force-reinstall --no-cache-dir \
  git+https://github.com/modelscope/ms-swift.git@88dab2b6625280e813bd8835662e1d2be24a3132
Entraînement de Llama 3.1 avec SWIFT
Créez un nouveau Jupyter Notebook et testez votre installation :
from swift import Trainer, TrainingArgumentsEffectuez ensuite les importations nécessaires :
from swift import Trainer, TrainingArguments
from modelscope import MsDataset, AutoTokenizer
from modelscope import AutoModelForCausalLM
from modelscope import snapshot_download
from swift import Swift, LoraConfig, get_peft_model
from swift.llm import get_template, TemplateType, register_template, Template, TEMPLATE_MAPPING
import torch
import wandb
from datasets import load_dataset
from transformers import BitsAndBytesConfig
from trl import SFTTrainer, DataCollatorForCompletionOnlyLM
Contrairement à d’autres frameworks, SWIFT est pensé pour fonctionner avec des modèles hébergés sur ModelScope, et non sur Hugging Face :
model_name = 'LLM-Research/Meta-Llama-3.1-8B-Instruct'
model = AutoModelForCausalLM.from_pretrained(
    model_name, torch_dtype=torch.bfloat16,
    device_map='auto', trust_remote_code=True
)
tokenizer = AutoTokenizer.from_pretrained(model_name, trust_remote_code=True)
tokenizer.pad_token_id = 12488
train_set = load_dataset("yahma/alpaca-cleaned", split="train")Uniformiser la longueur des exemples d'entraînement
SWIFT propose de nombreux templates de prompts pour les LLM. En revanche, le prétraitement du dataset basé sur ces templates n’applique pas automatiquement de troncature ni de padding. Si vous souhaitez traiter plusieurs exemples d’entraînement par GPU, ils doivent tous avoir la même longueur.
def create_prompt_formats(sample, test=False):
    result = f"""<|start_header_id|>system<|end_header_id|>

You are a helpful assistant.<|eot_id|><|start_header_id|>user<|end_header_id|>

{sample['instruction']}<|eot_id|><|start_header_id|>assistant<|end_header_id|>

"""
    if not test:
        result += f"""{sample['output']}<|eot_id|>"""
    sample["prompt"] = result
    return sample
def preprocess_batch(batch, tokenizer, max_length, truncation, padding):
return tokenizer(
batch['prompt'],
max_length=max_length,
truncation=truncation,
padding='max_length' if padding else False
)def preprocess_dataset(tokenizer, max_length, seed, dataset, truncation, padding, test):
print("Preprocessing dataset...")
_create_prompt_formats = partial(create_prompt_formats, test=test)
dataset = dataset.map(_create_prompt_formats)
_preprocessing_function = partial(
preprocess_batch, max_length=max_length,
tokenizer=tokenizer, truncation=truncation, padding=padding
)
dataset = dataset.map(_preprocessing_function, batched=True)
dataset = dataset.shuffle(seed=seed)
return datasetPour trouver la longueur maximale appropriée, nous traitons l'ensemble de données sans troncature ni remplissage :
exploration_set = preprocess_dataset(
    tokenizer=tokenizer, max_length=128000, seed=seed,
    dataset=train_set, truncation=False, padding=False, test=False
)

lengths = [len(entry['input_ids']) for entry in exploration_set]
plt.hist(lengths, bins=30, color='blue', edgecolor='black')
plt.title('Histogram of Lengths of input_ids')
plt.xlabel('Length of input_ids')
plt.ylabel('Frequency')
plt.show()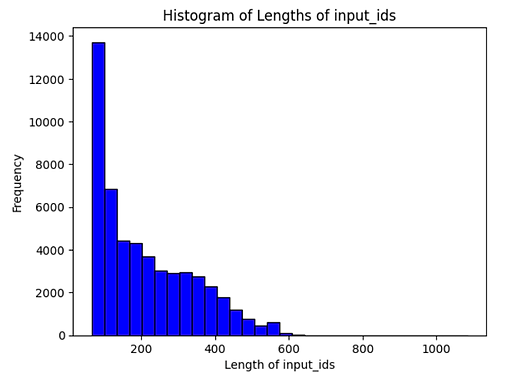
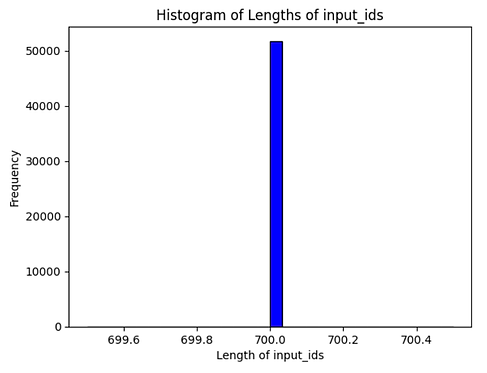
Comme le montre l'histogramme, la plupart des exemples du dataset Alpaca, une fois convertis au format de prompt de Llama 3.1, contiennent moins de 700 tokens. Nous fixons donc la longueur maximale à 700 tokens :
train_set_processed = preprocess_dataset(
    tokenizer=tokenizer, max_length=max_length, seed=seed,
    dataset=train_set, truncation=True, padding=True, test=False
)
Configuration des paramètres LoRA
lora_config = LoraConfig(
    r=4,
    target_modules=["q_proj", "k_proj", "v_proj", "o_proj",
                     "gate_proj", "up_proj", "down_proj"],
    lora_alpha=8,
    lora_dropout=0.05
)

model = Swift.prepare_model(model, lora_config)
Configuration du collecteur de données
response_template = "<|start_header_id|>assistant<|end_header_id|>"
collator = DataCollatorForCompletionOnlyLM(response_template, tokenizer=tokenizer)
Définir la configuration de la formation
train_args = TrainingArguments(
    output_dir='output',
    learning_rate=1e-4,
    num_train_epochs=2,
    eval_steps=500,
    save_steps=500,
    optim="adamw_8bit",
    fp16=True,
    evaluation_strategy='steps',
    save_strategy='steps',
    log_level="debug",
    dataloader_num_workers=16,
    per_device_train_batch_size=1,
    gradient_accumulation_steps=16,
    logging_steps=1,
)
Initialisez le formateur et démarrez la formation
trainer = Trainer(
    model=model,
    args=train_args,
    train_dataset=train_set_processed,
    tokenizer=tokenizer,
    data_collator=collator
)

trainer.train()
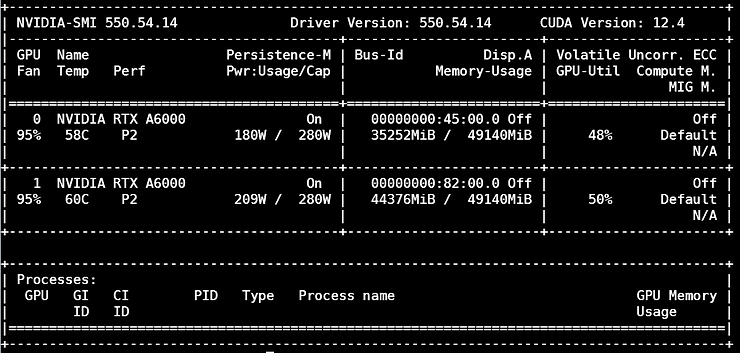
Pendant que la formation est en cours, il est utile de surveiller l'utilisation du GPU avec la commande nvidia-smi :
Vous trouverez le code complet de ce tutoriel dans notre notebook Colab.
Conclusion
Le développement de votre LLM personnalisé pourrait améliorer la sécurité et la conformité des données et permettre à votre produit de bénéficier d'un avantage concurrentiel en matière d'IA. Consultez nos articles connexes :
- Comment affiner Llama 3.1 avec Unsloth
- Adaptation de bas rang (LoRA) pour un réglage fin efficace
- Pourquoi avez-vous besoin d’une stratégie d’IA ?
- Des stratégies d'IA qui offrent un avantage concurrentiel durable
Besoin d'un réglage précis multi-GPU pour votre projet LLM ?
Concevons l'infrastructure de formation appropriée et affinons la stratégie pour votre modèle linguistique personnalisé.