
Llama 3.3 più veloce con Hugging Face TGI
The open-access large language model (LLM) ecosystem continues to grow rapidly. In July 2024, Meta unveiled Llama 3.1, an impressive 405-billion-parameter model that pushed the boundaries of LLM performance. Just five months later, in December 2024, Meta released Llama 3.3, a compact version with only 70 billion parameters.
Despite being almost six times smaller, Llama 3.3 matches the performance of its larger predecessor. It even outperforms GPT-4o on several tasks, while being up to 50 times cheaper and 10 times faster than OpenAI’s model.
What makes Llama 3.3 truly exciting is its fine-tuning capability. You can train it on your own data to make it even more effective for your specific needs.
This blog focuses on creating a competitive edge with AI. If you want to ensure your competitors can’t easily replicate your product, you need to train your own AI models. Llama 3.3 is an excellent option for applications involving text or conversations.
But once your model is fine-tuned, the next challenge arises: how do you deploy it? How can you ensure your LLM delivers high performance, integrates with standard tools, and works securely within your organization?
Hugging Face Text Generation Inference
L’ecosistema Hugging Face offre molto più di semplici repository di modelli e dataset. Con Text Generation Inference (TGI) potete distribuire il vostro LLM sottoposto a fine-tuning per ottenere un’inferenza rapida, efficiente e sicura.
TGI è ottimizzato per l’uso enterprise e vi consente di:
- Distribuire modelli con un launcher semplice da usare.
- Ottenere prestazioni pronte per la produzione grazie a funzioni come distributed tracing con OpenTelemetry e metriche Prometheus.
- Usare il parallelismo tensoriale per accelerare l’inferenza su più GPU.
- Fare streaming dei token in tempo reale tramite Server-Sent Events (SSE).
- Applicare la quantizzazione con strumenti come bitsandbytes e GPT-Q per ottimizzare le prestazioni.
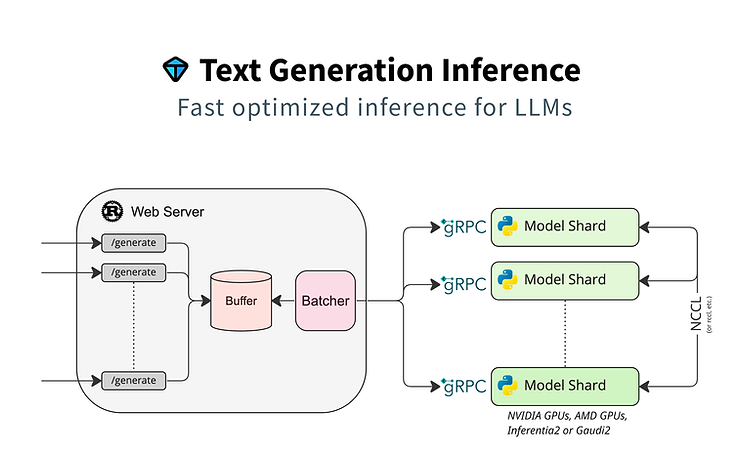
TGI alimenta anche HuggingChat, un chatbot AI gratuito con cui potete provare modelli come Llama 3.3.
TGI è scritto in Rust, quindi è fortemente ottimizzato per i carichi di inferenza. Supporta connettori pronti all’uso per strumenti come LangChain e garantisce un’integrazione fluida con le librerie standard. Se cercate velocità, scalabilità o semplicità operativa, TGI offre tutto questo.
In questo articolo mostreremo prima l’inferenza di Llama 3.3 con la libreria standard Transformers, poi lo distribuiremo con TGI e confronteremo la velocità di generazione.
Deployment con Hyperstack
Per questa dimostrazione useremo Hyperstack, un provider cloud per GPU che offre GPU NVIDIA H100 a una tariffa competitiva di 1,90 dollari l’ora.
Passo 1: scegliere la GPU
Per eseguire Llama 3.3 in modo efficiente servono almeno due GPU NVIDIA H100 da 80 GB ciascuna. Dal punto di vista tecnico sarebbe possibile farlo girare anche su una sola H100, ma in quel caso i pesi del modello dovrebbero essere distribuiti tra GPU e CPU. Una configurazione del genere aumenta drasticamente i tempi di risposta, spesso oltre i 10 minuti per richiesta, e risulta poco pratica per quasi tutte le applicazioni reali.
Passo 2: scegliere il sistema operativo
Scegliete quindi un sistema operativo che includa Docker. Docker è essenziale per far funzionare TGI in modo stabile.
Passo 3: abilitare l’accesso remoto
Durante la configurazione della macchina virtuale abilitate sia l’accesso SSH, per una gestione sicura da riga di comando, sia un indirizzo IP pubblico, così da consentire le connessioni remote durante l’esperimento.
Passo 4: distribuire la VM
Una volta completata la configurazione, fate clic su Deploy. Nel giro di pochi secondi la VM sarà pronta. Per abilitare l’accesso remoto al notebook Jupyter, configurate una regola di ingress per la porta desiderata. In questa dimostrazione useremo la porta 10000.
Inferenza di Llama 3.3 con Transformers
Per iniziare, misureremo la velocità di inferenza di Llama 3.3 con la libreria standard Transformers. Successivamente distribuiremo lo stesso modello con TGI per confrontarne le prestazioni.
Passo 1: caricare il modello Llama 3.3
Hyperstack offre 750 GB di storage effimero per GPU, quindi con due H100 arriviamo a 1,5 TB complessivi. Tenete presente che Llama 3.3 è un modello gated: dovrete richiedere l’accesso su Hugging Face oppure direttamente a Meta.
pip3 install packaging huggingface_hub[cli]
huggingface-cli login --token <YOUR_HUGGINGFACE_TOKEN>
A questo punto caricate il modello:
from transformers import AutoTokenizer, AutoModelForCausalLM
import torch

model_name = 'meta-llama/Llama-3.3-70B-Instruct'

tokenizer = AutoTokenizer.from_pretrained(
    model_name, trust_remote_code=True, cache_dir="/ephemeral/"
)

model = AutoModelForCausalLM.from_pretrained(
    model_name, trust_remote_code=True, torch_dtype=torch.bfloat16,
    device_map="auto", cache_dir="/ephemeral/"
)
Passo 2: caricare il dataset
Per questa dimostrazione useremo il dataset Alpaca:
from datasets import load_dataset

train_set = load_dataset("yahma/alpaca-cleaned", split="train")
Con la libreria Transformers dovete formattare l’input in base alla struttura di prompt prevista da Llama:
def create_prompt_formats(sample):
    result = f"""<|start_header_id|>system<|end_header_id|>

You are a helpful assistant.<|eot_id|><|start_header_id|>user<|end_header_id|>

{sample['instruction']}<|eot_id|><|start_header_id|>assistant<|end_header_id|>
"""
    sample["prompt"] = result
    return sample

train_set_processed = train_set.map(create_prompt_formats)
terminators = [tokenizer.eos_token_id]Passo 3: misurare la velocità di inferenza
Per misurare la velocità di inferenza eseguiremo il modello sui primi 10 input del dataset Alpaca:
import time
from statistics import mean

transformers_processing_time = []

for i in range(10):
    start_time = time.time()
    data_point = train_set_processed[i]
    inputs = tokenizer(data_point['prompt'], return_tensors="pt",
                       add_special_tokens=False).to('cuda')
    outputs = model.generate(
        input_ids=inputs['input_ids'],
        attention_mask=inputs['attention_mask'],
        max_new_tokens=30000,
        pad_token_id=18610,
        eos_token_id=terminators
    )
    processing_time = time.time() - start_time
    transformers_processing_time.append(processing_time)

print(mean(transformers_processing_time))
# Output: ~30.37 seconds
Con questo approccio, in media, servono circa 30 secondi per esempio.
Passo 4: test con la pipeline Transformers
La pipeline di Transformers semplifica l’elaborazione in batch. Vediamo se migliora anche le prestazioni:
from transformers import pipeline

pipe = pipeline("text-generation", model=model, tokenizer=tokenizer)

generation_args = {
    "max_new_tokens": 30000,
    "return_full_text": True,
    "temperature": 0.0,
    "do_sample": False,
}

transformers_pipeline_processing_time = []

for i in range(10):
    start_time = time.time()
    data_point = train_set_processed[i]
    output = pipe(data_point['prompt'], **generation_args)
    processing_time = time.time() - start_time
    transformers_pipeline_processing_time.append(processing_time)

print(mean(transformers_pipeline_processing_time))
# Output: ~28.31 seconds
La pipeline riduce leggermente il tempo medio di elaborazione, ma rimaniamo comunque intorno ai 28-30 secondi per esempio.
Inferenza di Llama 3.3 con TGI
Passiamo ora a testare Llama 3.3 con TGI. Prima di iniziare, assicuratevi che i kernel Python siano arrestati e che la memoria GPU sia stata completamente liberata.
Passo 1: avviare il container Docker di TGI
model=meta-llama/Llama-3.3-70B-Instruct
volume=/ephemeral/data

docker run --gpus all --shm-size=1g \
  -e HUGGING_FACE_HUB_TOKEN=<YOUR_HUGGINGFACE_TOKEN> \
  -v $volume:/data \
  -d -p 8080:80 \
  ghcr.io/huggingface/text-generation-inference:3.0.1 \
  --model-id $model --num-shard 2
Quando eseguite questo comando, Docker scarica il container TGI, recupera i pesi di Llama 3.3 e avvia gli shard necessari. Quando il modello è pronto, vedrete il seguente messaggio nei log:
INFO text_generation_router::server: router/src/server.rs:2402: ConnectedPasso 2: collegarsi a TGI
from langchain.prompts import SystemMessagePromptTemplate, \
    HumanMessagePromptTemplate, ChatPromptTemplate
from langchain_huggingface import HuggingFaceEndpoint
from langchain_experimental.chat_models.llm_wrapper import ChatWrapper
import time
from statistics import mean
Passo 3: configurare i prompt
class Llama3Chat(ChatWrapper):
    @property
    def _llm_type(self) -> str:
        return "meta-llama/Llama-3.3-70B-Instruct"
    sys_beg: str = "<|begin_of_text|><|start_header_id|>system<|end_header_id|>\n\n"
    sys_end: str = "<|eot_id|>"
    ai_n_beg: str = ""
    ai_n_end: str = "<|eot_id|>"
    usr_n_beg: str = "<|start_header_id|>user<|end_header_id|>\n\n"
    usr_n_end: str = "<|eot_id|><|start_header_id|>assistant<|end_header_id|>\n\n"
    usr_0_beg: str = "<|start_header_id|>user<|end_header_id|>\n\n"
    usr_0_end: str = "<|eot_id|><|start_header_id|>assistant<|end_header_id|>\n\n"
def get_response():
system_template = "You are a helpful assistant."
user_template = "{message}"
messages = [
SystemMessagePromptTemplate.from_template(system_template),
HumanMessagePromptTemplate.from_template(user_template)
]
return ChatPromptTemplate(messages=messages)Passo 4: collegare LangChain a TGI
llm = Llama3Chat(
    llm=HuggingFaceEndpoint(
        endpoint_url="http://127.0.0.1:8080",
        task="text-generation",
        max_new_tokens=10000,
        huggingfacehub_api_token="<YOUR_HUGGINGFACE_TOKEN>"
    )
)
Passo 5: testare la velocità di inferenza
tgi_processing_time = []

for i in range(10):
    start_time = time.time()
    data_point = train_set[i]
    response = llm.invoke({'message': data_point['instruction']}).strip()
    processing_time = time.time() - start_time
    tgi_processing_time.append(processing_time)

print(mean(tgi_processing_time))
# Output: ~14.21 seconds
In media, TGI elabora ogni input in 14,2 secondi, cioè oltre il doppio più velocemente rispetto ai 28-30 secondi richiesti dalla libreria Transformers.
TGI offre un miglioramento prestazionale molto significativo, riducendo i tempi di inferenza di oltre la metà. Oltre a Llama 3.3, supporta modelli come Mistral, Mixtral, Gemma, Qwen, Falcon e altri ancora, tutti con la stessa efficienza notevole. Con TGI potete distribuire modelli potenti sulla vostra infrastruttura, mantenendo i dati all’interno del vostro perimetro di sicurezza.
Avere un vostro LLM personalizzato può migliorare sicurezza dei dati e compliance, oltre a creare un vantaggio competitivo basato sull’IA per il vostro prodotto. Leggete anche questi articoli:
- Che cos’è l’effetto rete e come l’IA lo abilita
- Come costruire un vantaggio competitivo nell’IA
- Quale cultura aiuta a costruire i prodotti di IA giusti
- Che cosa evitare nella vostra strategia ed esecuzione AI
Pronti a distribuire LLM sulla vostra infrastruttura?
Dalla scelta del modello all’ottimizzazione dell’inferenza, costruiamo insieme una pipeline di deployment AI sicura e performante per il vostro prodotto.