
Guida per professionisti LLM: Gemma multilingue
Guida per professionisti LLM:
- Quanto è davvero multilingue Llama-2?
- Quanto sono multilingui Falcon, Mistral, Smaug e gli altri LLM?
- Gemma, un LLM multilingue che cambia le regole del gioco
Il 21 febbraio 2024 Google ha presentato Gemma, il suo nuovo Large Language Model open-access. È un lancio molto più importante di quanto possa sembrare a prima vista.
Da quando ChatGPT è arrivato sul mercato, l’ecosistema degli LLM open-access è cresciuto in modo esplosivo. Fin dall’inizio abbiamo lavorato direttamente su training e customizzazione di chat LLM aperti. Dietro l’entusiasmo generale, però, chi costruisce modelli multilingui ha visto subito un limite decisivo: per le lingue al di fuori delle famiglie romanze e germaniche, tokenizer poco efficienti hanno ridotto drasticamente le prestazioni dei modelli open-access.
Cos’è un tokenizer? È l’algoritmo che scompone il testo in unità più piccole, chiamate token. A seconda di come è progettato, questi token possono essere parole intere, parti di parola, singoli caratteri o altre unità. La tokenizzazione è un passaggio fondamentale per qualunque LLM, perché rende possibile attività come classificazione del testo, question answering e traduzione automatica.
I tokenizer sono una componente essenziale della pipeline NLP: trasformano il testo in una forma che il modello può comprendere. Poiché i modelli lavorano su dati numerici, convertono l’input testuale in sequenze di numeri.
L’approccio più semplice assegna un numero univoco a ogni lettera o simbolo. Per esempio, “a” può diventare 1, “b” può diventare 2, e così via. Il modello prova poi a prevedere il numero successivo nella sequenza. Il problema è che anche una frase breve diventa una lunga catena di numeri, e un singolo errore su un carattere può compromettere tutto ciò che segue.
Un’altra strategia assegna invece un numero a ogni parola intera. La sequenza si accorcia molto, ma nascono altri problemi: con oltre 200.000 parole solo in inglese, un modello multilingue dovrebbe distinguere fra milioni di elementi, con un forte aumento della probabilità di errore.
Per superare questi limiti, la ricerca ha sviluppato la tokenizzazione. Le parole vengono spezzate in segmenti più piccoli e ricorrenti. Per esempio, “predicting” può diventare “pred”, “ict” e “ing”. In questo modo il modello non deve più scegliere fra un intero dizionario, ma fra un insieme molto più ristretto di token.
Qui emerge però il vero problema: quasi tutti i noti chat LLM open-access, da Llama e Llama-2 a Mistral, Mixtral, Falcon e Smaug, usano tokenizer pensati soprattutto per lingue romanze e germaniche. Per lingue come greco, cinese, ebraico, arabo, hindi, coreano o giapponese, la rappresentazione degrada spesso fino al livello del singolo carattere.
Le prestazioni di un modello possono migliorare con più dati o dati migliori. Il tokenizer no: è un componente deterministico, non un sistema che si addestra. Non lo si può migliorare con fine-tuning, né sostituire senza rompere il modello.
In passato sono esistiti modelli con tokenizer davvero validi sul piano multilingue, come mt5 di Google nel 2020. Il limite è che si trattava di modelli base, non ottimizzati specificamente per la conversazione.
Di fatto, questo limite ha ristretto l’uso pratico degli LLM soprattutto alle lingue romanze e germaniche. Per costruire un LLM conversazionale davvero valido, fino a ieri c’erano solo due strade:
- Fare fine-tuning di modelli moderni come Llama-2 o Mistral in modo quasi “anni 2015”, cioè con rappresentazioni del testo vicine al livello del carattere.
- Partire da un modello base con un tokenizer solido e trasformarlo in un modello conversazionale.
Entrambe le opzioni richiedevano dataset molto ampi e di qualità elevata. Per la maggior parte delle lingue e delle aziende, il fine-tuning di moderni LLM conversazionali multilingui era quindi, di fatto, fuori portata.
Fino a oggi.
Gemma
Gemma rappresenta una nuova generazione di modelli open leggeri ma molto avanzati, costruiti sulla ricerca e sulla tecnologia sviluppate per Gemini. È stato sviluppato da Google DeepMind insieme ad altri team Google, e il nome richiama il latino “gemma”, cioè “pietra preziosa”.
Ecco i punti chiave:
- Google ha rilasciato i pesi di Gemma in due varianti principali: Gemma 2B e Gemma 7B. Entrambe sono disponibili sia come modelli pre-addestrati sia come versioni instruction-tuned.
- Il nuovo Responsible Generative AI Toolkit mette a disposizione linee guida e strumenti pratici per costruire applicazioni AI più sicure con Gemma.
- Google supporta pipeline per inferenza e supervised fine-tuning in tutti i framework principali, inclusi JAX, PyTorch e TensorFlow, con supporto nativo in Keras 3.0.
- Per partire rapidamente, Google ha reso disponibili notebook pronti all’uso su Colab e Kaggle, oltre alle integrazioni con Hugging Face, MaxText, NVIDIA NeMo e TensorRT-LLM.
- I modelli Gemma, sia pre-trained sia instruction-tuned, girano bene su piattaforme diverse, dal laptop fino a Google Cloud, con opzioni di deploy su Vertex AI e Google Kubernetes Engine.
- Le condizioni d’uso consentono un utilizzo commerciale responsabile e la distribuzione da parte di organizzazioni di qualunque dimensione.
In passato avevamo già evidenziato mt5, l’LLM di Google del 2020 noto per il suo tokenizer multilingue. Con Gemma, Google alza ancora il livello. Nella nostra analisi più recente abbiamo confrontato i tokenizer dei principali LLM su più lingue: questo è il posizionamento di Gemma.
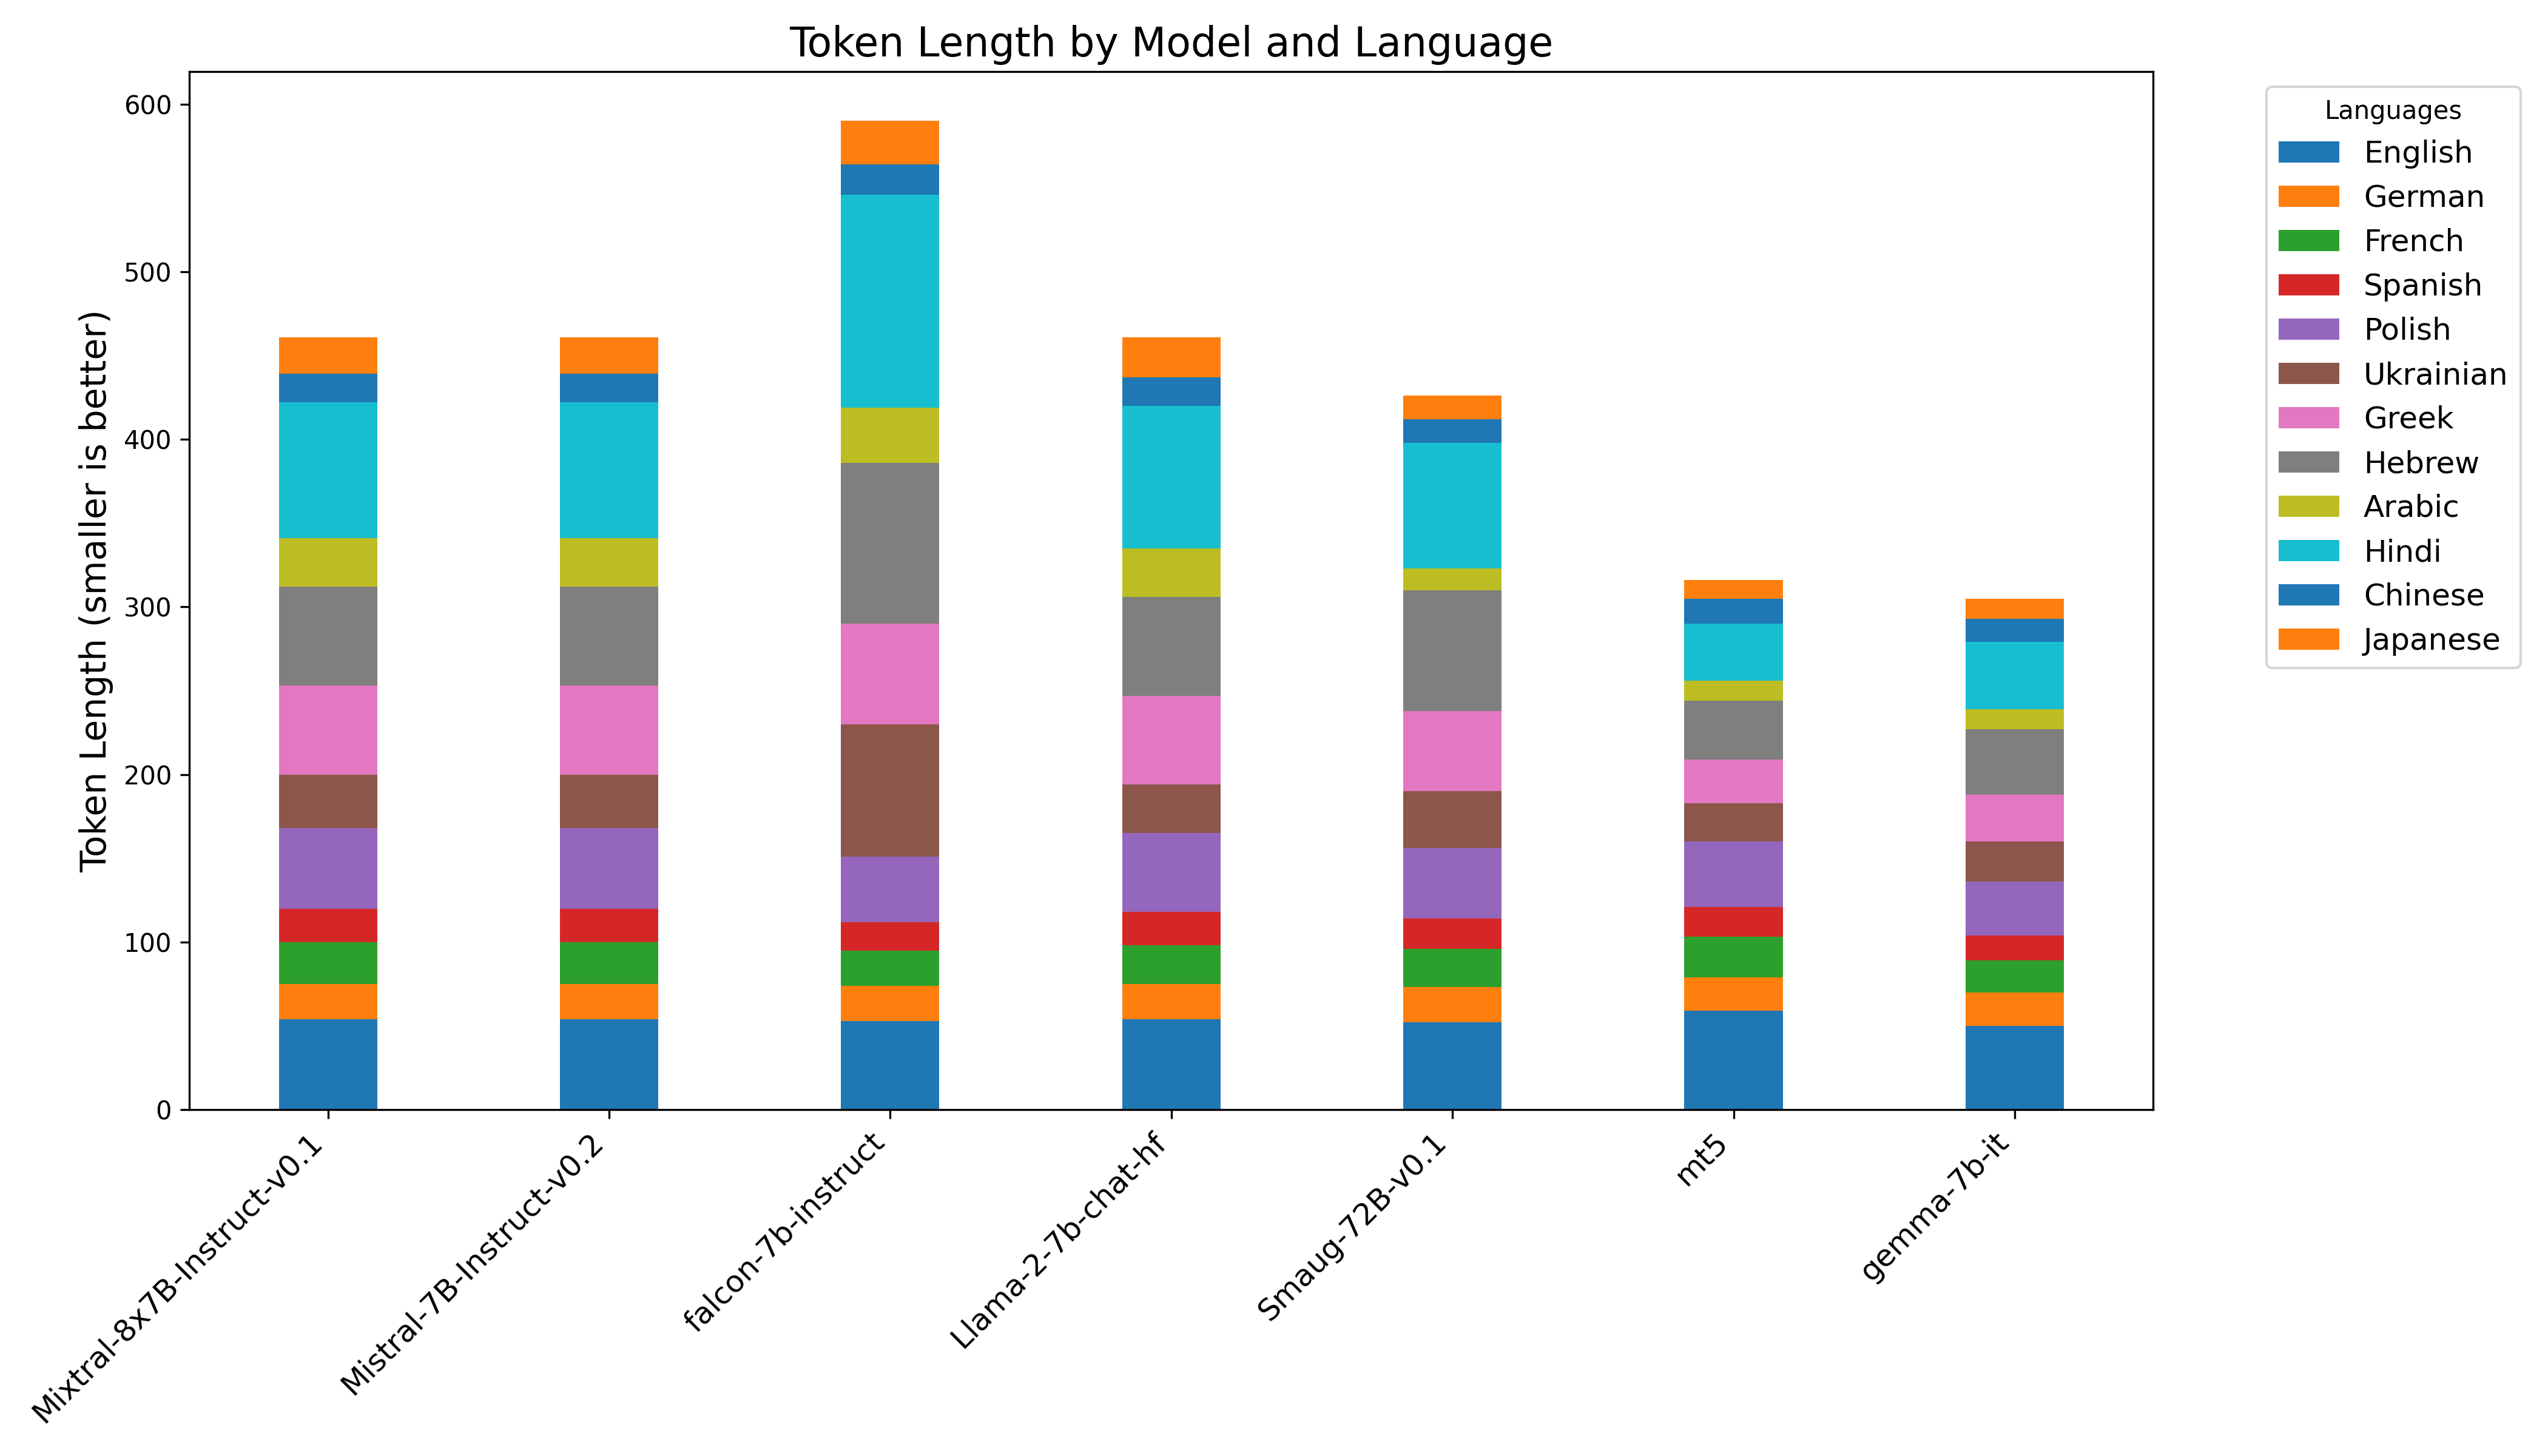
Ecco invece un confronto diretto tra le prestazioni di tokenizzazione di Gemma e Llama-2:
| Lingua | Llama-2 Tokens | Gemma Tokens | Miglioramento |
|---|---|---|---|
| English | 54 | 50 | 7% |
| German | 21 | 20 | 5% |
| French | 23 | 19 | 17% |
| Spanish | 20 | 15 | 25% |
| Polish | 47 | 32 | 32% |
| Ukrainian | 29 | 24 | 17% |
| Greek | 53 | 28 | 47% |
| Hebrew | 59 | 39 | 34% |
| Arabic | 29 | 12 | 59% |
| Hindi | 85 | 40 | 53% |
| Chinese | 17 | 14 | 18% |
| Japanese | 24 | 12 | 50% |
A prima vista Gemma può sembrare solo l’ennesimo LLM open rilasciato sul mercato. Sarebbe però un errore leggerlo così. Per il mondo degli LLM, questa uscita è molto rilevante: permette finalmente alle aziende di fare fine-tuning di modelli open-access per casi d’uso come traduttori conversazionali, assistenti di scrittura multilingui e sistemi RAG in più lingue. In pratica colma un vuoto importante, finora spesso sottovalutato, e segna l’arrivo del primo vero chat LLM realmente multilingue.
Costruire un LLM personalizzato può migliorare sicurezza, compliance e vantaggio competitivo del prodotto. Negli articoli collegati approfondiamo:
- Che cos’è l’effetto rete
- Come l’AI abilita l’effetto rete
- Come costruire un vantaggio competitivo basato sull’AI
- Quale cultura aiuta a costruire i giusti prodotti AI
- Cosa evitare nella strategia AI
State costruendo un prodotto AI multilingue?
Scegliere il modello e il tokenizer giusti è decisivo. Troviamo insieme la base migliore per la vostra soluzione AI multilingue.