
Llama 3.1 con Unsloth: el doble de rápido
Ajustar modelos de lenguajes grandes (LLM) en conjuntos de datos educativos o pequeños puede ser sencillo, pero cuando se trata de aplicaciones comerciales con largas secuencias de entrada o grandes resultados, el desafío crece exponencialmente. Incluso con técnicas avanzadas como QLoRA, es posible que aún alcances los límites de una GPU de 80 GB (como la H100 o la A100) con solo un ejemplo de entrenamiento. Además, el ajuste fino con datos de entrada extensos puede resultar frustrantemente lento.
Afortunadamente, existe una solución que puede ahorrar tiempo y recursos: Unsloth. En este artículo explicamos qué es, cómo instalarlo y cómo usarlo en plataformas cloud con GPU como Vast AI, MassedCompute y RunPod, además de compartir buenas prácticas que van más allá de la documentación oficial.
¿Qué es Unsloth?
Unsloth es una biblioteca gratuita de código abierto con licencia Apache 2.0, diseñada para un ajuste eficiente de LLM. Es 2,2 veces más rápido que la biblioteca estándar Huggingface Transformers, utiliza un 70% menos de memoria GPU y mantiene la precisión con ajustes finos QLoRA (4 bits) y LoRA (16 bits). Además, duplica la velocidad de inferencia.
Si esto suena demasiado bueno para ser verdad, tenga la seguridad: el campo del ajuste de LLM aún es joven y está en evolución, lo que a menudo resulta en ineficiencias. Unsloth aborda estas ineficiencias, mejorando el uso de la memoria y el rendimiento del entrenamiento.
La base de código de la librería está bien estructurada y es fácil de seguir, por lo que resulta sencillo entender cómo optimiza el modelo. En esencia, Unsloth elimina cálculos innecesarios y unifica tipos de datos para lograr estas mejoras de rendimiento.
Hemos utilizado ampliamente Unsloth en nuestros proyectos y esta publicación refleja nuestras experiencias hasta agosto de 2024. Como Unsloth está evolucionando rápidamente, le recomendamos consultar la documentación oficial para obtener las últimas actualizaciones si va a leer esto más adelante.
Instalación de Unsloth
Comenzar a usar Unsloth puede ser un poco complicado, especialmente durante la instalación. El proceso no es tan sencillo como cabría esperar y la forma más confiable de configurarlo es mediante un entorno Conda.
En esta guía mostraremos la instalación sobre una máquina virtual H100 de MassedCompute. Estos pasos también sirven para instancias con GPU basadas en Docker en plataformas como Vast AI y RunPod.
1. Cree la máquina virtual
Primero, dirígete a MassedCompute y crea una nueva VM. En este ejemplo, utilizamos una instancia puntual H100 para aprovechar precios más bajos. Sin embargo, tenga en cuenta que las instancias puntuales se pueden cancelar con solo una hora de aviso, así que planifique en consecuencia si elige esta opción.
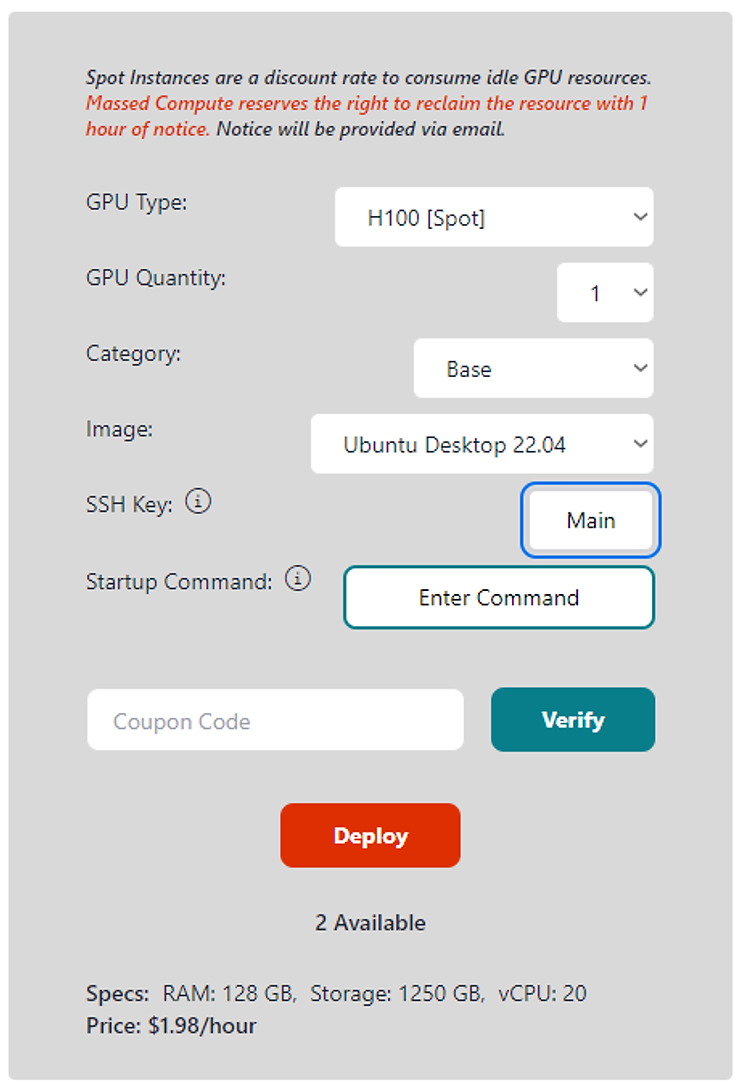
Seleccione el tipo de instancia "Base" y la imagen del sistema operativo "Ubuntu Desktop 22.04", luego haga clic en "Implementar".
2. Paquetes de actualización
A continuación, actualice los paquetes básicos, instale la CLI de Huggingface y autentíquese con su token de Huggingface.
sudo apt update
sudo apt upgrade -y
sudo apt install python3-pip -y
python3 -m pip install --upgrade pip
pip3 install packaging huggingface_hub[cli]
export PATH=$PATH:~/.local/bin
huggingface-cli login --token hf_<YOUR HUGGINGFACE TOKEN>
3. Instalar Conda
mkdir -p /home/Ubuntu/miniconda3
wget https://repo.anaconda.com/miniconda/Miniconda3-latest-Linux-x86_64.sh -O ~/miniconda3/miniconda.sh
bash /home/Ubuntu/miniconda3/miniconda.sh -b -u -p ~/miniconda3
rm -rf /home/Ubuntu/miniconda3/miniconda.sh
/home/Ubuntu/miniconda3/bin/conda init bash
. /home/Ubuntu/.bashrc
4. Cree un entorno Conda Unsloth
conda create --name unsloth_env python=3.10
conda activate unsloth_env
conda install pytorch==2.2.0 cudatoolkit torchvision torchaudio pytorch-cuda=12.1 -c pytorch -c nvidia
conda install xformers -c xformers
pip install bitsandbytes matplotlib datasets transformers trl peft accelerate sentencepiece
pip install --upgrade --force-reinstall --no-cache-dir git+https://github.com/unslothai/unsloth.git
Si está utilizando Weights & Biases, instálelo también:
pip3 install wandb
wandb login
<YOUR WEIGHTS & BIASES TOKEN>
5. Instale e inicie Jupyter Notebook
sudo apt-get install nano -y
pip3 install jupyter
jupyter notebook --generate-config
Edite la configuración de Jupyter para configurar la dirección IP y el puerto:
nano ~/.jupyter/jupyter_notebook_config.pyAgregue las siguientes líneas después de "c = get_config()":
# Set the IP address to '*'
c.NotebookApp.ip = '0.0.0.0'

# Set the port to 10000
c.NotebookApp.port = 10000

# Disable browser opening
c.NotebookApp.open_browser = False
Establezca su contraseña de Jupyter Notebook e inícielo:
jupyter notebook password
jupyter notebook --allow-root
Abra su navegador y vaya a http://<VM_IP_ADDRESS>:10000
Entrenamiento del modelo
Para la capacitación, usaremos el cuaderno de capacitación Llama 3.1 8B del repositorio oficial de Unsloth en GitHub.
1. Eliminar la instalación del paquete PIP
Como ya hemos configurado un entorno Conda de Unsloth completamente funcional, el primer paso consiste en eliminar del notebook los comandos de instalación de paquetes con pip.
2. Ajustar la estructura de mensajes para Llama 3.1
El cuaderno original de Unsloth utiliza el conjunto de datos de Alpaca y su estructura de indicaciones correspondiente con fines de demostración. Para lograr los mejores resultados con el modelo Llama 3.1 ajustado, es fundamental utilizar la estructura de indicaciones exacta con la que se entrenó el modelo.
El modelo meta-llama/Meta-Llama-3.1-8B-Instruct tiene la siguiente estructura de indicaciones:
| Token | Descripción |
|---|---|
| <|begin_of_text|> | Especifica el inicio del mensaje. |
| <|end_of_text|> | El modelo dejará de generar más tokens. |
| <|start_header_id|> <|end_header_id|> | Adjunte el rol para un mensaje en particular (sistema, usuario, asistente, ipython) |
| <|eom_id|> | Fin del mensaje: indica que es necesario realizar una llamada a la herramienta |
| <|eot_id|> | Fin del turno: indica que el modelo ha terminado de generar una respuesta. |
| <|python_tag|> | Etiqueta especial utilizada en la respuesta del modelo para indicar una llamada de herramienta |
Tenga en cuenta que no a\u00F1adimos el token <|begin_of_text|> a la estructura del prompt porque el tokenizador lo incorpora autom\u00E1ticamente.
3. Entrenar solo sobre la completion
Durante la formación de LLM, existe un problema potencial conocido como "sobreajuste de la entrada". Esto ocurre porque los LLM modernos, al ser modelos solo decodificadores, aprenden la probabilidad de cada token en función de todos los tokens anteriores, incluidos los de la entrada del modelo. Como resultado, si la misma entrada aparece varias veces en el conjunto de entrenamiento, el modelo puede aprender que la entrada sigue una estructura específica.
Para mitigar este problema, la librería Transformers permite entrenar el modelo solo sobre la completion (la respuesta generada por la IA). En este modo, el modelo sigue procesando entrada y salida, pero el entrenamiento solo actualiza los pesos a partir de la salida, evitando el sobreajuste sobre la entrada.
Para habilitar este modo, importe DataCollatorForCompletionOnlyLM y configúrelo con el patrón de texto que identifica la parte de respuesta:
from trl import SFTTrainer, DataCollatorForCompletionOnlyLM

response_template = "<|start_header_id|>assistant<|end_header_id|>"
collator = DataCollatorForCompletionOnlyLM(response_template, tokenizer=tokenizer)
El entrenamiento se completa en 1 min 39 seg. Requiere 14,5 GB de memoria GPU.
4. Inferencia
Aunque la secuencia de Fibonacci es una tarea sencilla, sirve como prueba básica del funcionamiento del modelo. Es importante recordar que el conjunto de datos Alpaca probablemente ya formaba parte del entrenamiento original de Llama 3.1. Sin embargo, cuando utiliza su propio conjunto de datos propietario, el proceso de entrenamiento puede mejorar de forma significativa el rendimiento del modelo y permitirle abordar tareas más complejas y especializadas.
Puede consultar el código completo de este tutorial en nuestro Colab.
Limitaciones
Si bien Unsloth ofrece una solución poderosa para muchos desafíos, la versión gratuita tiene sus limitaciones.
- La versión gratuita sólo es compatible con los modelos modificados por Unsloth. Aunque el equipo de Unsloth trabaja diligentemente para respaldar los modelos más populares y avanzados, es posible que los modelos más especializados o de nicho aún no se beneficien de las optimizaciones de Unsloth.
- Unsloth no admite el entrenamiento con múltiples GPU. Si alcanza el límite de memoria de la GPU, incluso con el entrenamiento de eficiencia de memoria de Unsloth, es posible que deba explorar opciones alternativas, ya que no hay forma de distribuir la carga entre varias GPU.
- Unsloth tambi\u00E9n ofrece compatibilidad nativa con el escalado RoPE (codificaci\u00F3n posicional rotativa), que permite ampliar la ventana de contexto m\u00E1s all\u00E1 de su tama\u00F1o original. Sin embargo, por ahora solo unos pocos modelos admiten el escalado RoPE con Unsloth.
Conclusión
Desarrollar su LLM personalizado podría mejorar la seguridad y el cumplimiento de los datos y permitir una ventaja competitiva de IA para su producto. Consulte nuestras otras publicaciones para obtener más información:
- Adaptación de bajo rango (LoRA) para un ajuste eficiente de modelos de lenguaje grandes
- ¿Por qué necesita una estrategia de IA? La IA como ventaja competitiva
- Estrategias de IA que ofrecen una ventaja competitiva sostenible
- Comience con la cultura de desarrollo de IA adecuada
¿Busca un ajuste rápido y rentable de su LLM?
Evaluaremos el mejor marco de ajuste para su caso de uso y crearemos un modelo personalizado que le brinde una ventaja competitiva.