
Llama 3.3 más rápido con Hugging Face TGI
El ecosistema de modelos de lenguajes grandes (LLM) de acceso abierto continúa creciendo rápidamente. En julio de 2024, Meta presentó Llama 3.1, un impresionante modelo de 405 mil millones de parámetros que superó los límites del rendimiento de LLM. Sólo cinco meses después, en diciembre de 2024, Meta lanzó Llama 3.3, una versión compacta con sólo 70 mil millones de parámetros.
A pesar de ser casi seis veces más pequeño, Llama 3.3 iguala el rendimiento de su predecesor más grande. Incluso supera al GPT-4o en varias tareas, siendo hasta 50 veces más barato y 10 veces más rápido que el modelo de OpenAI.
Lo que hace que Llama 3.3 sea realmente emocionante es su capacidad de ajuste. Puede entrenarlo con sus propios datos para hacerlo aún más efectivo para sus necesidades específicas.
Este blog se centra en crear una ventaja competitiva con la IA. Si desea asegurarse de que sus competidores no puedan replicar fácilmente su producto, debe entrenar sus propios modelos de IA. Llama 3.3 es una excelente opción para aplicaciones que involucran texto o conversaciones.
Pero una vez que su modelo está afinado, surge el siguiente desafío: ¿cómo implementarlo? ¿Cómo puede garantizar que su LLM ofrezca un alto rendimiento, se integre con herramientas estándar y funcione de forma segura dentro de su organización?
Inferencia de generación de texto de Huggingface
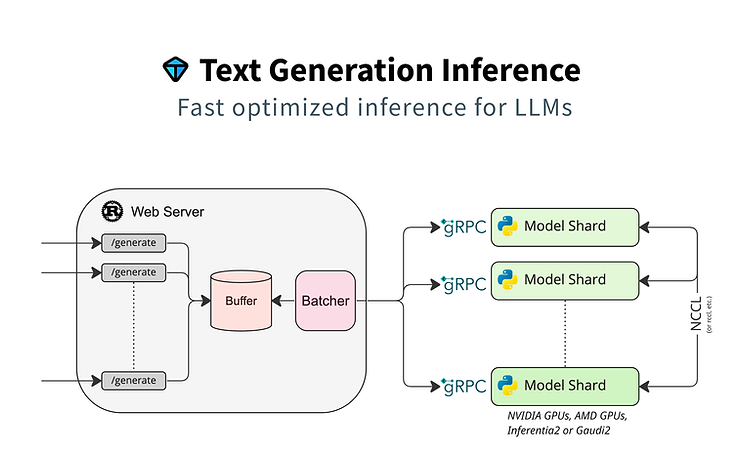
El ecosistema Huggingface ofrece mucho más que simples repositorios de modelos y conjuntos de datos. Con Text Generation Inference (TGI), puede implementar su LLM optimizado para una inferencia rápida, eficiente y segura.
TGI está optimizado para uso empresarial, lo que le permite:
- Implemente modelos con un lanzador simple.
- Logre un rendimiento de nivel de producción con funciones como el seguimiento distribuido (OpenTelemetry) y métricas de Prometheus.
- Utilice el paralelismo tensorial para una inferencia más rápida en varias GPU.
- Transmita tokens en tiempo real con eventos enviados por el servidor (SSE).
- Aplique cuantificación con herramientas como bitsandbytes y GPT-Q para optimizar el rendimiento.
TGI también potencia HuggingChat, un chatbot de IA gratuito en el que puede probar modelos como Llama 3.3.
TGI está escrito en Rust, lo que lo hace altamente optimizado para tareas de inferencia. Admite conectores listos para usar para herramientas como LangChain, lo que garantiza una integración perfecta con bibliotecas estándar. Ya sea que busque velocidad, escalabilidad o simplicidad, TGI se lo ofrece.
En este blog, demostraremos la inferencia de Llama 3.3 usando Transformers estándar, luego la implementaremos con TGI y compararemos su velocidad de generación.
Implementación con Hyperstack
Para esta demostración, usaremos Hyperstack, un proveedor de GPU en la nube que ofrece GPU NVIDIA H100 a una tarifa competitiva de 1,90 dólares por hora.
Paso 1: seleccione su GPU
Para ejecutar Llama 3.3 de forma eficaz, necesitamos al menos dos GPU NVIDIA H100 con 80 GB de memoria GPU cada una. Si bien es técnicamente posible ejecutar Llama 3.3 en una sola GPU H100, los pesos del modelo deberían dividirse entre la GPU y la CPU. Esta configuración aumenta drásticamente los tiempos de respuesta, superando a menudo los 10 minutos por solicitud, lo que no resulta práctico para la mayoría de las aplicaciones.
Paso 2: elige el sistema operativo
A continuación, seleccione un sistema operativo que incluya Docker. Docker es esencial para ejecutar TGI sin problemas.
Paso 3: habilite el acceso remoto
Al configurar su máquina virtual (VM), habilite tanto el acceso SSH para una administración segura de la línea de comandos como una dirección IP pública para permitir conexiones remotas durante el experimento.
Paso 4: implemente su máquina virtual
Una vez completada la configuración, haga clic en Implementar. En cuestión de segundos, su VM estará lista para usar. Para habilitar el acceso remoto para Jupyter Notebook, configure una regla de ingreso para el puerto deseado. En esta demostración, usaremos el puerto 10000.
Llama 3.3 Inferencia con Transformers
Para comenzar, probaremos la velocidad de inferencia de Llama 3.3 usando la biblioteca estándar de Transformers. Más adelante, implementaremos el mismo modelo con TGI para comparar el rendimiento.
Paso 1: Cargue el modelo Llama 3.3
Hyperstack proporciona 750 GB de almacenamiento efímero por GPU, lo que nos da 1,5 TB de almacenamiento total con dos GPU H100. Tenga en cuenta que Llama 3.3 es un modelo cerrado. Deberá solicitar acceso en Huggingface o directamente con Meta.
pip3 install packaging huggingface_hub[cli]
huggingface-cli login --token <YOUR_HUGGINGFACE_TOKEN>
A continuación, cargue el modelo:
from transformers import AutoTokenizer, AutoModelForCausalLM
import torch

model_name = 'meta-llama/Llama-3.3-70B-Instruct'

tokenizer = AutoTokenizer.from_pretrained(
    model_name, trust_remote_code=True, cache_dir="/ephemeral/"
)

model = AutoModelForCausalLM.from_pretrained(
    model_name, trust_remote_code=True, torch_dtype=torch.bfloat16,
    device_map="auto", cache_dir="/ephemeral/"
)
Paso 2: cargar el conjunto de datos
Para esta demostración, usaremos el conjunto de datos de Alpaca:
from datasets import load_dataset

train_set = load_dataset("yahma/alpaca-cleaned", split="train")
Con la biblioteca Transformers, necesitarás formatear la entrada de acuerdo con la estructura de indicaciones de Llama:
def create_prompt_formats(sample):
    result = f"""<|start_header_id|>system<|end_header_id|>

You are a helpful assistant.<|eot_id|><|start_header_id|>user<|end_header_id|>

{sample['instruction']}<|eot_id|><|start_header_id|>assistant<|end_header_id|>
"""
    sample["prompt"] = result
    return sample

train_set_processed = train_set.map(create_prompt_formats)
terminators = [tokenizer.eos_token_id]Paso 3: medir la velocidad de inferencia
Para probar la velocidad de inferencia, ejecutaremos el modelo en las primeras 10 entradas del conjunto de datos de Alpaca:
import time
from statistics import mean

transformers_processing_time = []

for i in range(10):
    start_time = time.time()
    data_point = train_set_processed[i]
    inputs = tokenizer(data_point['prompt'], return_tensors="pt",
                       add_special_tokens=False).to('cuda')
    outputs = model.generate(
        input_ids=inputs['input_ids'],
        attention_mask=inputs['attention_mask'],
        max_new_tokens=30000,
        pad_token_id=18610,
        eos_token_id=terminators
    )
    processing_time = time.time() - start_time
    transformers_processing_time.append(processing_time)

print(mean(transformers_processing_time))
# Output: ~30.37 seconds
En promedio, se necesitan unos 30 segundos por ejemplo para utilizar este enfoque.
Paso 4: Prueba con Transformers Pipeline
La canalización de Transformers simplifica el procesamiento por lotes. A ver si mejora el rendimiento:
from transformers import pipeline

pipe = pipeline("text-generation", model=model, tokenizer=tokenizer)

generation_args = {
    "max_new_tokens": 30000,
    "return_full_text": True,
    "temperature": 0.0,
    "do_sample": False,
}

transformers_pipeline_processing_time = []

for i in range(10):
    start_time = time.time()
    data_point = train_set_processed[i]
    output = pipe(data_point['prompt'], **generation_args)
    processing_time = time.time() - start_time
    transformers_pipeline_processing_time.append(processing_time)

print(mean(transformers_pipeline_processing_time))
# Output: ~28.31 seconds
El uso de la canalización reduce ligeramente el tiempo de procesamiento promedio, pero aún así demora entre 28 y 30 segundos por ejemplo.
Llama 3.3 Inferencia con TGI
Ahora, probemos Llama 3.3 con TGI. Antes de comenzar, asegúrese de que sus núcleos de Python estén detenidos y que la memoria de su GPU esté completamente vacía.
Paso 1: ejecutar el contenedor TGI Docker
model=meta-llama/Llama-3.3-70B-Instruct
volume=/ephemeral/data

docker run --gpus all --shm-size=1g \
  -e HUGGING_FACE_HUB_TOKEN=<YOUR_HUGGINGFACE_TOKEN> \
  -v $volume:/data \
  -d -p 8080:80 \
  ghcr.io/huggingface/text-generation-inference:3.0.1 \
  --model-id $model --num-shard 2
Cuando ejecuta este comando, Docker extraerá el contenedor TGI, descargará los pesos de Llama 3.3 e iniciará los fragmentos necesarios. Una vez que el modelo esté operativo, verá el siguiente mensaje de registro:
INFO text_generation_router::server: router/src/server.rs:2402: ConnectedPaso 2: Conéctese a TGI
from langchain.prompts import SystemMessagePromptTemplate, \
    HumanMessagePromptTemplate, ChatPromptTemplate
from langchain_huggingface import HuggingFaceEndpoint
from langchain_experimental.chat_models.llm_wrapper import ChatWrapper
import time
from statistics import mean
Paso 3: configurar indicaciones
class Llama3Chat(ChatWrapper):
    @property
    def _llm_type(self) -> str:
        return "meta-llama/Llama-3.3-70B-Instruct"
    sys_beg: str = "<|begin_of_text|><|start_header_id|>system<|end_header_id|>\n\n"
    sys_end: str = "<|eot_id|>"
    ai_n_beg: str = ""
    ai_n_end: str = "<|eot_id|>"
    usr_n_beg: str = "<|start_header_id|>user<|end_header_id|>\n\n"
    usr_n_end: str = "<|eot_id|><|start_header_id|>assistant<|end_header_id|>\n\n"
    usr_0_beg: str = "<|start_header_id|>user<|end_header_id|>\n\n"
    usr_0_end: str = "<|eot_id|><|start_header_id|>assistant<|end_header_id|>\n\n"
def get_response():
system_template = "You are a helpful assistant."
user_template = "{message}"
messages = [
SystemMessagePromptTemplate.from_template(system_template),
HumanMessagePromptTemplate.from_template(user_template)
]
return ChatPromptTemplate(messages=messages)Paso 4: conecte LangChain a TGI
llm = Llama3Chat(
    llm=HuggingFaceEndpoint(
        endpoint_url="http://127.0.0.1:8080",
        task="text-generation",
        max_new_tokens=10000,
        huggingfacehub_api_token="<YOUR_HUGGINGFACE_TOKEN>"
    )
)
Paso 5: Probar la velocidad de inferencia
tgi_processing_time = []

for i in range(10):
    start_time = time.time()
    data_point = train_set[i]
    response = llm.invoke({'message': data_point['instruction']}).strip()
    processing_time = time.time() - start_time
    tgi_processing_time.append(processing_time)

print(mean(tgi_processing_time))
# Output: ~14.21 seconds
En promedio, TGI procesa cada entrada en 14,2 segundos\u2014más del doble de rápido que el 28\u201330 segundos tomó con la biblioteca Transformers.
TGI proporciona un aumento significativo del rendimiento, reduciendo los tiempos de inferencia a más de la mitad. Más allá de Llama 3.3, TGI admite modelos como Mistral, Mixtral, Gemma, Qwen, Falcon, y más, todo con la misma impresionante eficiencia. Con TGI, puede implementar modelos potentes en su propia infraestructura, garantizando que ningún dato salga de su perímetro de seguridad.
Ser propietario de su LLM personalizado podría mejorar la seguridad y el cumplimiento de los datos y permitir una ventaja competitiva de IA para su producto. Consulta nuestras otras publicaciones:
- Qué es el efecto de red y cómo lo permite la IA
- Cómo construir una ventaja competitiva de la IA
- ¿Qué cultura le ayuda a crear los productos de IA adecuados?
- Qué evitar en su estrategia y ejecución de IA
¿Listo para implementar LLM en su propia infraestructura?
Desde la selección del modelo hasta la optimización de la inferencia, creemos un canal de implementación de IA seguro y eficaz para su producto.