
Fine-tuning de Llama 3.1 con SWIFT: multi-GPU
Unsloth ha ganado popularidad como biblioteca para ajustar modelos de lenguajes grandes (LLM). Reduce significativamente tanto el uso de la memoria de la GPU como el tiempo de entrenamiento. Cubrimos Unsloth en detalle en nuestra publicación de blog anterior, "Cómo ajustar Llama 3.1 con Unsloth".
Sin embargo, Unsloth tiene sus limitaciones. El más notable es que actualmente solo admite el entrenamiento con una sola GPU.
Entonces, ¿qué puede hacer si el entrenamiento con una sola GPU no basta para su proyecto, ya sea por velocidad o por capacidad? En este artículo presentamos SWIFT, una alternativa sólida a Unsloth que permite entrenar Llama 3.1 de forma eficiente con múltiples GPU.
¿Qué es SWIFT?
SWIFT es una biblioteca avanzada desarrollada por ModelScope para entrenar modelos de lenguaje de gran tamaño (LLM). Cubre todo el ciclo de trabajo: preentrenamiento, ajuste fino, aprendizaje por refuerzo a partir de feedback humano (RLHF), inferencia, evaluación y despliegue. Con SWIFT puede trabajar con más de 300 LLM y más de 50 modelos multimodales de gran tamaño.
SWIFT va más allá de las capacidades de formación básicas al admitir soluciones ligeras como el ajuste fino de parámetros eficientes (PEFT). También incluye una biblioteca completa de adaptadores que presenta las últimas técnicas como NEFTune, LoRA+ y LLaMA-PRO.
Para que la plataforma sea accesible incluso para quienes se inician en el aprendizaje profundo, SWIFT ofrece una interfaz web fácil de usar basada en Gradio. En este artículo explicamos cómo ajustar Llama 3.1 con SWIFT sobre infraestructura de RunPod.
Configurar el entorno RunPod
Inicie sesión en la consola RunPod, navegue hasta "Pods" y haga clic en "Implementar". Para esta demostración, utilizaremos Community Cloud. Sin embargo, si tiene requisitos de seguridad estrictos, considere la opción Secure Cloud de RunPod.
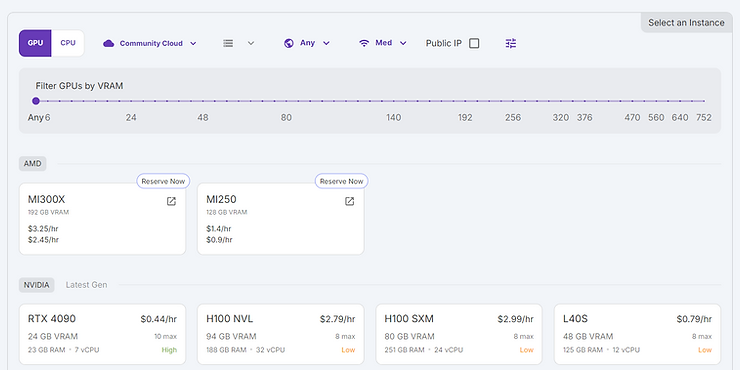
Para nuestro ejemplo, usaremos una instancia de múltiples GPU. Seleccionaremos 2 GPU RTX A6000, ya que cada A6000 ofrece 48 GB de memoria GPU, suficiente para la mayoría de los LLM más pequeños.
Usaremos la imagen RunPod PyTorch 2.4.0, que es la última versión en el momento de escribir este artículo. Para optimizar costos, utilizaremos instancias Spot.
Cuando trabaje con GPU, necesitará almacenamiento adicional. RunPod ofrece dos tipos de almacenamiento:
- Container Disk: Almacenamiento temporal que se borra cada vez que se detiene el contenedor.
- Volume Disk: Almacenamiento persistente que retiene los datos incluso si se reinicia el contenedor o se finaliza una instancia de Spot. Montado en /workspace de forma predeterminada.
Instalación de SWIFT
Si bien la documentación oficial de SWIFT sugiere una instalación sencilla utilizando el paquete PyPI, si lo ejecuta a partir de septiembre de 2024, encontrará el siguiente error:
Failed to import swift.trainers.trainers because of the following error:
Failed to import modelscope.msdatasets because of the following error:
cannot import name 'ftp_head' from 'datasets.utils.file_utils'
Para solucionarlo, instale SWIFT ejecutando:
pip install --upgrade --force-reinstall --no-cache-dir \
  git+https://github.com/modelscope/ms-swift.git@88dab2b6625280e813bd8835662e1d2be24a3132
Entrenando Llama 3.1 con SWIFT
Cree un nuevo Jupyter Notebook y pruebe su instalación:
from swift import Trainer, TrainingArgumentsLuego realice las importaciones necesarias:
from swift import Trainer, TrainingArguments
from modelscope import MsDataset, AutoTokenizer
from modelscope import AutoModelForCausalLM
from modelscope import snapshot_download
from swift import Swift, LoraConfig, get_peft_model
from swift.llm import get_template, TemplateType, register_template, Template, TEMPLATE_MAPPING
import torch
import wandb
from datasets import load_dataset
from transformers import BitsAndBytesConfig
from trl import SFTTrainer, DataCollatorForCompletionOnlyLM
A diferencia de otros marcos, SWIFT está diseñado para funcionar con modelos alojados en ModelScope, y no en Hugging Face:
model_name = 'LLM-Research/Meta-Llama-3.1-8B-Instruct'
model = AutoModelForCausalLM.from_pretrained(
    model_name, torch_dtype=torch.bfloat16,
    device_map='auto', trust_remote_code=True
)
tokenizer = AutoTokenizer.from_pretrained(model_name, trust_remote_code=True)
tokenizer.pad_token_id = 12488
train_set = load_dataset("yahma/alpaca-cleaned", split="train")Ejemplos de capacitación en procesamiento para una duración constante
SWIFT ofrece una variedad de plantillas de indicaciones de LLM prediseñadas. Sin embargo, el procesamiento de conjuntos de datos basado en plantillas no tiene parámetros de truncamiento y relleno predeterminados. Cuando se utilizan varios ejemplos de entrenamiento por GPU, todos los ejemplos deben tener la misma longitud.
def create_prompt_formats(sample, test=False):
    result = f"""<|start_header_id|>system<|end_header_id|>

You are a helpful assistant.<|eot_id|><|start_header_id|>user<|end_header_id|>

{sample['instruction']}<|eot_id|><|start_header_id|>assistant<|end_header_id|>

"""
    if not test:
        result += f"""{sample['output']}<|eot_id|>"""
    sample["prompt"] = result
    return sample
def preprocess_batch(batch, tokenizer, max_length, truncation, padding):
return tokenizer(
batch['prompt'],
max_length=max_length,
truncation=truncation,
padding='max_length' if padding else False
)def preprocess_dataset(tokenizer, max_length, seed, dataset, truncation, padding, test):
print("Preprocessing dataset...")
_create_prompt_formats = partial(create_prompt_formats, test=test)
dataset = dataset.map(_create_prompt_formats)
_preprocessing_function = partial(
preprocess_batch, max_length=max_length,
tokenizer=tokenizer, truncation=truncation, padding=padding
)
dataset = dataset.map(_preprocessing_function, batched=True)
dataset = dataset.shuffle(seed=seed)
return datasetPara encontrar la longitud máxima adecuada, procesamos el conjunto de datos sin truncamiento ni relleno:
exploration_set = preprocess_dataset(
    tokenizer=tokenizer, max_length=128000, seed=seed,
    dataset=train_set, truncation=False, padding=False, test=False
)

lengths = [len(entry['input_ids']) for entry in exploration_set]
plt.hist(lengths, bins=30, color='blue', edgecolor='black')
plt.title('Histogram of Lengths of input_ids')
plt.xlabel('Length of input_ids')
plt.ylabel('Frequency')
plt.show()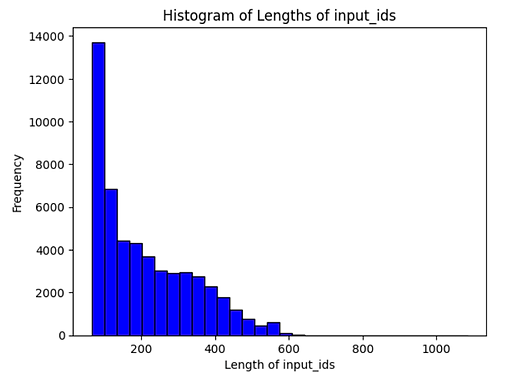
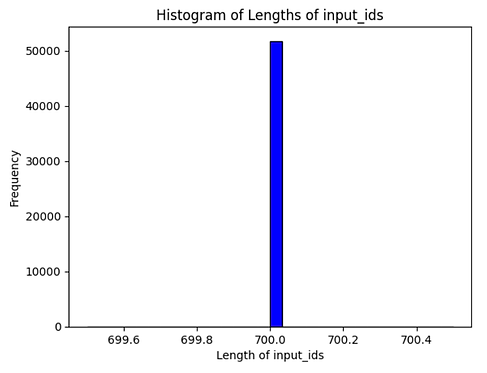
Como se muestra en el histograma, la mayoría de los ejemplos en el conjunto de datos de Alpaca, después de la conversión al formato de solicitud de Llama 3.1, tienen menos de 700 tokens. Establecimos la longitud máxima en 700 tokens:
train_set_processed = preprocess_dataset(
    tokenizer=tokenizer, max_length=max_length, seed=seed,
    dataset=train_set, truncation=True, padding=True, test=False
)
Configurar los parámetros de LoRA
lora_config = LoraConfig(
    r=4,
    target_modules=["q_proj", "k_proj", "v_proj", "o_proj",
                     "gate_proj", "up_proj", "down_proj"],
    lora_alpha=8,
    lora_dropout=0.05
)

model = Swift.prepare_model(model, lora_config)
Configurar el recopilador de datos
response_template = "<|start_header_id|>assistant<|end_header_id|>"
collator = DataCollatorForCompletionOnlyLM(response_template, tokenizer=tokenizer)
Definición de la configuración de entrenamiento
train_args = TrainingArguments(
    output_dir='output',
    learning_rate=1e-4,
    num_train_epochs=2,
    eval_steps=500,
    save_steps=500,
    optim="adamw_8bit",
    fp16=True,
    evaluation_strategy='steps',
    save_strategy='steps',
    log_level="debug",
    dataloader_num_workers=16,
    per_device_train_batch_size=1,
    gradient_accumulation_steps=16,
    logging_steps=1,
)
Inicialice el entrenador y comience a entrenar
trainer = Trainer(
    model=model,
    args=train_args,
    train_dataset=train_set_processed,
    tokenizer=tokenizer,
    data_collator=collator
)

trainer.train()
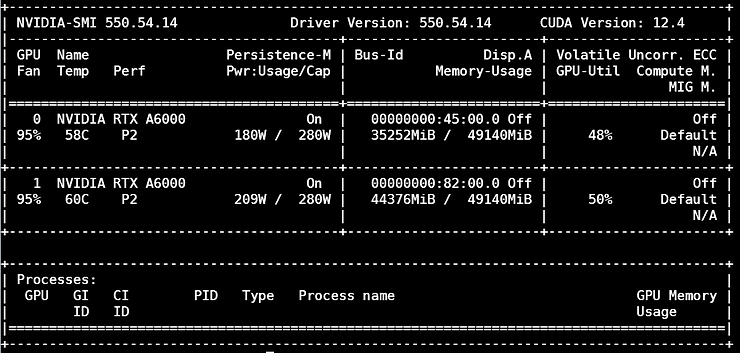
Mientras se ejecuta la capacitación, es útil monitorear la utilización de la GPU con el comando nvidia-smi:
Puede consultar el código completo de este tutorial en nuestro Colab.
Conclusión
Desarrollar su LLM personalizado podría mejorar la seguridad y el cumplimiento de los datos y permitir una ventaja competitiva de IA para su producto. Consulte nuestras publicaciones relacionadas:
- Cómo ajustar Llama 3.1 con Unsloth
- Adaptación de bajo rango (LoRA) para un ajuste eficiente
- ¿Por qué necesita una estrategia de IA?
- Estrategias de IA que ofrecen una ventaja competitiva sostenible
¿Necesita un ajuste de múltiples GPU para su proyecto LLM?
Diseñemos la infraestructura de capacitación adecuada y la estrategia de ajuste para su modelo de lenguaje personalizado.